Silver RL·Lecture 6·Reading Companion
Lecture 6 · Value Function Approximation — 한국어 동반 읽기
Slides: David Silver, UCL Course on Reinforcement Learning (2015), CC BY-NC 4.0. Some slide content is from third parties and is outside that licence.
같이 열 것: Lecture 6 · Value Function Approximation (본 노트) · David Silver - RL Course (UCL 2015) · 이전 Lecture 5 · Model-Free Control
Lecture 6 · Value Function Approximation는 "슬라이드가 말하지 않는 것만" 담는 규칙으로 쓰였다. 그래서 밀도가 높고, 슬라이드를 이미 이해한 상태를 전제한다.
이 파일은 그 전제를 채운다 — 슬라이드가 실제로 뭐라고 했는지 + 그걸 왜 그렇게 읽어야 하는지를 한국어로 푼다. 본 노트를 대체하지 않고, 본 노트를 읽을 수 있게 만드는 계단이다.
볼트 규칙상 강의노트 본문은 영어지만, 이 문서는 "쉽게"가 목적이라 한국어로 쓴다. technical term은 전부 영어 원어 유지 — 나중에 논문 읽을 때 그대로 쓰는 단어들이라 번역하면 손해다.
목차
- §0 · L6가 하는 일, 한 문장
- §1 · 왜 근사하는가 (slides p.4–9)
- 배경지식 체크 — 애매하면 물어볼 것
- §2 · Oracle이라는 가정 (slides p.11–15)
- §3 · Oracle 걷어내기 — Prediction (slides p.16–20)
- §4 · Control (slides p.21–27)
- §5 · 깨지는 지점 (slides p.28–32)
- §6 · Batch Methods (slides p.34–37)
- §7 · DQN (slides p.38–41)
- §8 · 닫힌 형태 최소제곱 (slides p.42–55)
- 다 읽고 남는 지도
§0 · L6가 하는 일, 한 문장
L1~L5는 한 가지를 명시하지 않은 채 전제하고 있었다 — lookup table.
state 하나당 칸 하나, 또는 state-action pair 하나당 칸 하나. 를 "업데이트한다"는 건 결국 표의 한 칸에 숫자를 덮어쓰는 것이었다.
L6는 그 표를 지우고 parameterized function으로 바꾼다. 그리고 딱 하나만 묻는다:
그래도 다 그대로 되나?
답은 명확히 갈리고, 그 갈림이 강의 전체의 목차가 된다. 본 노트 맨 앞의 표가 그 요약이다.
| Table lookup (L1–L5) | Function approximation (L6) | |
|---|---|---|
| 표현 | , — 칸 하나씩 | , — 하나의 를 전부가 공유 |
| 업데이트 | 칸 하나 덮어쓰기 | 를 gradient 방향으로 이동 |
| 다른 state에 미치는 영향 | 없음 | generalization — 이게 요점 |
| MC prediction | 수렴 | 수렴 (non-linear에서도) |
| TD prediction | 수렴 | on-policy이고 linear일 때만 수렴 |
| Control | 수렴 | chatter하거나, 발산 |
핵심만 남기면: 새로운 학습 원리는 오늘 하나도 나오지 않는다. MC도 TD도 TD(λ)도 전부 L4~L5에서 이미 배운 것 그대로다. 바뀌는 것은 표현(representation) 하나뿐이고, 강의의 나머지는 전부 "표현을 바꾸면 무엇이 성립하지 않게 되는가"를 조사하는 과정이다.
§1 · 왜 근사하는가 (slides p.4–9)
p.4–5 — Large-Scale RL
슬라이드의 내용 (이게 전부다):
- Backgammon: states
- Computer Go: states
- Helicopter: continuous state space
- "지난 두 강의의 model-free prediction·control을 어떻게 scale up 할까?"
표가 불가능한 이유: 개의 칸이 필요하다. 관측 가능한 우주의 원자 수가 약 이다. 저장할 방법이 물리적으로 없다.
본 노트가 지적하는 것 — 이쪽이 §1의 실제 내용이다
본 노트는 이 숫자 논증을 **"둘 중 약한 쪽"**이라고 부른다. 처음 읽으면 이유가 잘 보이지 않는데, 뜻은 이렇다.
메모리가 무한하다고 가정해도 표는 여전히 작동하지 않는다. 표의 칸을 채우려면 그 state를 실제로 방문해야 하기 때문이다.
표는 칸끼리 아무 관계가 없으므로, 를 백만 번 방문해도 1mm 옆의 에 대해서는 아무것도 알게 되지 않는다. 헬리콥터처럼 state space가 continuous하면 같은 state를 두 번 방문할 확률이 0이다. 표는 끝내 채워지지 않는다.
Approximation은 메모리 문제이기 전에 data efficiency 문제다.
표를 쓸 수 없는 이유는 "너무 크다"보다 "경험이 옆 칸으로 전달되지 않는다"가 더 근본적이다.
이 관점이 중요한 이유는 뒤에서 회수되기 때문이다. 강의 후반에 "table lookup은 linear function approximation의 특수한 경우"라는 내용이 나오는데 (본 노트 p.15), 그때 "표가 generalize하지 못하는 이유"가 정확히 이것으로 설명된다. 지금 짚어두면 그 대목에서 따로 설명이 필요 없다.
p.6 — Value Function Approximation
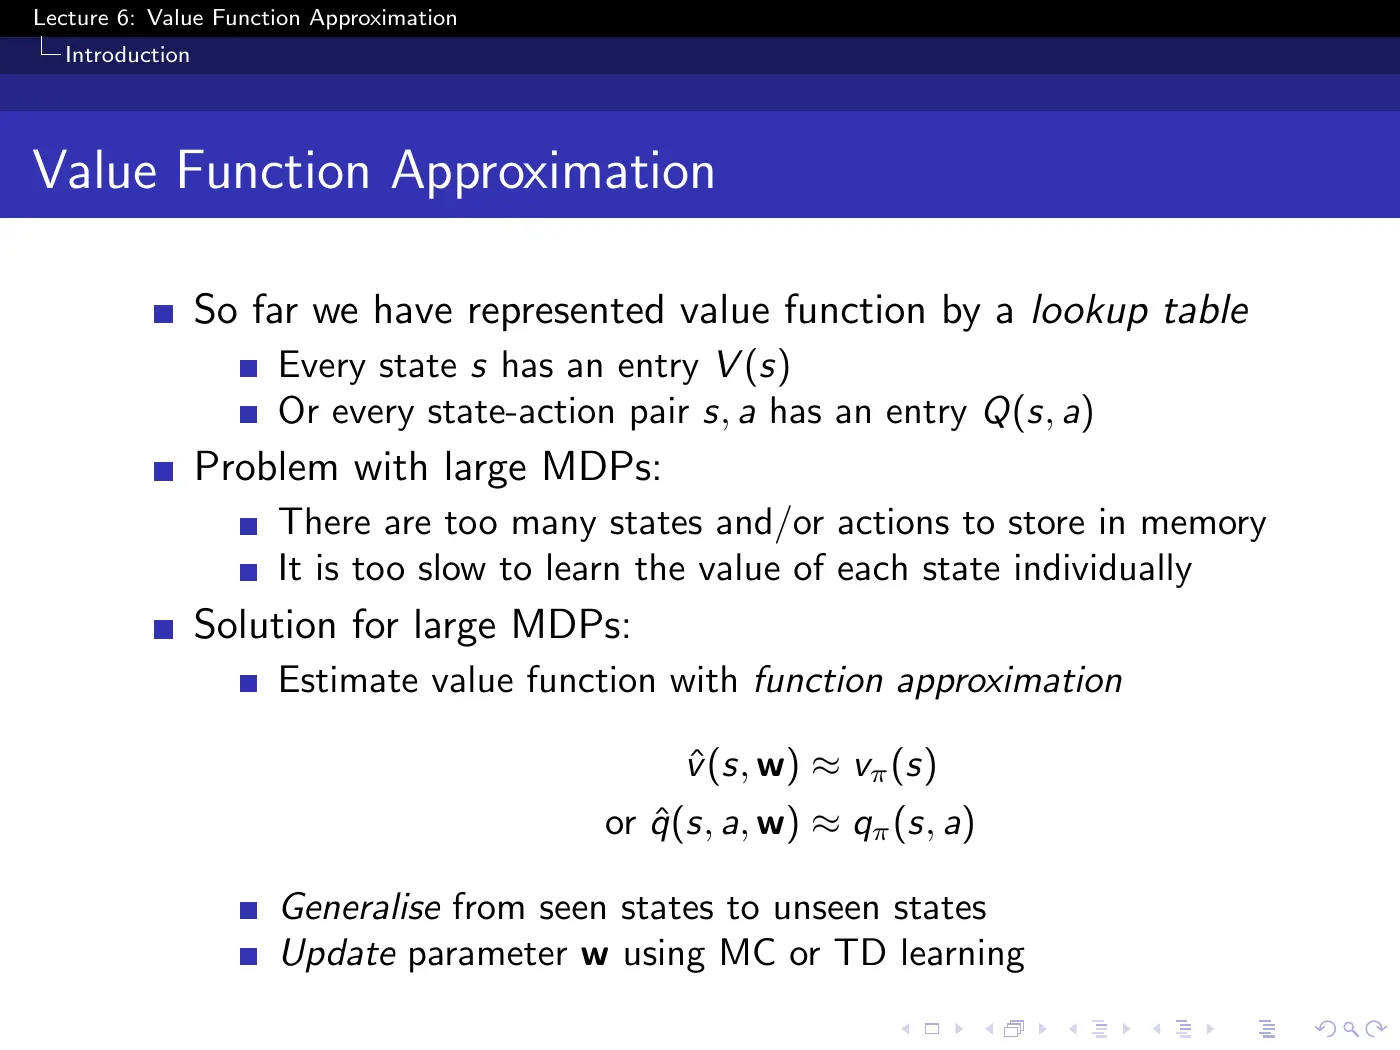
강의 전체에서 가장 중요한 슬라이드다. 식은 하나뿐이다.
기호 읽는 법 — 여기서 막히지 않으면 남은 50장이 훨씬 수월하다:
| 기호 | 읽기 |
|---|---|
| policy 를 따를 때 state 의 참값(true value). 우리가 모르는 것 | |
| hat = 추정치. 우리가 만든 근사 함수 | |
| parameter vector . bold는 vector라는 뜻. 어떤 함수인지를 정하는 값이지 state를 조정하는 값이 아니다 | |
| 와 를 받아 스칼라 하나를 돌려주는 함수 |
는 state를 조정하는 것이 아니라 함수 그 자체다. 표기가 오해를 만든다 — 로 쓰면 둘이 대등한 입력처럼 보이지만 전혀 대등하지 않다. 원래 의미는 , 즉 **"로 정해진 함수를 에서 평가한다"**이다.
직선 와 같은 구조다. 가 입력이고 가 파라미터다. 로 쓸 수도 있지만 그렇게 쓰지 않는 이유는, 는 어떤 직선인지를 정하고 는 그 직선 위 어디를 볼지를 정하기 때문이다. "가 를 조정한다"고 하지 않는 것과 같다.
→ 아래 $\mathbf{w}$가 함수라는 것 — 숫자로 확인 (2026-09-02)
가 함수라는 것 — 숫자로 확인
feature 두 개짜리 예시. 자동차 state를 (위치, 속도)로 두고 이라 하자.
거의 같은 두 state를 잡는다.
일 때 두 값은 다음과 같다.
이제 만 방문해서 값을 높여야 한다고 배웠다고 하자. 을 로 올린다.
는 방문한 적이 없는데 함께 올라갔다. 와 을 공유하기 때문이다.
이것이 generalization이다. 가 state를 조정해서가 아니라, 하나를 모든 state가 함께 쓰기 때문에 하나를 건드리면 전부 따라 움직인다.
표와 비교하면 차이가 분명해진다. 표에서는 와 가 서로 다른 칸이므로, 를 아무리 업데이트해도 는 정확히 0만큼 움직인다. 공유하는 것이 없기 때문이다. 이 사실은 p.15에서 one-hot feature로 다시 확인된다.
Go의 state 개수는 이고 의 차원은 기껏해야 수천이다. 는 state 하나당 숫자 하나를 가질 수 없다. 물리적으로 불가능하다.
따라서 는 state의 목록이 아니라 state를 받아 값을 계산하는 규칙이다. 안에는 특정 state에 대한 정보가 들어 있지 않고, 계산하는 방법만 들어 있다.
DQN이 가장 명확한 예다. 는 신경망의 모든 weight이고 는 화면 4프레임이다. 학습하면 신경망이 바뀌고, 그러면 모든 화면에 대한 출력이 함께 바뀐다.
와 의 비대칭을 정리하면 이렇다.
| 언제 바뀌나 | 매 step | 학습할 때만, 천천히 |
| 범위 | 지금 이 순간 하나 | 모든 state가 공유 |
| 역할 | 질문 | 답을 계산하는 기계 |
표와의 차이는 한 가지뿐이다.
표에서는 state마다 자기 칸을 독점했다. 여기서는 모든 state가 같은 하나를 공유한다.
공유의 효과는 양방향이다. 유리한 쪽은 에서 배운 것이 의 값에도 반영된다는 것이고(= generalization), 불리한 쪽은 의도하지 않은 경우에도 의 값이 함께 바뀐다는 것이다. 강의 후반의 발산 문제는 전부 후자에서 나온다.
슬라이드가 나란히 놓은 두 가지 이득 — 본 노트는 둘의 급이 다르다고 말한다:
- Memory — . 파라미터 수가 state 수보다 훨씬 적다
- Generalization — 가본 적 없는 state에서도 함수를 호출할 수 있다
중요한 쪽은 2번이다. 1번만으로는 의미가 없다는 노트의 논증은 이렇다. "방문한 칸만 읽을 수 있는 압축된 표"는 결국 표다. 압축률이 아무리 좋아도 값을 알려면 여전히 그 state를 방문해야 하므로, §1의 실제 문제가 하나도 해결되지 않는다.
슬라이드 마지막 불릿이 강의 후반부 전체를 요약한다 — "Update parameter using MC or TD learning." 새 학습 원리는 없고 새 표현만 있다는 뜻이다.
p.7 — Types of Value Function Approximation
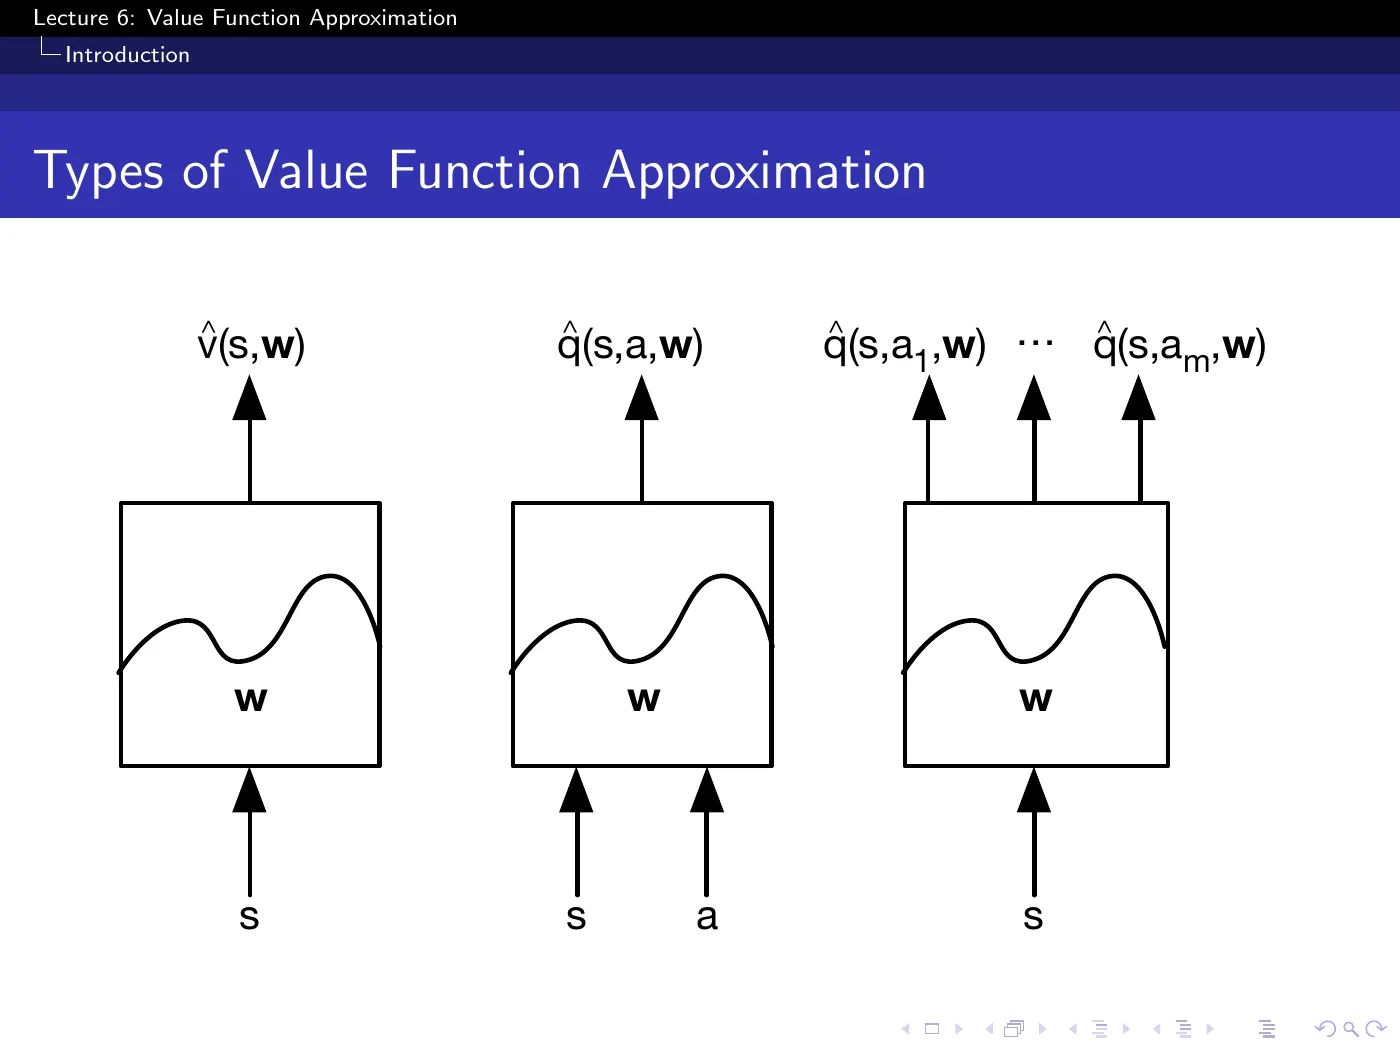
그림 세 개가 나오는데, 슬라이드에는 설명이 한 줄도 없다. 왼쪽부터:
- → — state value 하나
- → — action-in. state와 action을 둘 다 넣고 스칼라 하나를 받는다
- → — action-out. state만 넣고 모든 action의 값을 한 번에 받는다
2번과 3번은 같은 정보를 담는다. 다만 비용이 다르고, 그 차이가 뒤에서 중요해진다.
| 입력 | 출력 | 비용 | |
|---|---|---|---|
| Action-in | 스칼라 하나 | action 개수만큼 forward pass | |
| Action-out | 길이 의 vector | forward pass 한 번 |
control은 greedy action을 골라야 하므로 매 step마다 가 필요하다. 그래서 action-out이 훨씬 저렴하고, DQN이 이 방식을 쓴다 — Atari 조이스틱 18개 값을 forward pass 한 번으로 출력한다 (본 노트 p.39).
출력층 유닛이 action 하나당 하나이므로, action set이 **유한하고 고정되고 이산적(finite, fixed, discrete)**이어야 한다.
Action-in은 그 제약이 없어서 continuous action space로도 확장된다 — 대신 가 lookup이 아니라 그 자체로 optimization problem이 된다.
이 한계는 Mountain Car에서 다시 나오고 (본 노트 p.25), L7이 policy-based method로 넘어가는 이유 중 하나다. 로봇 제어는 토크가 continuous하므로 직접 해당되는 문제다.
p.8–9 — Which Function Approximator?
후보 나열: linear combinations of features, neural network, decision tree, nearest neighbour, Fourier/wavelet bases, …
그리고 조건 두 개를 건다. 이 둘은 성격이 완전히 다르다.
조건 1 — differentiable. 미분 가능해야 gradient를 쓸 수 있고, gradient를 써야 값싼 incremental update가 가능하다. 이것은 편의를 위한 조건에 가깝다. 좋은 도구를 쓰기 위한 전제일 뿐이다.
조건 2 — non-stationary, non-i.i.d. 데이터에 맞는 학습법일 것. 이게 RL 고유의 제약이고, 강의 후반부 전체의 논지다. 두 단어를 풀면:
non-stationary = 목표가 움직인다.
- control에서: 가 계속 좋아지니까 자체가 모양이 바뀐다. 어제 맞춘 답이 오늘은 틀린 답이다
- prediction에서도 마찬가지다: TD target 는 **지금 업데이트하고 있는 바로 그 **로 계산된다. target을 계산하는 파라미터와 지금 업데이트하는 파라미터가 같은 라는 뜻이다
non-i.i.d. = 데이터가 궤적(trajectory)으로 온다.
- i.i.d. = independent and identically distributed. supervised learning이 전제하는 가정으로, 데이터를 통에서 무작위로 하나씩 꺼낸다는 뜻이다
- RL은 그렇지 않다. 지금 프레임과 0.03초 뒤 프레임은 거의 같다. 현재 위치가 다음 위치를 강하게 결정한다
DQN의 트릭 두 개가 여기에 1:1로 대응한다 (본 노트 p.38):
- experience replay → non-i.i.d.에 대응한다 (버퍼에서 무작위로 추출해 상관관계를 없앤다)
- fixed Q-targets → non-stationarity에 대응한다 (target용 파라미터 를 수천 step 고정한다)
DQN은 새로운 발상처럼 보이지만, 실제로는 p.9에서 이미 예고된 두 문제에 각각 대응한 것이다. 이 구조를 알고 보면 DQN 슬라이드가 훨씬 단순해진다.
슬라이드의 오류 하나 (본 노트도 지적한다): p.9의 불릿 리스트는 p.8을 그대로 옮긴 것이다. "differentiable function approximator를 다룬다"고 해놓고 그 아래에 decision tree와 nearest neighbour가 그대로 남아 있는데, 둘 다 미분 불가능하다. 실제로 강의에서 다시 나오는 건 linear combination of features (canonical case)와 neural network (non-linear case) 둘뿐이다.
배경지식 체크 — 애매하면 물어볼 것
§2부터 수식 밀도가 올라간다. 아래 중 확실하지 않은 항목이 있으면 채팅에 그대로 붙여넣을 것. 여기서 해결하고 가는 편이 낫다.
수학 배경 쪽
- i.i.d.가 정확히 무엇이고, 왜 그 가정이 깨지면 학습이 어려워지는지
- 이랑 표기 읽는 법
- "gradient 방향으로 이동한다"가 기하적으로 무슨 뜻인지 — §2에서 바로 필요하다
- stationary / non-stationary 가 통계에서 원래 무슨 뜻인지
RL 쪽
- "TD target이 에 의존한다"가 왜 문제인지 — 지금 단계에서 와닿지 않는 것이 정상이다
- generalization이 왜 data efficiency와 같은 말인지
- 에 아래첨자가 붙는 이유 (L2~L4 복습)
- action-in / action-out 중 뭘 쓸지가 continuous control에서 왜 문제가 되는지
§2 · Oracle이라는 가정 (slides p.11–15)
L6에서 수식이 가장 많은 구간이다. 대신 여기만 이해하면 뒤쪽 3분의 2는 같은 내용의 반복이다.
먼저 — 강의 전체를 관통하는 전개 방식
본 노트가 "the method of the whole lecture"라고 부르는 것이다. 모든 유도가 2단계로 진행된다.
- 1단계 — 가정한다(pretend). 어떤 존재(oracle)가 참값 를 알려준다고 가정한다. 정답이 주어지므로 이 단계는 supervised learning과 같다
- 2단계 — 대체한다(substitute). oracle 자리에 RL이 실제로 구할 수 있는 값을 넣는다. return , TD target , 또는 -return
강의는 이 루프를 정확히 세 번 돈다.
| 1단계 (가정) | 2단계 (대체) | |
|---|---|---|
| prediction | p.12 | p.16 |
| control | p.22 | p.24 |
| least squares | p.42 | p.44 |
이 구조를 파악하면 슬라이드 56장 중 3분의 2가 같은 슬라이드로 보인다. 읽다가 앞에서 본 내용 같다고 느껴진다면 착각이 아니라 실제로 같은 내용이다.
p.11 — Gradient Descent (수학 배경 슬라이드)
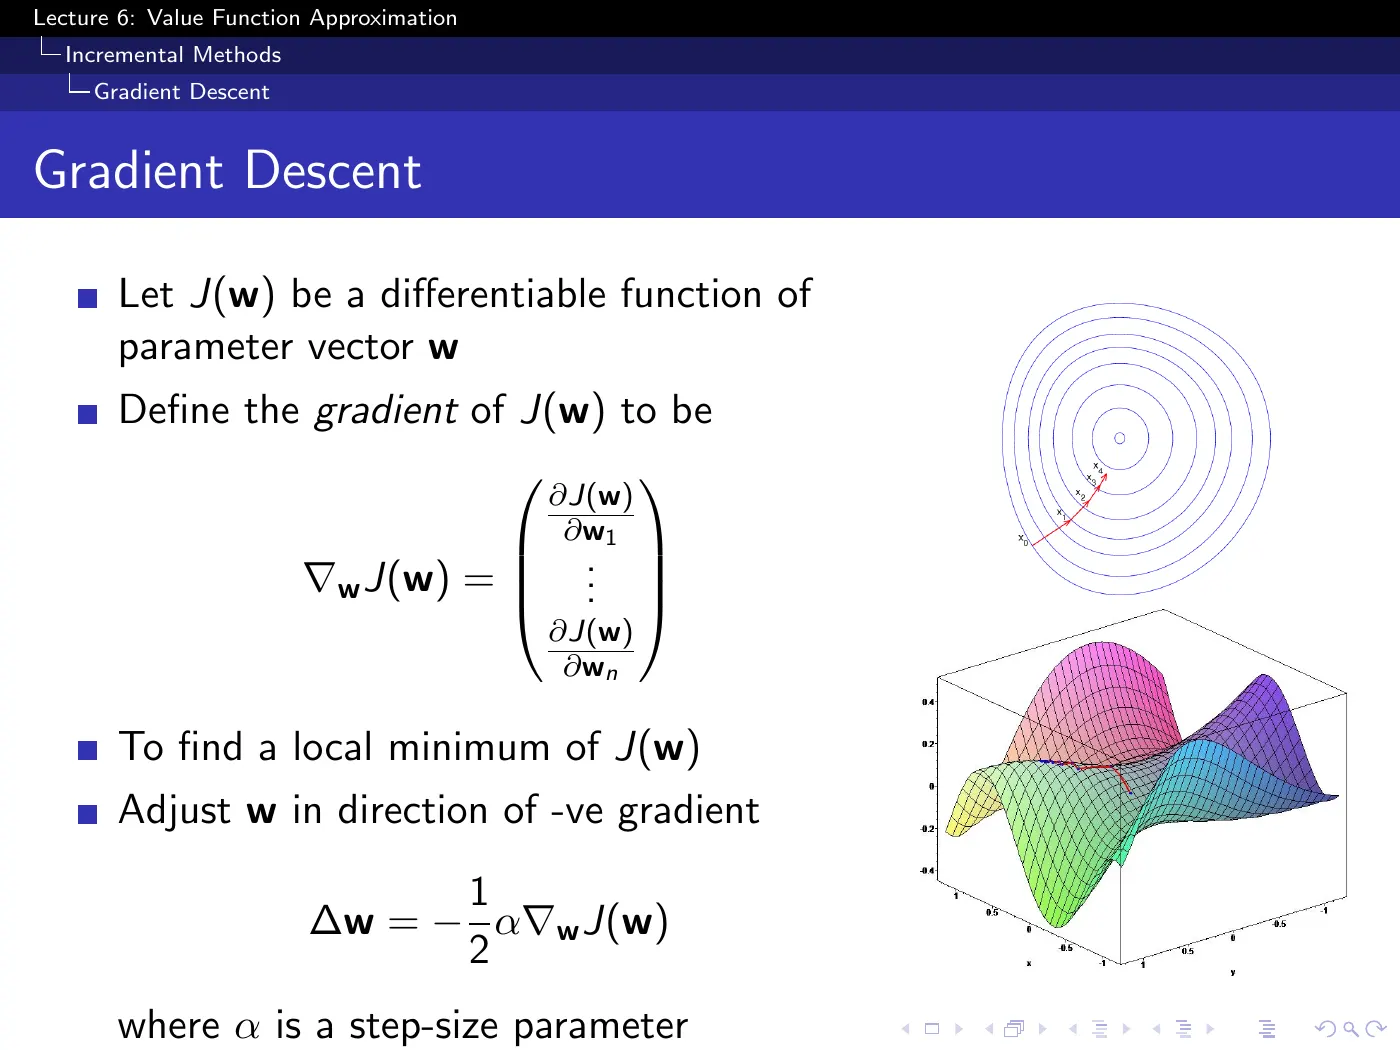
슬라이드가 정의하는 것: 가 parameter vector 의 미분 가능한 함수일 때, gradient는 편미분들을 세로로 쌓은 vector다.
기하적 의미 — 여기가 정리되지 않으면 §3 전체가 읽히지 않는다:
를 위에 놓인 **지형(landscape)**이라고 보자. 높이가 error이고, 낮을수록 좋다.
- 는 그 지점에서 가장 가파르게 올라가는 방향을 가리키는 화살표다
- 우리는 내려가고 싶으니 부호를 뒤집는다. 그래서
- 는 step size, 즉 한 번에 이동하는 크기다. 크면 빠르지만 최소점을 지나쳐 발산할 수 있고, 작으면 안정적이지만 느리다
각 성분 는 만 조금 바꿨을 때 error가 얼마나 변하는가를 나타낸다. 크게 변한다면 그 방향으로 크게 움직일 이유가 있다는 뜻이다.
제곱을 미분하면 계수 가 생기는데, 그것을 미리 상쇄하려고 붙인 숫자다. 여기서 의미를 찾을 필요는 없다.
p.12 — Value Function Approximation by SGD
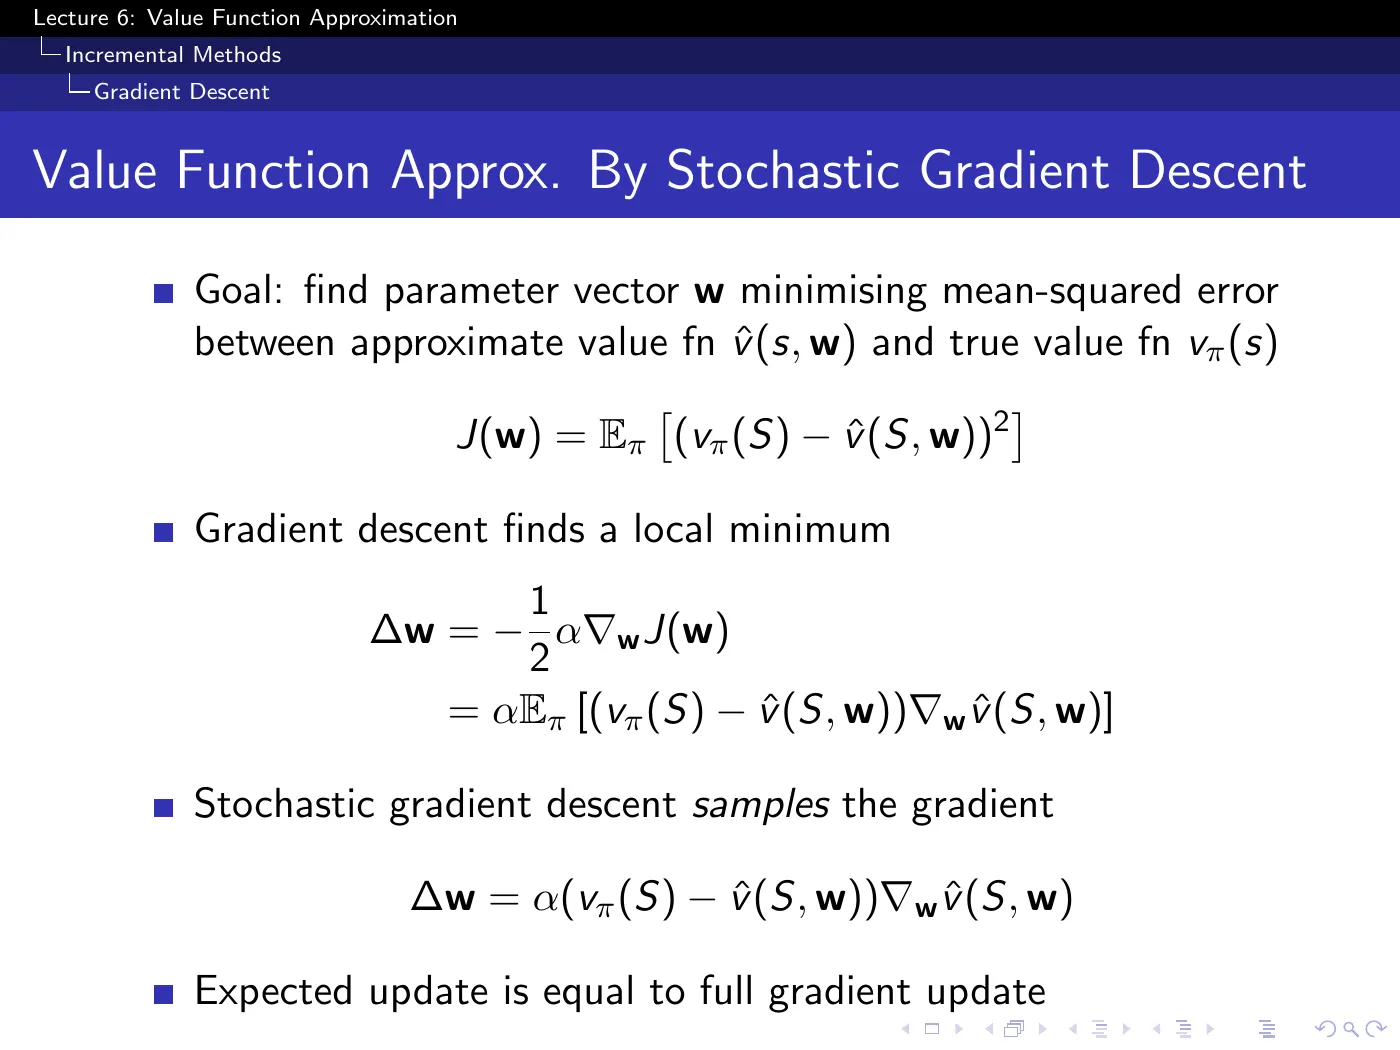
목표를 식으로: 근사값 와 참값 의 mean-squared error를 최소화하는 를 찾는다.
가 붙는 이유 — 놓치기 쉽지만 중요하다. state마다 error가 다르므로 어떤 state의 error를 더 중요하게 볼 것인가를 정해야 한다. 기준은 "를 따를 때 자주 방문하는 state를 더 중요하게"다. 거의 방문하지 않는 state를 정확히 맞춰도 의미가 없기 때문이다.
미분하면:
gradient가 어디에 붙는지 확인할 것. 는 oracle이 준 상수이므로 로 미분하면 0이다. 따라서 만 남는다.
지금 단계에서 "는 상수이므로 미분하면 사라진다"는 자명하다. oracle이 준 값이라 와 무관하기 때문이다.
그러나 2단계에서 oracle 자리에 TD target 를 넣으면 그 자리에 가 포함된다. 그 순간 "미분하면 사라진다"가 더 이상 성립하지 않는다. → p.18 — TD Learning with Value Function Approximation
L6의 발산 문제는 전부 여기서 시작된다. 이 지점을 기억해두면 §3·§5에서 따로 설명이 필요 없다.
SGD로 넘어가는 마지막 단계: 기댓값 는 계산할 수 없다. 모든 state를 훑어야 하는데, 그것이 애초에 피하려던 일이기 때문이다. 그래서 샘플 하나로 대체한다:
슬라이드 마지막 줄 — "Expected update is equal to full gradient update" — 이 문장이 online algorithm을 정당화한다. 샘플 하나짜리 업데이트를 평균 내면 실제 gradient와 같다는 뜻이다. 따라서 한 샘플씩 근사적으로 진행해도 장기적으로는 올바른 방향으로 수렴한다.
여기서 계산 하나가 저절로 해결된다. state distribution을 따로 구할 필요가 없다. 를 따라 이동하면 자주 가는 state를 자연히 자주 만나므로, 방문 자체가 의 가중평균 역할을 한다.
를 supervisor가 준다고 가정하는데, RL에는 supervisor가 없다. 그것이 RL의 정의다. 슬라이드도 첫 불릿에서 그 사실을 인정한다.
따라서 p.12에서 유도한 내용은 전부 잠정적이며, 이 가정은 p.16에서 해소된다.
p.13 — Feature Vectors
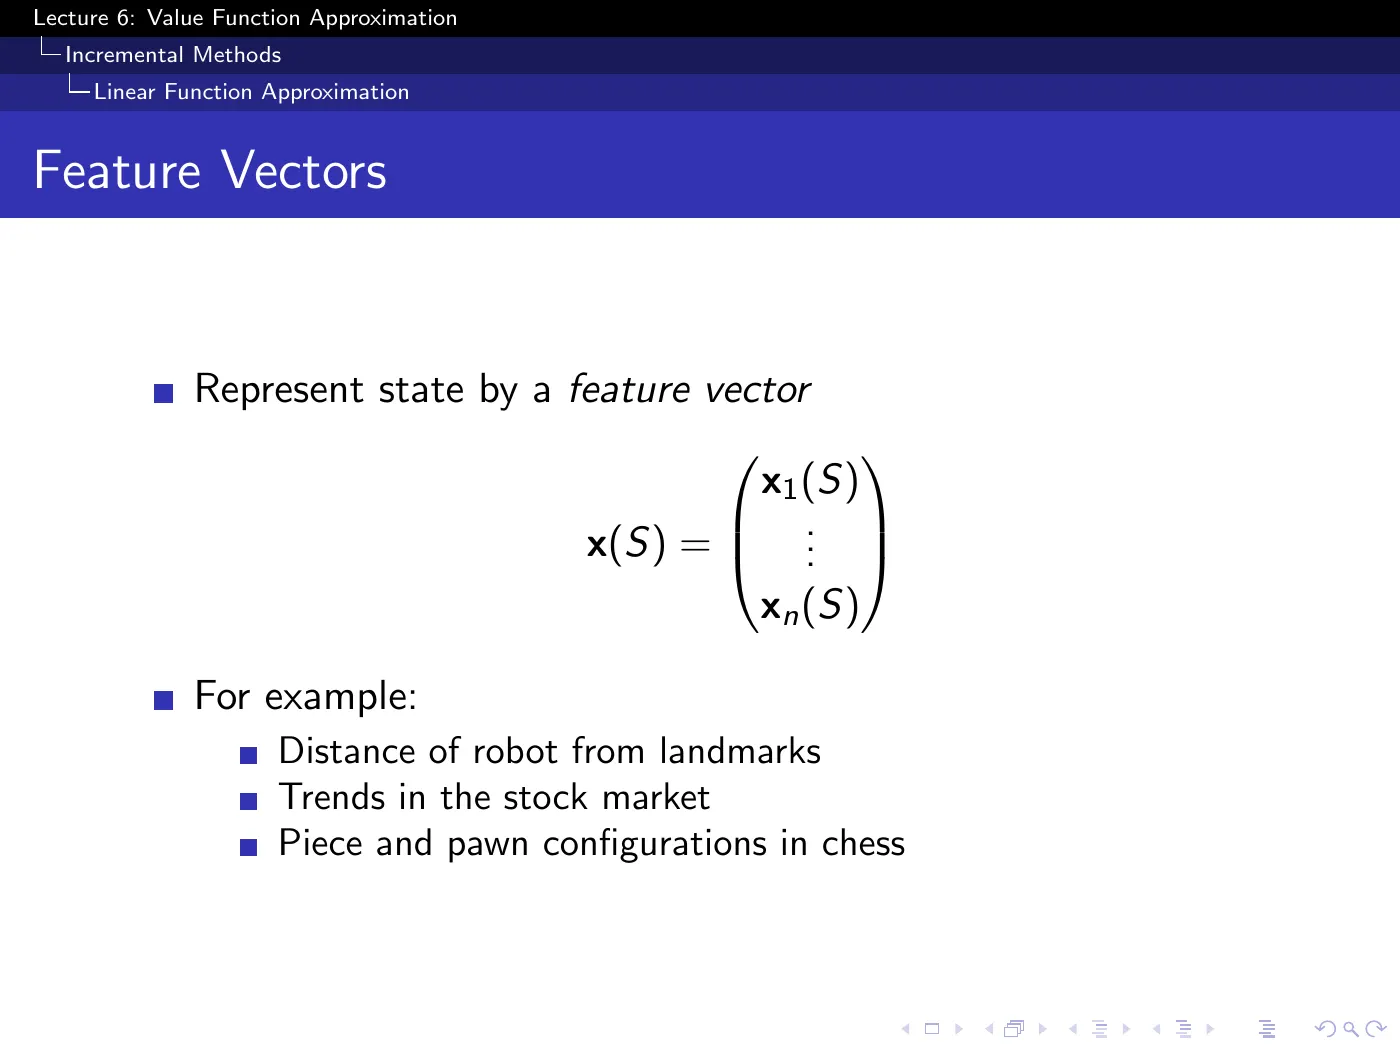
state를 숫자 vector로 바꾼다.
슬라이드의 예시: 로봇과 landmark 사이의 거리들 / 주식시장의 추세들 / 체스의 기물·폰 배치.
feature는 설계상 정보를 버린다(lossy). feature vector가 같은 두 state는 이 함수 입장에서 동일한 state이고, 구분할 방법이 없다. 이는 결함이 아니라 의도된 선택이다. feature가 적절하다면 버려진 정보는 애초에 필요하지 않았던 정보다.
이 강의는 좋은 feature를 어떻게 얻는지 다루지 않는다. 그것은 representation learning의 문제이고, 강의가 제시하는 방향은 "손으로 설계하지 말고 neural network를 쓰라"는 것이다.
p.14 — Linear Value Function Approximation
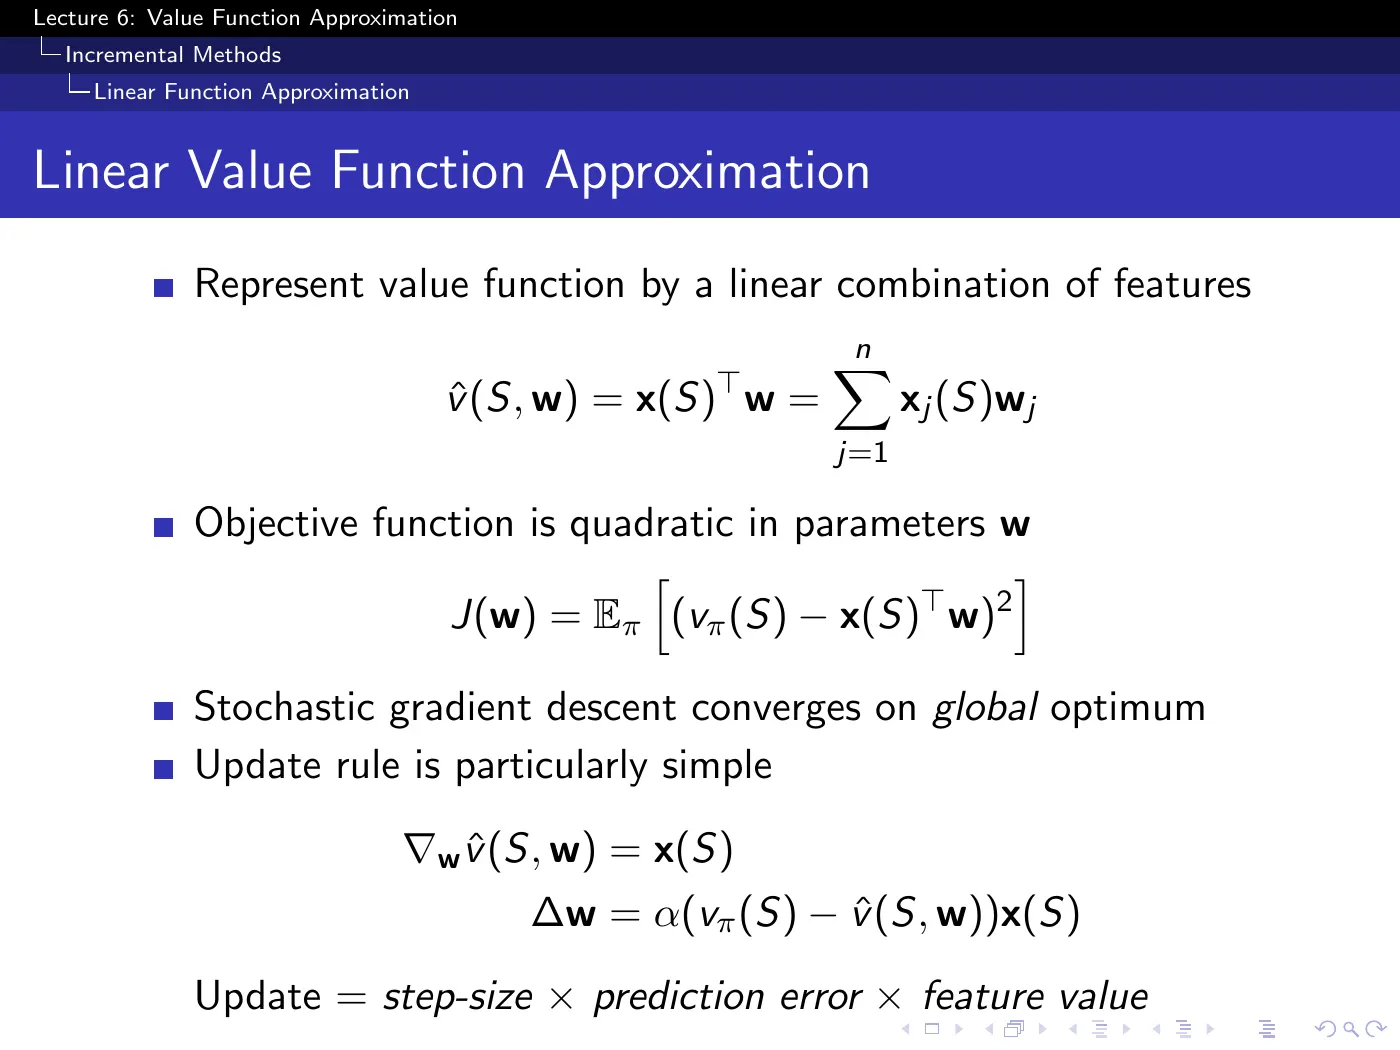
읽는 법: 각 feature 값에 가중치를 곱해 전부 더한다. 그것이 그 state의 값이다.
여기서 두 가지가 따라온다.
(1) 가 에 대해 quadratic이다 → local minimum이 없고 global optimum이 유일하다. 가 볼록한 그릇(bowl) 모양이므로 SGD가 반드시 바닥에 도달한다.
(2) gradient가 매우 단순해진다.
이므로 이고, 이를 세로로 쌓으면 가 된다.
따라서 업데이트는 다음과 같다:
세 번째 항이 핵심인데, 슬라이드는 "feature value"라고만 적고 넘어간다. 실제로 이 항이 하는 일은 credit assignment, 즉 오차의 책임을 어느 weight에 물릴지 정하는 것이다.
체스로 예를 들면, 어떤 국면의 평가가 틀렸는데 그 국면에 퀸이 없었다고 하자. 퀸에 해당하는 feature 값이 0이므로 곱셈 결과 퀸의 weight는 전혀 움직이지 않는다. 그 feature는 오차와 무관했기 때문이다.
여기를 혼동하면 뒤의 수렴표를 전부 잘못 읽게 된다.
가 quadratic인 것은 parameter에 대해서다. 그것이 그릇 모양의 곡면과 유일한 global optimum을 보장한다.
feature 자체는 state의 비선형 함수여도 무관하다 — Gaussian, tile coding, wavelet, 다항식 항 모두 가능하다.
사소한 구분이 아니다. Mountain Car는 coarse coding과 radial basis function으로 푸는데, 이 강의의 용법으로는 여전히 linear function approximation이며 linear column의 ✓를 그대로 물려받는다. "feature가 non-linear다"를 "non-linear function approximation이다"로 잘못 읽으면 표의 다른 열을 보게 되고, 실제로는 없는 문제를 걱정하게 된다.
p.15 — Table Lookup Features
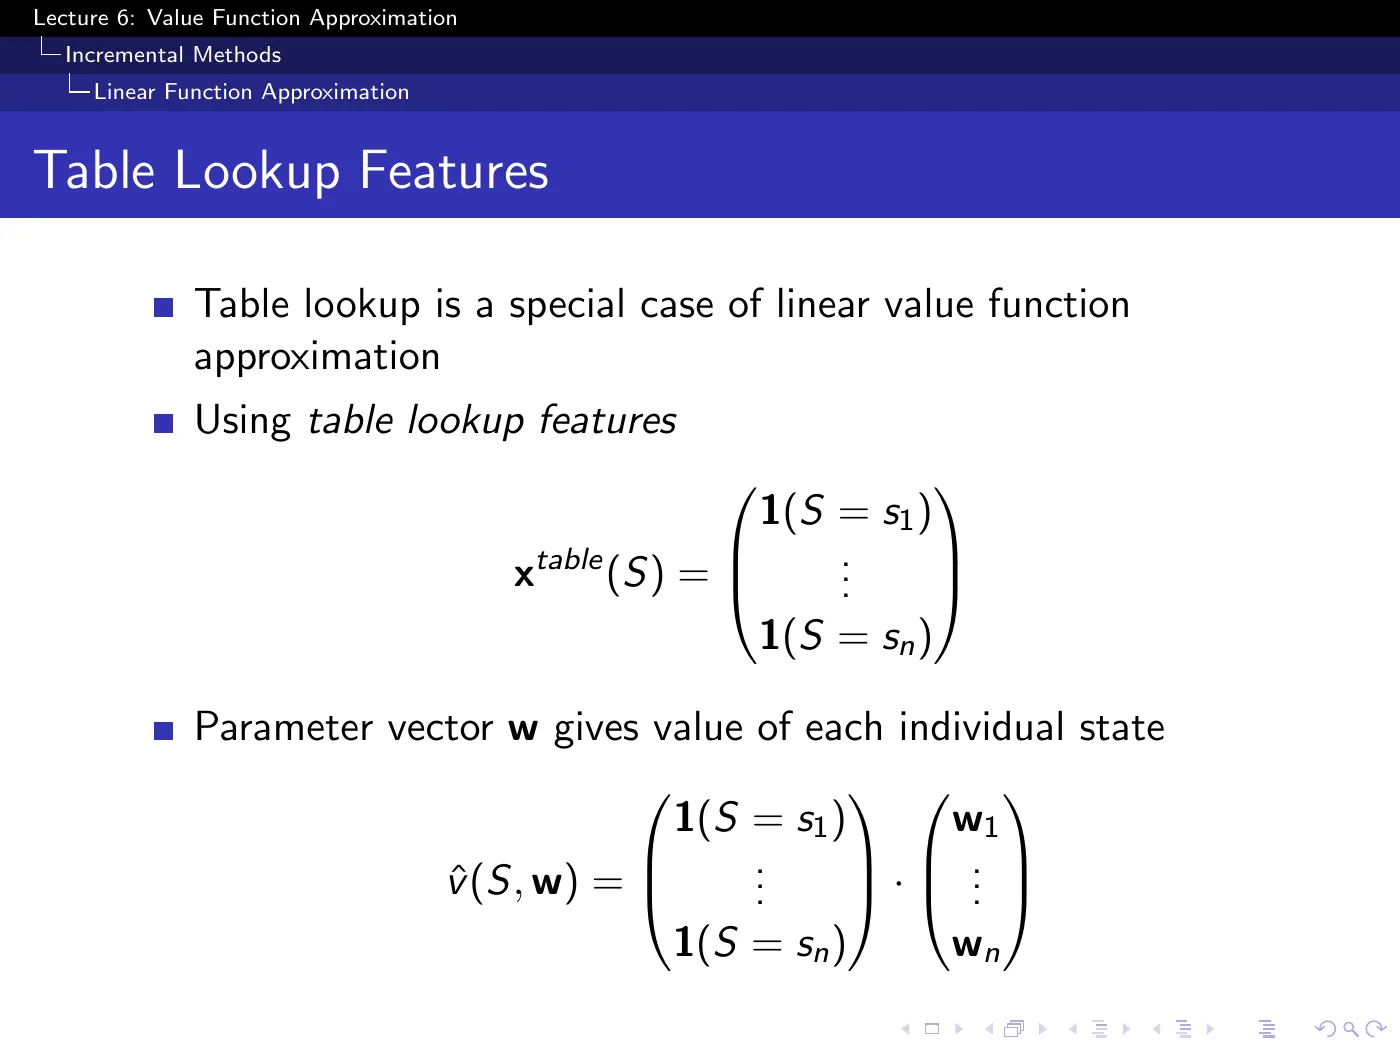
one-hot feature를 쓰면 다음과 같이 된다:
은 indicator function으로, 조건이 참이면 1, 거짓이면 0이다. 따라서 이 vector는 현재 state 자리만 1이고 나머지는 전부 0이다.
내적을 하면 weight 하나만 선택된다. 즉 가 곧 표다.
L1~L5 전체가 오늘 다루는 내용의 특수한 경우였던 것이다. 폐기되는 것이 아니라, feature가 서로 겹치지 않는 경우로 다시 정의된 것이다.
이 인코딩에서는 어떤 두 state도 활성 feature를 공유하지 않는다. 따라서 state 의 weight를 업데이트해도 다른 state의 값은 정확히 0만큼 움직인다.
이것이 "표는 generalize하지 못한다"의 정확한 수학적 의미이고, 동시에 generalization의 정의이기도 하다:
generalization은 서로 다른 state의 feature vector가 겹치는 것이며, 그 이상은 아니다.
coarse coding이 작동하는 이유도 같다. 가까운 state들이 공유된 타일을 활성화하기 때문이다.
§3 · Oracle 걷어내기 — Prediction (slides p.16–20)
p.16 — Incremental Prediction Algorithms
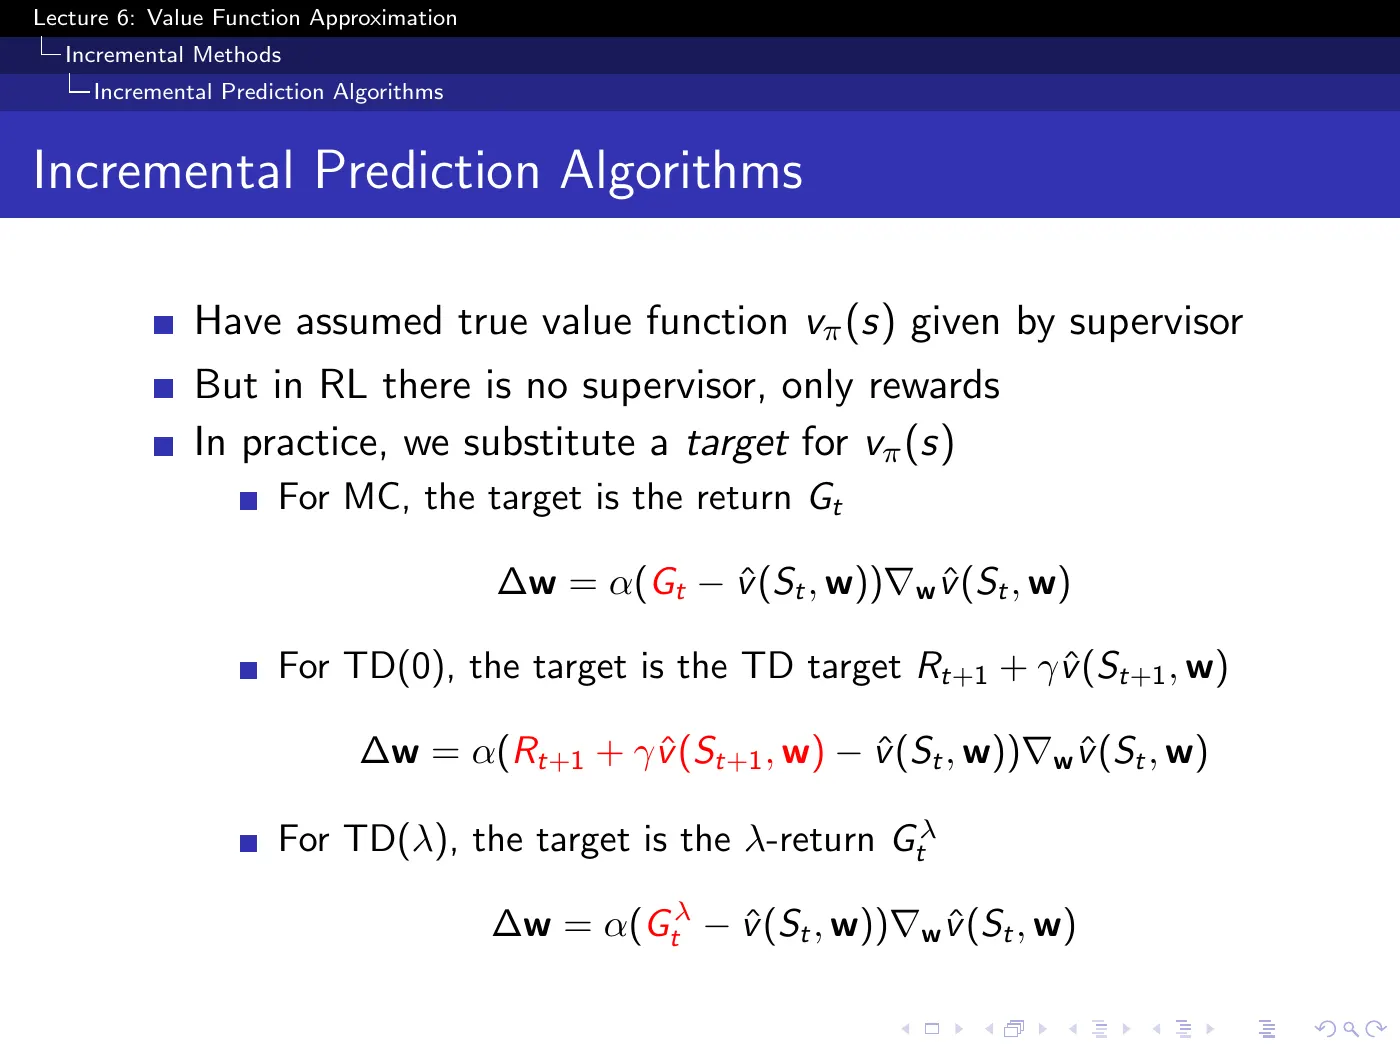
p.12에서 미뤄둔 가정을 해소하는 슬라이드다. 슬라이드가 직접 밝힌다: "Have assumed true value function given by supervisor. But in RL there is no supervisor, only rewards."
해법은 대입 한 번이다. 자리에 target을 넣는다. 업데이트 규칙 자체는 바뀌지 않는다.
슬라이드는 셋을 동등한 선택지처럼 나열하지만, 실제로는 동등하지 않다. 그리고 그 차이가 강의 후반부 수렴 문제 전체의 출발점이다.
| Target | biased? | 에 의존하나? | 결과 |
|---|---|---|---|
| 아니오 (unbiased) | 아니오 | 고정된 목적함수 위의 SGD가 성립한다 | |
| 예 | 예 | 어떤 목적함수의 gradient도 아니다 | |
| 예 (일 때) | 예 | 같음 |
슬라이드가 다루는 것은 두 번째 열(bias)이지만, 발산을 실제로 일으키는 것은 세 번째 열이다. 그리고 이 사실을 명시하는 슬라이드는 p.31에서야 나온다.
bias는 "평균적으로 틀린 값을 향한다"는 뜻이고, 의존성은 "목표값이 내가 조정하는 파라미터에 연동되어 있다"는 뜻이다.
bias만 있으면 조금 틀린 곳으로 수렴한다. 의존성이 있으면 수렴 자체를 보장할 수 없다. 후자가 훨씬 심각하다.
bias는 추정값 평균의 위치, variance는 추정값들이 흩어진 정도다. 총 오차가 bias + variance로 분해되므로 둘은 맞바꿀 수 있고, 그것이 bootstrapping을 하는 이유다.
그리고 이 둘은 위 표의 세 번째 열( 의존성)과 급이 다른 문제다 — 앞의 둘은 정확도와 속도, 세 번째는 수렴 여부다.
→ Bias and Variance (2026-09-02)
p.17 — Monte-Carlo with Value Function Approximation
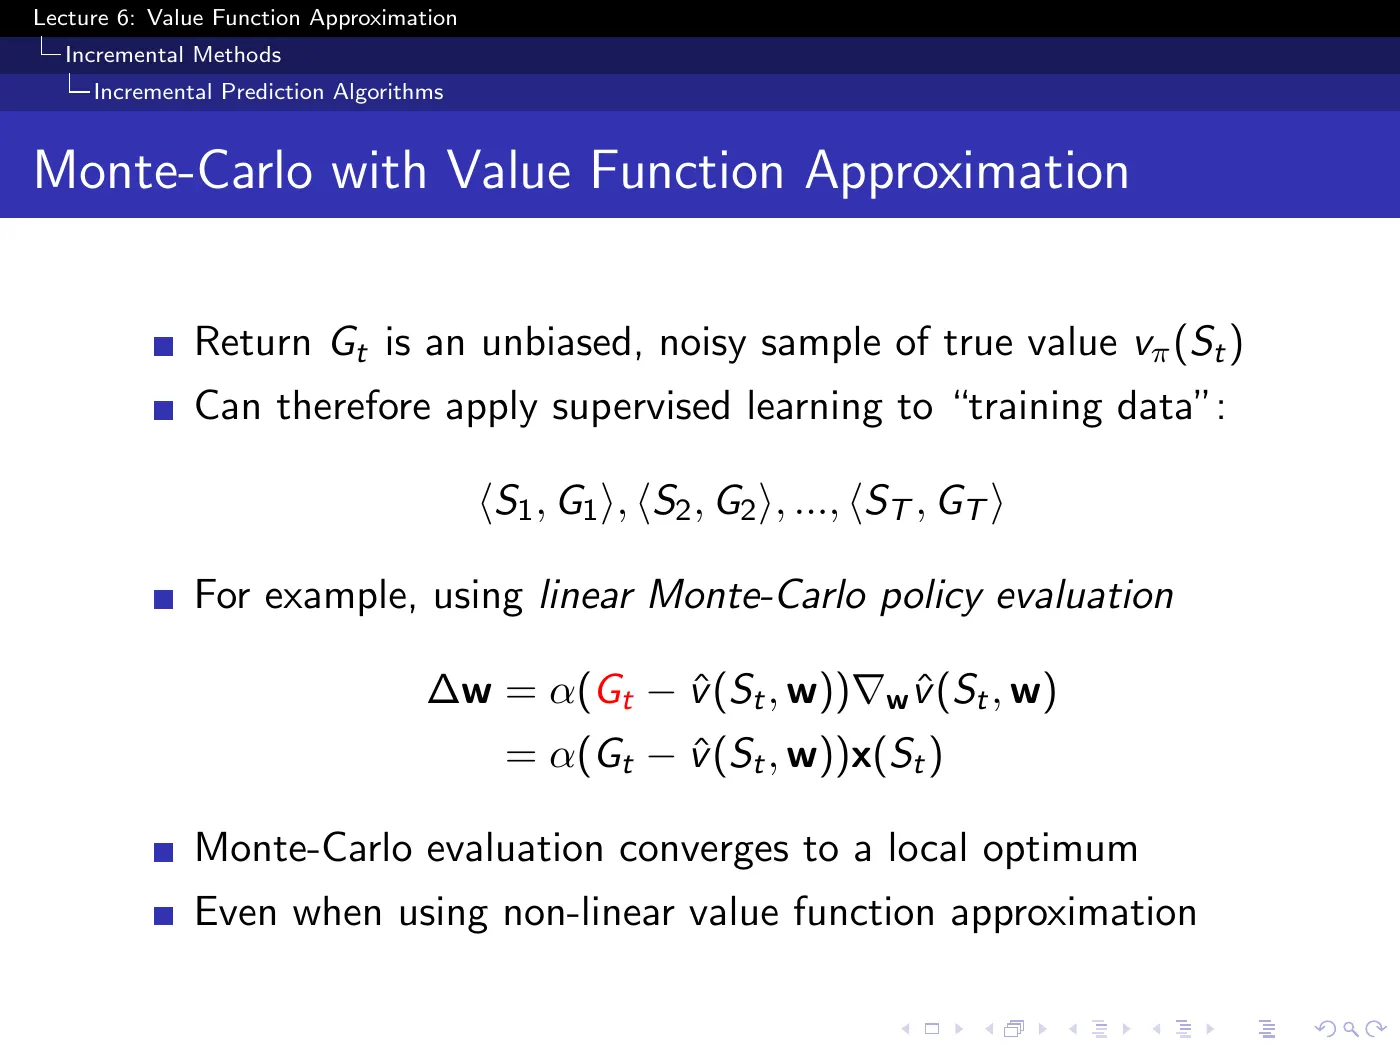
는 의 unbiased, noisy sample이다. 따라서 MC는 정답에 noise가 섞인 supervised learning과 정확히 같다.
이 사실이 뒤에 나오는 모든 수렴표에서 MC 행이 전부 ✓인 이유를 설명한다. target이 에 의존하지 않으므로 업데이트가 실제로 고정된 목적함수 위의 SGD이고, 표준 SGD 이론이 수정 없이 그대로 적용된다. linear이면 global optimum, non-linear이면 local optimum이다.
대가는 variance다. 그 크기는 p.27에서 확인하게 되는데, 거기서 MC는 모든 벤치마크에서 bootstrapping에 뒤진다.
p.18 — TD Learning with Value Function Approximation
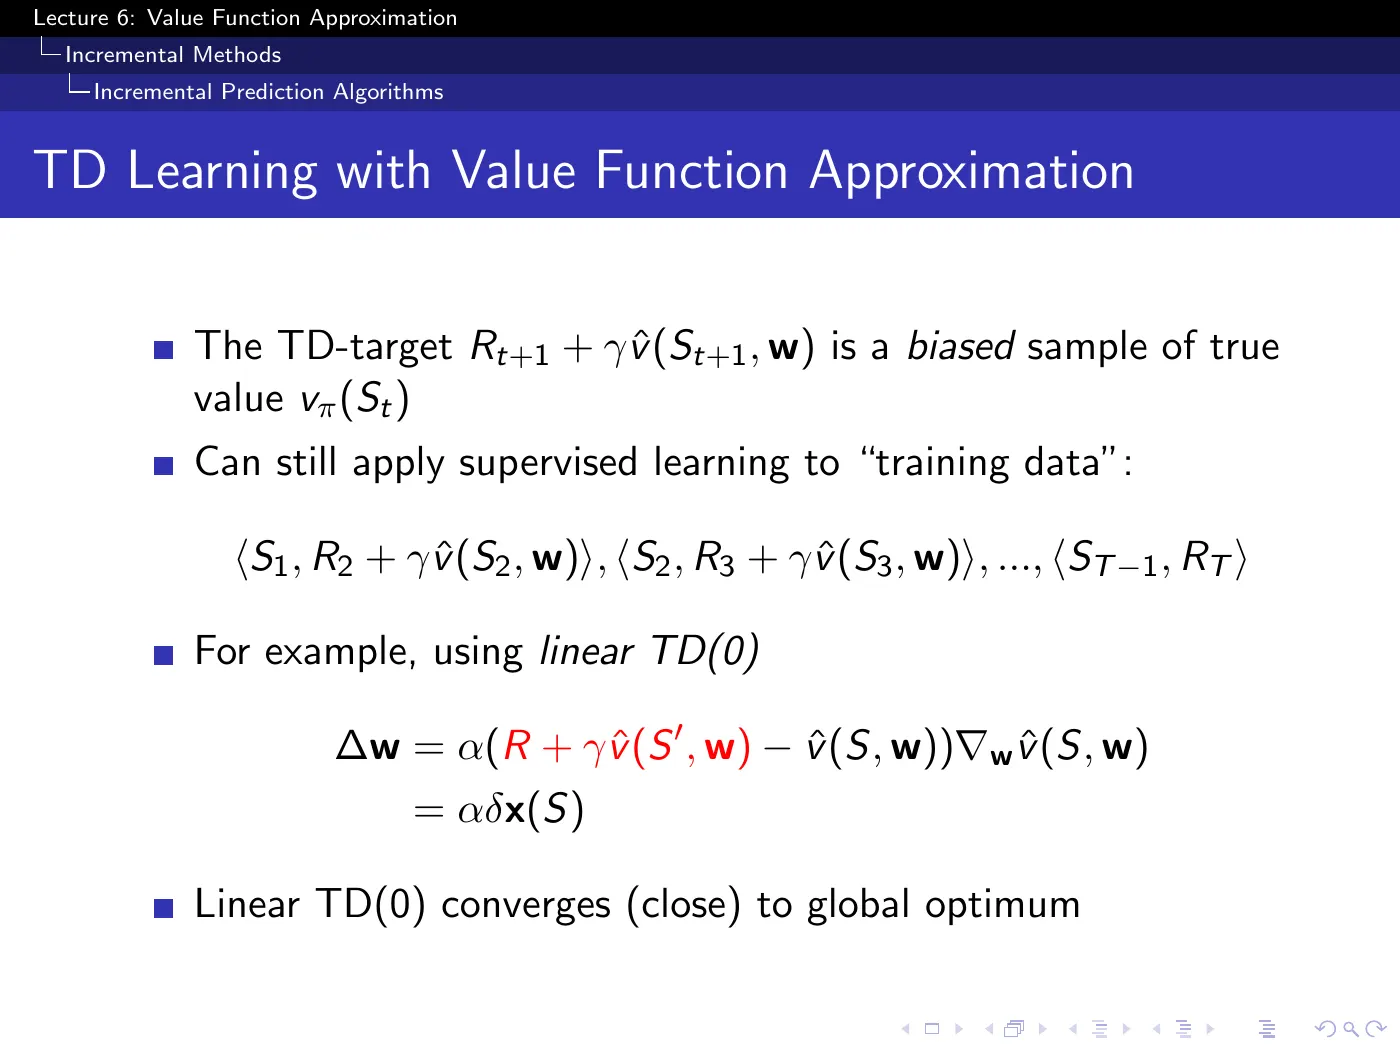
는 TD error로, L4에서 이미 다룬 것과 같다. 달라진 점은 업데이트가 표의 특정 칸이 아니라 방향으로 이루어진다는 것뿐이다.
슬라이드 마지막 줄은 가장 중요한 단어를 괄호 안에 넣어두었다:
"Linear TD(0) converges (close) to global optimum"
TD(0)이 수렴하는 지점은 TD fixed point 이며, 이는 least-squares 최적점이 아니다. 둘의 차이에는 알려진 상한이 있다 (Tsitsiklis & Van Roy 1997; Sutton & Barto 2e eq. 9.14, continuing case에 대해 증명됨):
는 작은 보정항이 아니다. 이면 100이다. TD 해가 "표현 가능한 최선의 해의 100배 이내"라는 것만 보장된다는 뜻이고, 가 1에 가까운 것은 드문 경우가 아니라 일반적인 경우다.
worst-case 상한이므로 실제 성능은 이보다 훨씬 낫다. 다만 "converges close to the global optimum"이라는 표현이 실제로 보장하는 범위는 겉보기보다 훨씬 넓다.
그럼에도 이 방식을 쓰는 이유는 variance 때문이다. TD는 MC보다 훨씬 빠르다. MC는 에 도달하지만 속도가 느리다.
p.17과 p.18 모두 같은 데이터셋을 제시하며 "supervised learning을 적용한다"고 말한다. 데이터를 모아두었다가 학습하는 것처럼 읽히지만, 강의 전반부에서는 그렇게 하지 않는다.
모든 업데이트는 online으로 한 step씩 적용되고, 경험은 즉시 폐기된다.
데이터셋이 실제로 저장되는 것은 p.36부터이며, 그 차이가 batch method를 별개의 방법으로 만든다.
§3에서 가장 중요한 질문
TD target에도 가 들어 있다. 그런데 왜 gradient는 에만 붙고 target에는 붙지 않는가?
밑줄 친 두 곳을 비교할 것. target 안에도 가 들어 있는데 gradient는 오른쪽 항에만 적용된다.
답: TD는 정보를 시간의 앞 방향으로 전달하는 방식으로 작동하는데, 양쪽을 모두 미분하면 그 방향성이 사라지기 때문이다.
구체적으로:
- 두 추정치 중 가 더 신뢰할 만하다. 실제 reward 을 한 번 더 관측한 뒤의 추정이므로 참값에 그만큼 가깝다
- TD는 이 값을 고정된 것으로 취급하고 앞쪽 추정을 그쪽으로 이동시킨다
- 양쪽에 gradient를 걸면 업데이트가 대칭이 된다. 두 추정치가 서로를 끌어당기게 되어, 더 신뢰할 만한 나중 추정치가 덜 신뢰할 만한 앞쪽으로 끌려온다
- table lookup에서조차 이 방식으로는 틀린 value function으로 수렴하는 stochastic MDP를 구성할 수 있다
residual gradient라는 알고리즘 계열이 실제로 존재한다. 막히는 이유는 개념적인 것이 아니라 통계적인 것이다.
단순한 incremental 버전은 biased다. error 항과 gradient 항 양쪽에 모두 가 들어 있어서, 상관된 두 샘플의 곱이 각 기댓값의 곱을 추정하지 못하기 때문이다.
이를 해결하려면 같은 state에서 나온 의 독립 샘플 두 개가 필요한데, 한 번만 step할 수 있는 실제 환경에서는 얻을 수 없다. (시뮬레이터에서 state를 복원할 수 있다면 가능하다. 즉 이론적 불가능이 아니라 실무적 제약이다.)
그래서 이 업데이트를 semi-gradient라고 부른다. 유효한 알고리즘이지만 어떤 목적함수의 gradient descent도 아니다. 이것이 p.31이 명시하는 내용이자, 발산이 가능한 근본 이유다.
p.19–20 — TD(λ) with Value Function Approximation
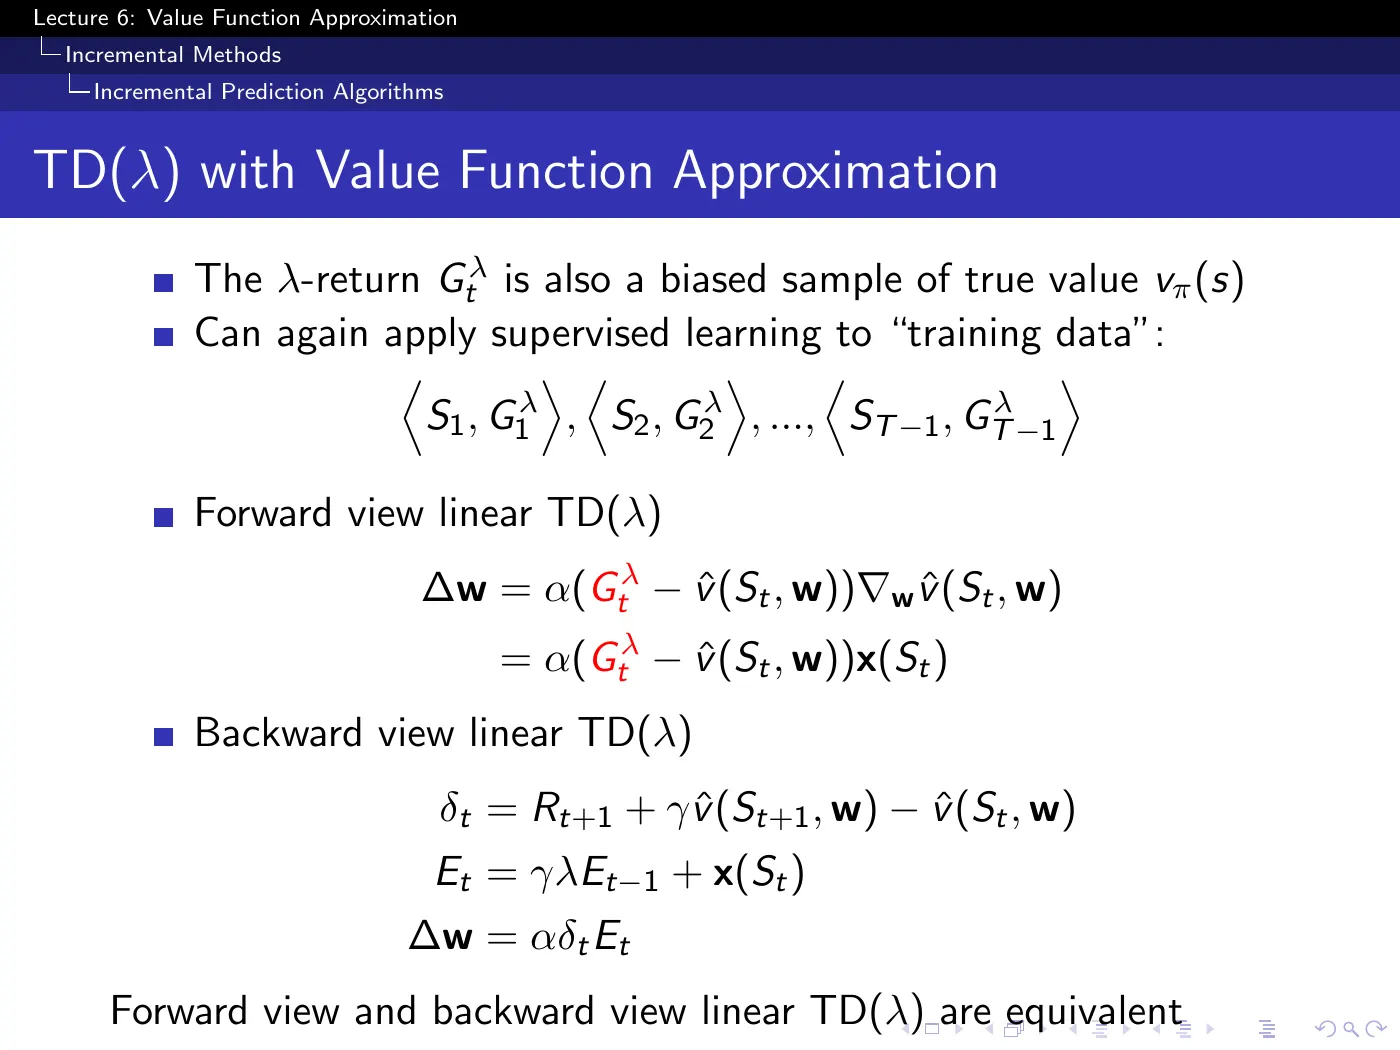
forward view와 backward view가 동등하다는 점도 L4와 같다 → Forward and Backward Views of TD Lambda
식의 형태가 그대로여서 놓치기 쉽지만, 여기에 핵심적인 변경이 하나 있다.
의 차원은 와 같다. feature 하나당 한 칸이지 state-action pair 하나당 한 칸이 아니다.
L5에서 trace는 와 같은 크기의 표였다. 그대로 두었다면 와 똑같은 이유로 규모 문제에 걸렸을 것이다.
이 변경 덕분에 trace가 function approximation에서도 사용 가능해진다. trace가 feature vector를 누적하므로, 활성이었던 feature에 그 강도에 비례해 credit이 배분된다. L5의 recency·frequency 개념을 feature 단위로 다시 쓴 것이다.
§4 · Control (slides p.21–27)
여기서부터 prediction()에서 control()로 넘어간다. 새로 배울 내용은 거의 없다. §2의 유도에서 를 로 바꾸면 그대로 성립한다.
p.21 — Control with Value Function Approximation
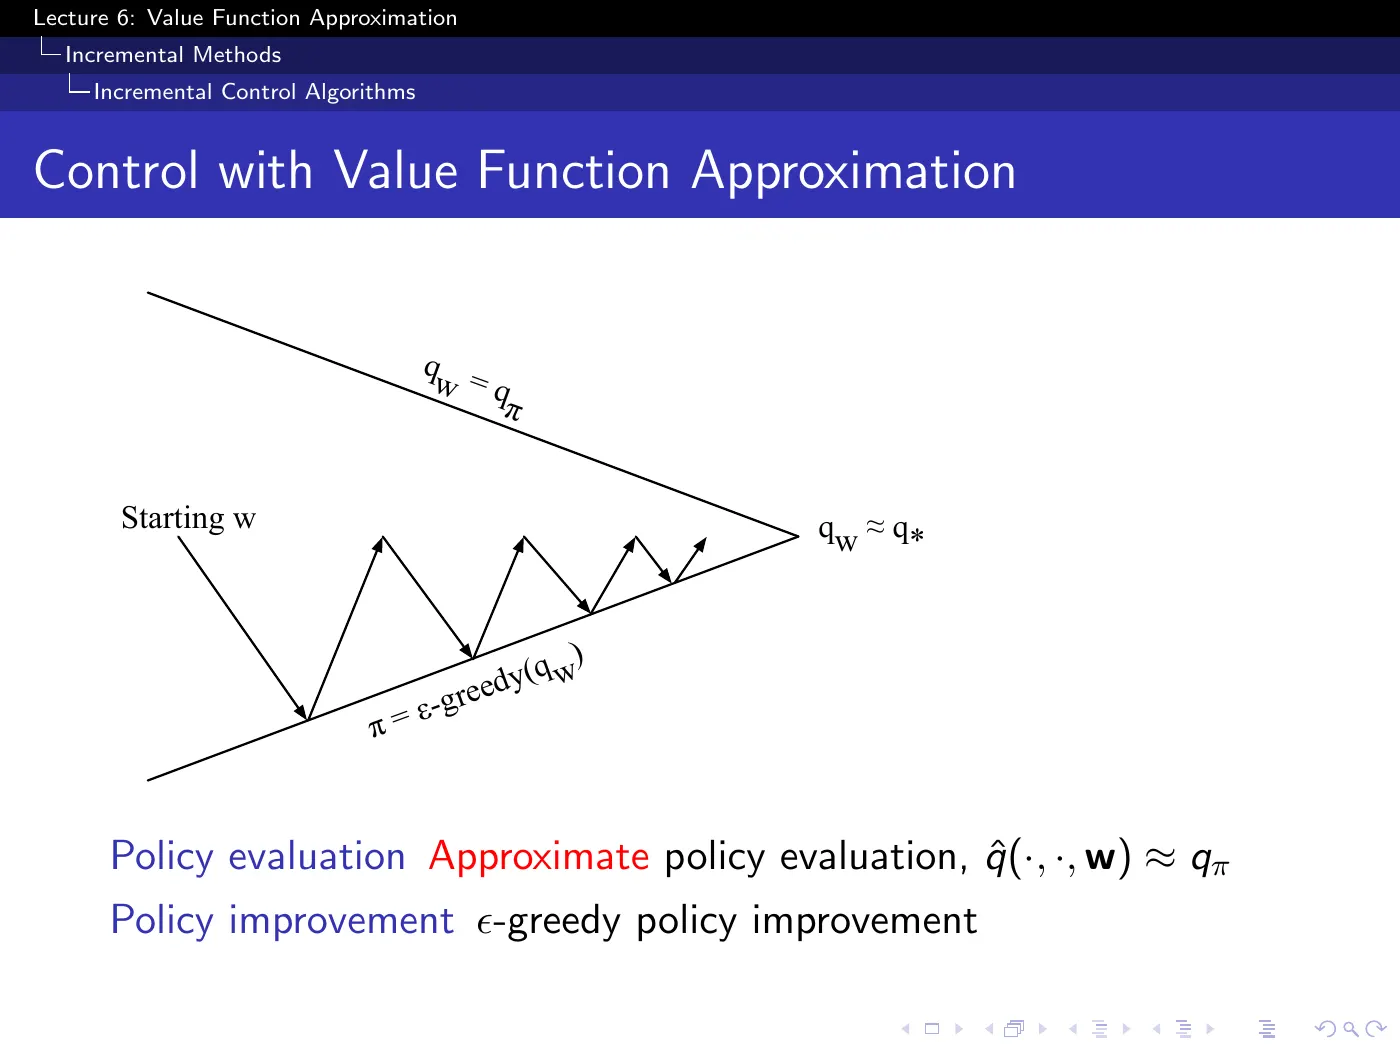
L5와 동일한 GPI(generalised policy iteration) 루프다. 위쪽 화살표가 evaluation, 아래쪽 화살표가 improvement다.
- policy evaluation — approximate policy evaluation,
- policy improvement — -greedy policy improvement
L5와 마찬가지로 evaluation을 수렴할 때까지 돌린 뒤에 improve하지 않는다. 가장 최신 추정치로 바로 행동한다. 완전히 incremental한 경우라면 매 step마다 업데이트하고 매 step마다 다시 행동을 선택한다는 뜻이다.
아래쪽 라벨 는 정확하다. 근사한다고 적혀 있다.
위쪽 라벨 는 달성할 수 없다. 근사기가 고정되어 있으면 가 애초에 표현 가능한 함수 집합 안에 없을 수 있기 때문이다. 위쪽 화살표는 그 선에 도달하지 못한다.
이는 알고리즘의 결함이 아니라 L5의 보장이 성립하지 않게 되는 이유이며, p.32 전체의 내용이다.
p.22–24 — Action-Value Function Approximation
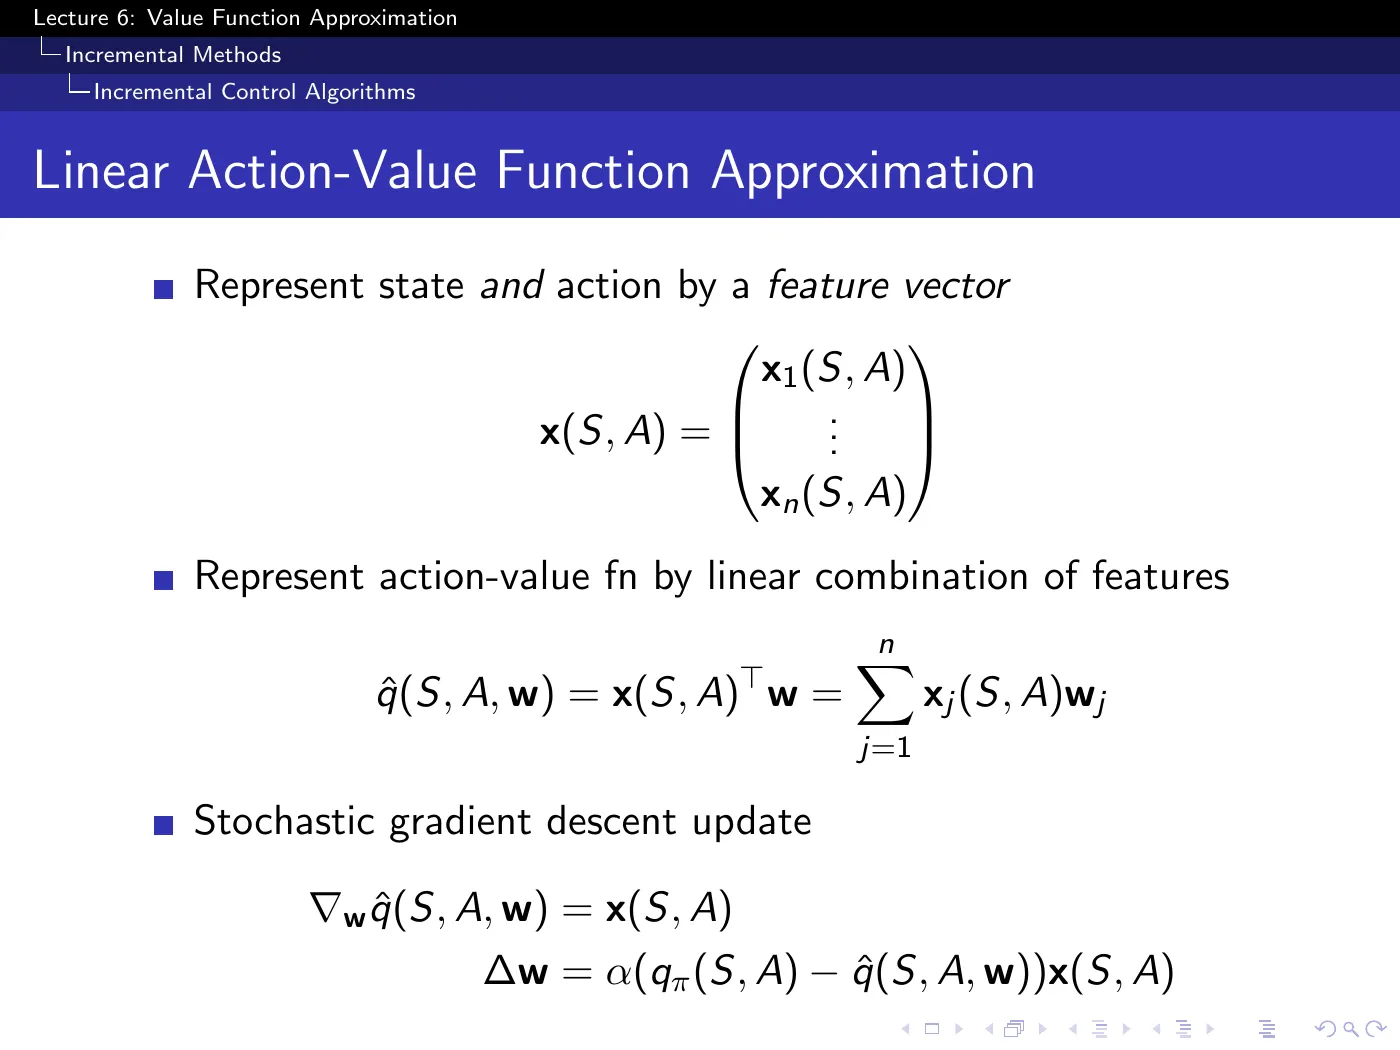
세 장 모두 앞에서 이미 본 내용이다. p.12→p.16의 유도에서 를 로 바꾼 것이고, 새로운 주장은 없다.
linear이면 , 가 된다. 그리고 p.24에서 oracle 자리에 target을 대입한다 — MC는 , TD(0)은 (= Sarsa), TD(λ)은 다.
구조적 변화는 하나뿐이다: feature가 가 되었다. state와 action 양쪽의 함수라는 뜻이다.
그 결과 action들 사이에서도 generalize할 수 있게 된다. 비슷한 action끼리 feature를 공유하도록 설계하면 한 action에서 배운 것이 다른 action에도 반영된다.
반대로 차단할 수도 있다. indicator를 써서 action마다 서로 겹치지 않는 feature 블록을 할당하는 방식이 흔한데 (p.53의 chain walk가 이 방식이다), 그러면 action 간 generalization이 0이 된다. 이것은 설계 선택이지만, 슬라이드는 그것이 선택이라는 점을 표시하지 않는다.
p.25–26 — Mountain Car
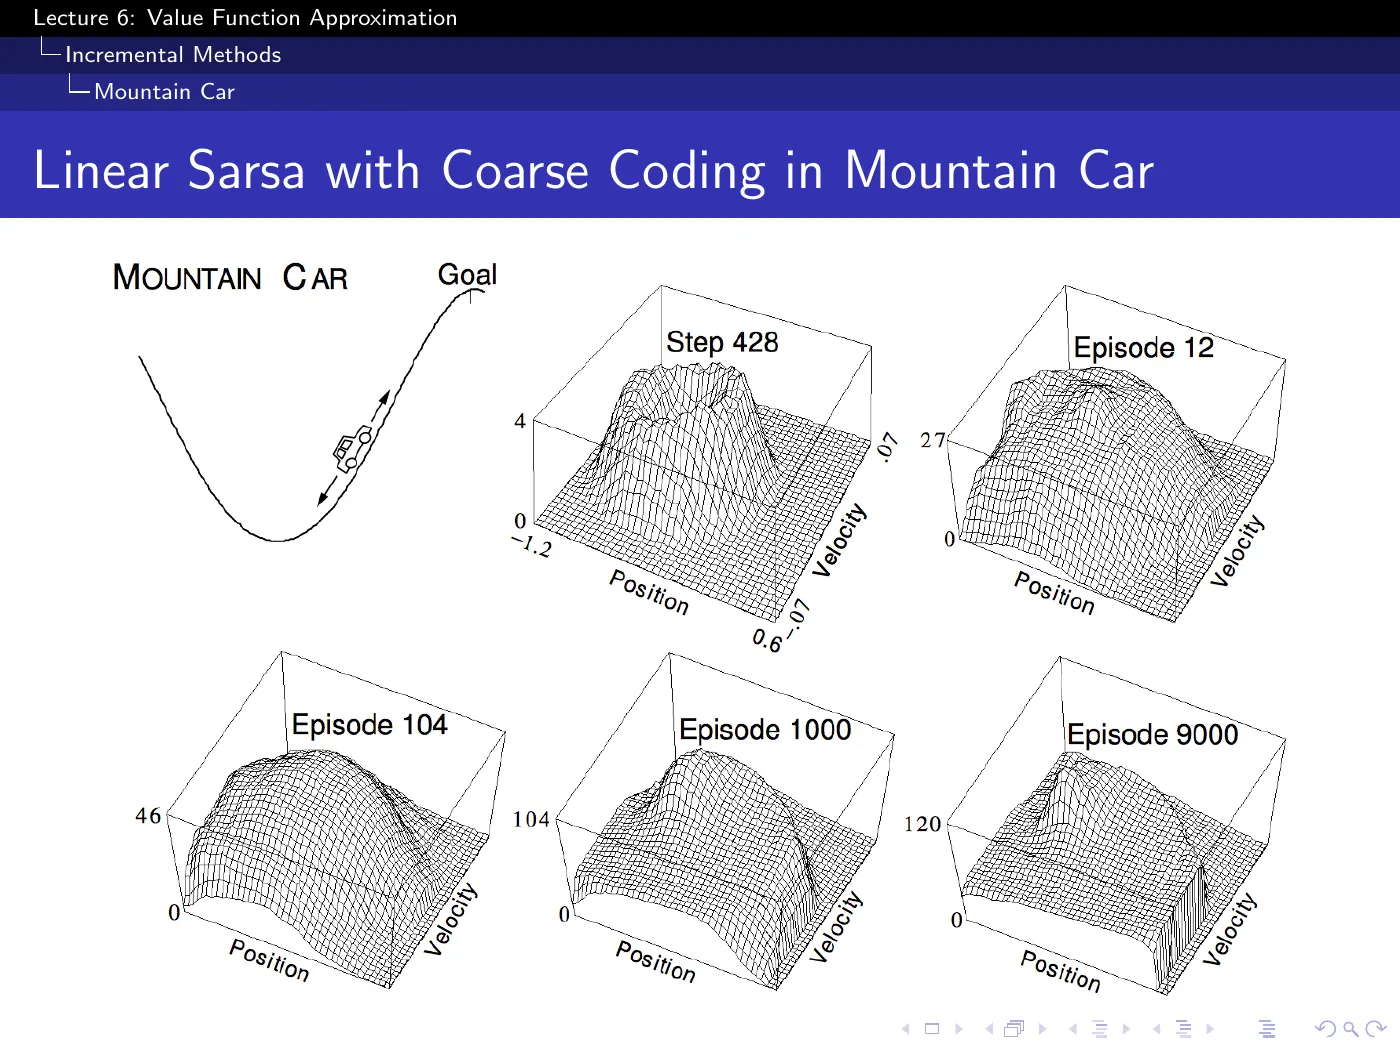
문제 설정: 출력이 부족한 자동차가 골짜기에 있다. 언덕을 곧장 올라갈 힘이 없으므로 뒤로 물러나 반동을 만들어야 한다.
이 문제가 표준 벤치마크인 이유가 여기 있다. 궤적의 일부 구간에서 최적 action이 목표의 반대 방향을 가리킨다. 목표 쪽으로만 greedy하게 움직이면 끝내 올라가지 못한다.
- state space: 2차원 연속 — position, velocity
- function approximator: coarse coding. 모양과 크기가 다양한 타일을 겹치게 배치한다. 어떤 state를 방문하면 그 state를 덮는 타일들만 갱신되고 나머지는 움직이지 않는다 → generalization이 국소적이며, 그 범위는 타일 크기가 결정한다
패널이 진행되면서 표면이 커진다 — 대략 . 그런데 policy는 동시에 개선되고 있다.
step마다 인 이 문제에서 세로축이 value function이라면 성립할 수 없는 현상이다. 개선되면 값이 0 쪽으로 가야 하기 때문이다.
세로축은 value가 아니라 cost-to-go, 즉 다. (Sutton & Barto 2e Figure 10.1이 이 그림의 출처이며 그렇게 라벨링되어 있다.)
값이 커지는 것은 근사기가 먼 state들의 실제 비용을 점차 파악해 가는 과정이다. 거의 0에서 시작했기 때문이다.
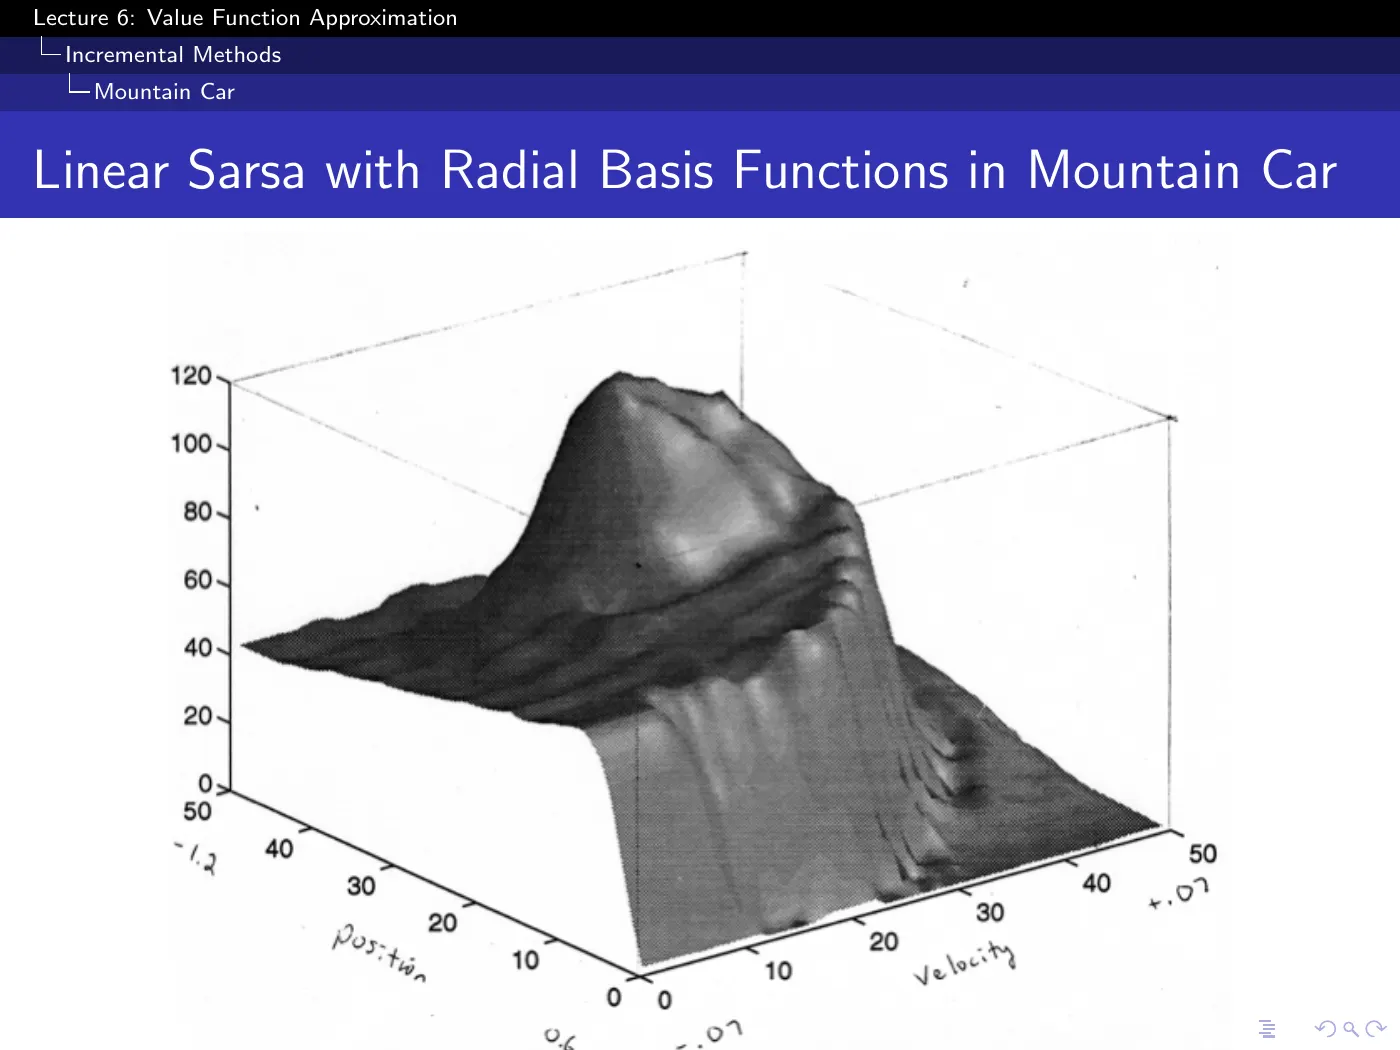
나선 형태는 수렴한 최적 value function의 근사다. 여기서는 타일 대신 radial basis function을 사용했다. 표면이 매끄러운 것은 근사기가 **보간(interpolate)**하기 때문이며, 어디에도 정확한 값이 저장되어 있지 않다.
연속이 아니다. action은 이산이다 — 앞으로 가속 / 뒤로 가속 / 타력주행. 그리고 이것은 bang-bang control 문제여서 최적해가 항상 가속 범위의 양 끝 중 하나에 있고, 중간값은 실제로 쓰이지 않는다.
action space가 연속이면 Sarsa 자체는 그대로 적용되지만, 가 출력 몇 개를 비교하는 일이 아니라 매 time-step마다 풀어야 하는 optimization problem이 된다.
이 비용이 연속 영역에서 value-based control에 대한 표준적인 반론이고, L7의 policy-based method가 나오는 동기 중 하나다. 로봇 토크 제어가 정확히 이 경우에 해당한다.
질문에 섞여 있는 두 가지를 분리해야 한다.
state는 MDP가 정한다. position과 velocity는 문제 자체이지 모델링 선택이 아니고, 의 형태도 그에 따라 정해진다. 바꿀 수 없다.
feature는 설계자가 정한다. 좋은 feature는 표현하기 어려운 형태를 다루기 쉬운 형태로 바꾼다. 그리고 그것이 domain knowledge가 RL 시스템에 반영되는 경로다.
정리하면 value function 자체는 단순화할 수 없지만, 학습 문제는 단순화할 수 있다.
p.27 — Study of λ: Should We Bootstrap?
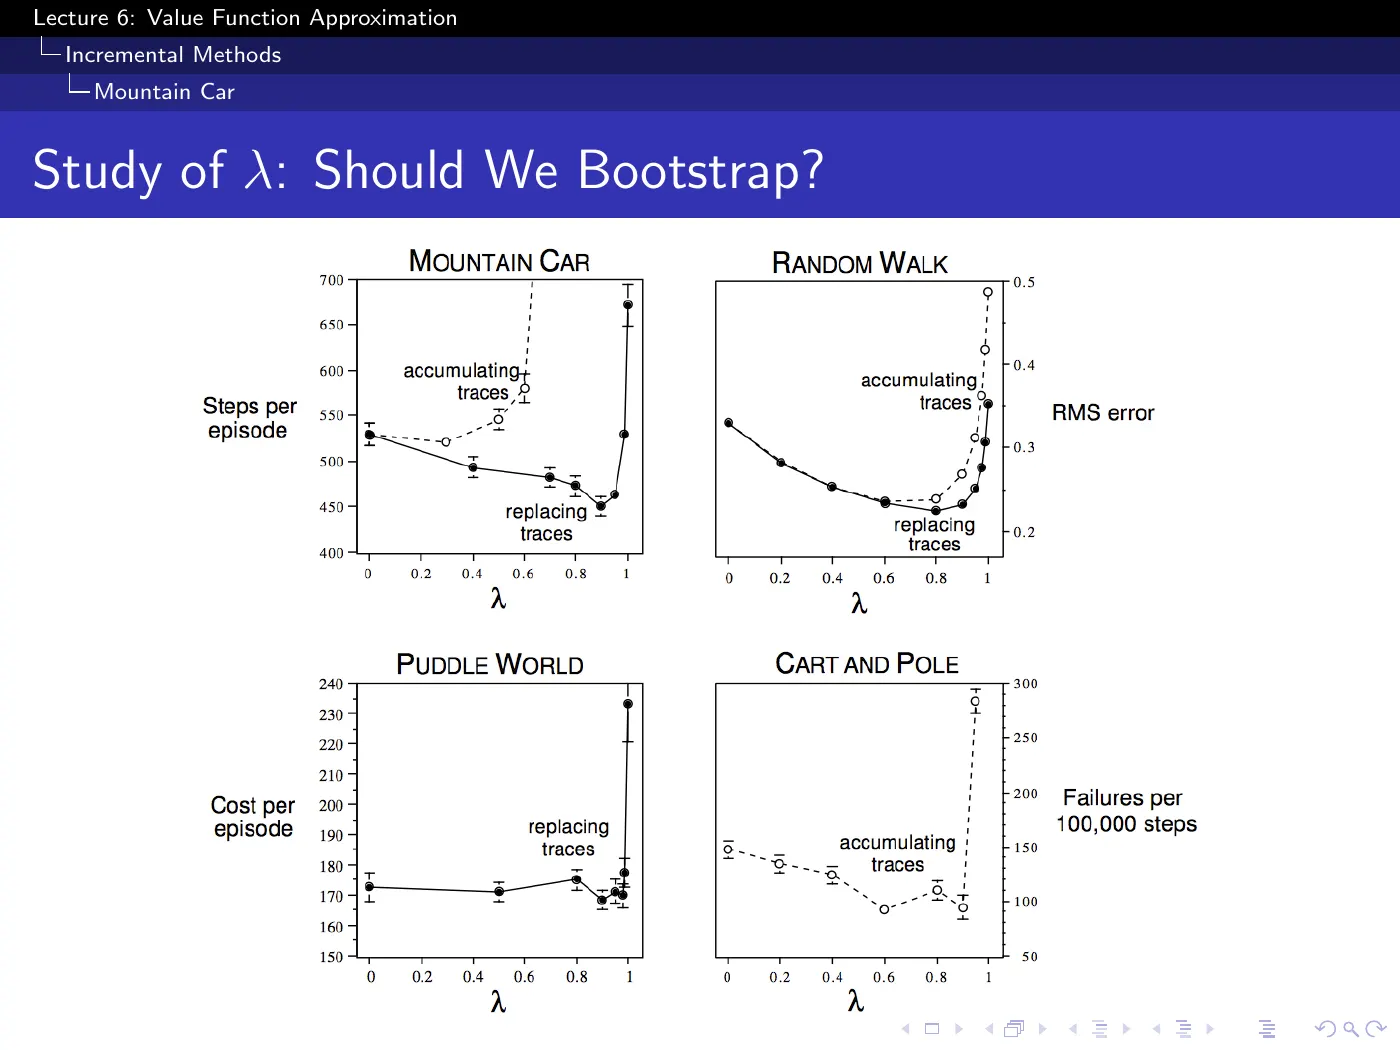
도메인 4개에 세로축이 4종류다 — steps per episode / RMS error / cost per episode / failures per 100,000 steps. 서로 다른 양이지만 넷 다 낮을수록 좋은 지표여서 네 곡선이 같은 결론을 가리킨다. (accumulating과 replacing trace의 구분은 사소한 변형이므로 무시해도 된다.)
핵심은 곡선의 형태다. (순수 MC)은 모든 도메인에서 성능이 나쁘다. variance 때문이다. 이 더 낫고, 최적값은 그 사이에 있으며 위치는 도메인마다 다르다.
다음 네 장이 존재할 근거를 만드는 슬라이드다.
bootstrapping은 선호의 문제가 아니라 경험적으로 일관되게 더 나은 선택이다.
MC가 경쟁력이 있었다면 그냥 MC를 쓰고 모든 수렴 보장을 유지하면 됐다. MC는 이 강의의 어떤 표에서도 발산하지 않기 때문이다.
p.28부터 나오는 수렴 문제들은 방금 확인한 이득의 대가다. 이 순서로 읽어야 Gradient TD가 "피해야 할 것"이 아니라 "만들 가치가 있는 것"으로 읽힌다.
§5 · 깨지는 지점 (slides p.28–32)
p.28–29 — Baird's Counterexample
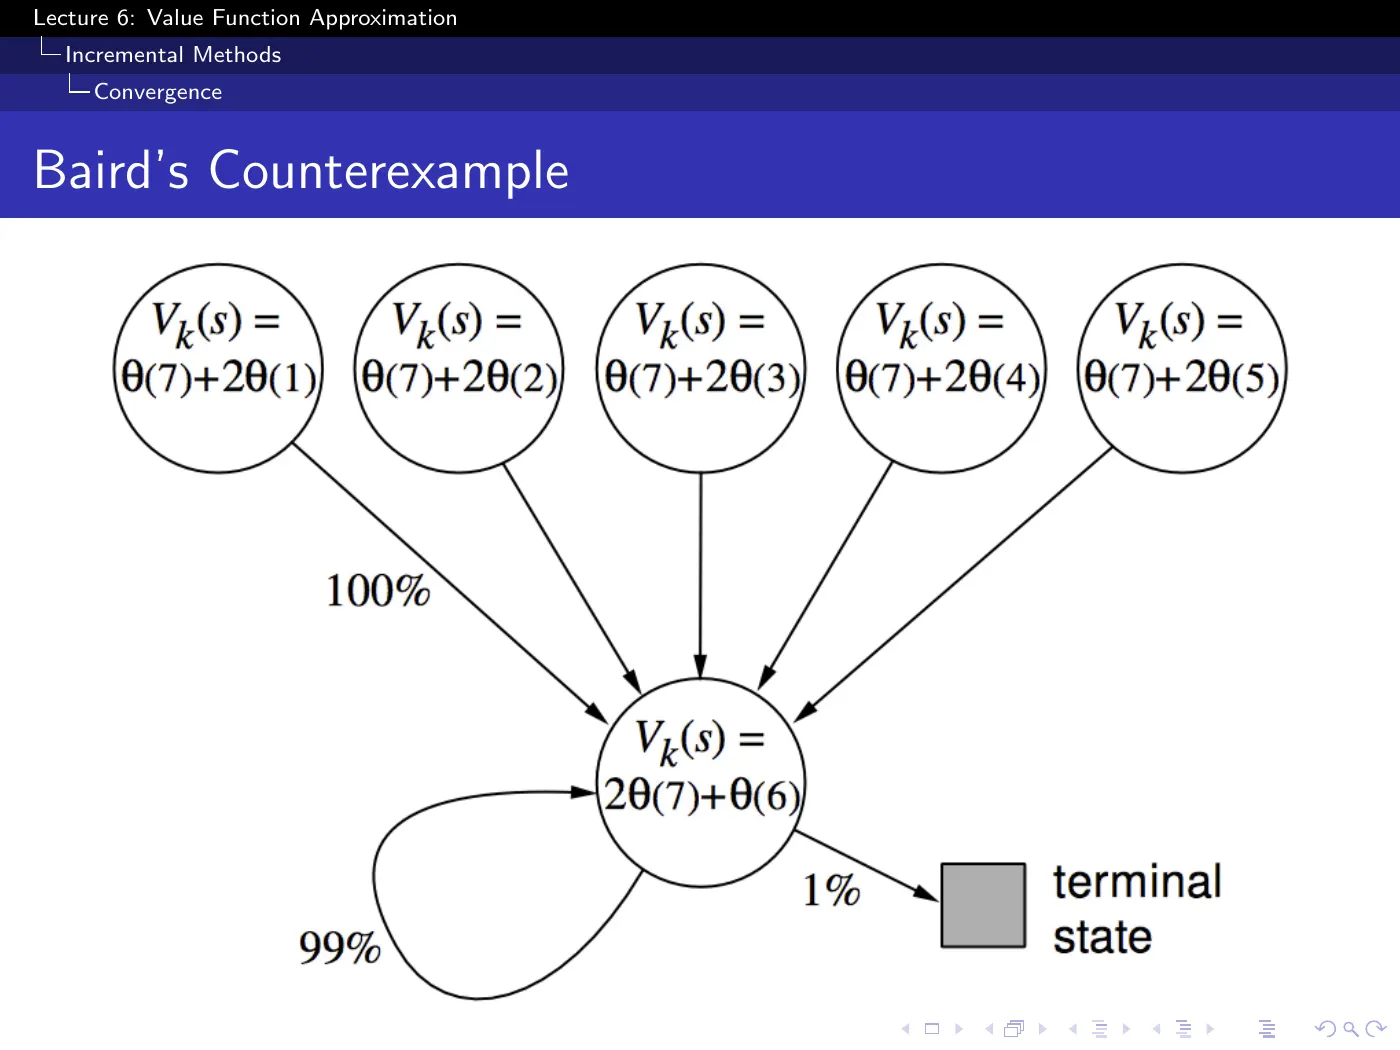
강의에서는 설명 없이 지나간다. 여기서는 Sutton & Barto 2e §11.2로 보충한다. 설정을 알아야 결과의 의미가 드러나기 때문이다.
구성: state 7개, action 2개, .
- 점선(dashed) action — 위쪽 6개 state 중 하나로 균등하게 간다
- 실선(solid) action — 7번 state로 간다
- behaviour policy — 확률 로 점선을 고른다. 그래서 다음 state 분포가 균등하다
- target policy — 항상 실선을 고른다. 그래서 의 on-policy 분포는 state 7에 몰린다
- 모든 transition의 reward가 0이다
이므로 참 value function은 모든 state에서 이고, 이는 으로 정확히 표현 가능하다.
state 7개에 weight가 8개라 해가 유일하지도 않을 만큼 여유가 있고, feature vector들은 linearly independent하다.
그럼에도 semi-gradient TD(0)은 아무리 작은 양수 step size에 대해서도 무한대로 발산한다. sampling noise도 asynchrony도 없는 full expected (DP) update에서도 마찬가지로 발산한다.
원인은 noise도, step size도, 표현력도 아니다. 세 조건의 조합 자체다.
off-policy가 왜 결정적인 조건인가 — 직관적으로 가장 이해하기 어려운 부분이다:
- on-policy에서는 값이 높은 state로 들어가는 transition을 겪었다면 언젠가 그 state에서 나오는 transition도 반드시 겪게 된다. 그 시점의 보정이 추정치를 제자리에 유지한다. 각 state는 "이후에 더 높은 값이 온다"고 예측함으로써만 앞 state의 값을 지지할 수 있고, 그 예측은 결국 검증된다
- off-policy에서는 target policy가 취하지 않을 action을 실행할 수 있고, 그러면 보정이 오지 않는다. 검증되지 않은 예측이 그대로 남는다
그래서 재료가 셋이고, 하나만 빼도 발산이 사라진다:
- Bootstrapping — MC가 아니라 TD
- Function approximation — 여기서는 겨우 linear. state의 값이 공유 parameter들의 겹치는 조합으로 쓰인다는 것뿐
- Off-policy updating — 따르는 policy의 방문 분포가 아니라 모든 state를 균등하게 갱신하는 것
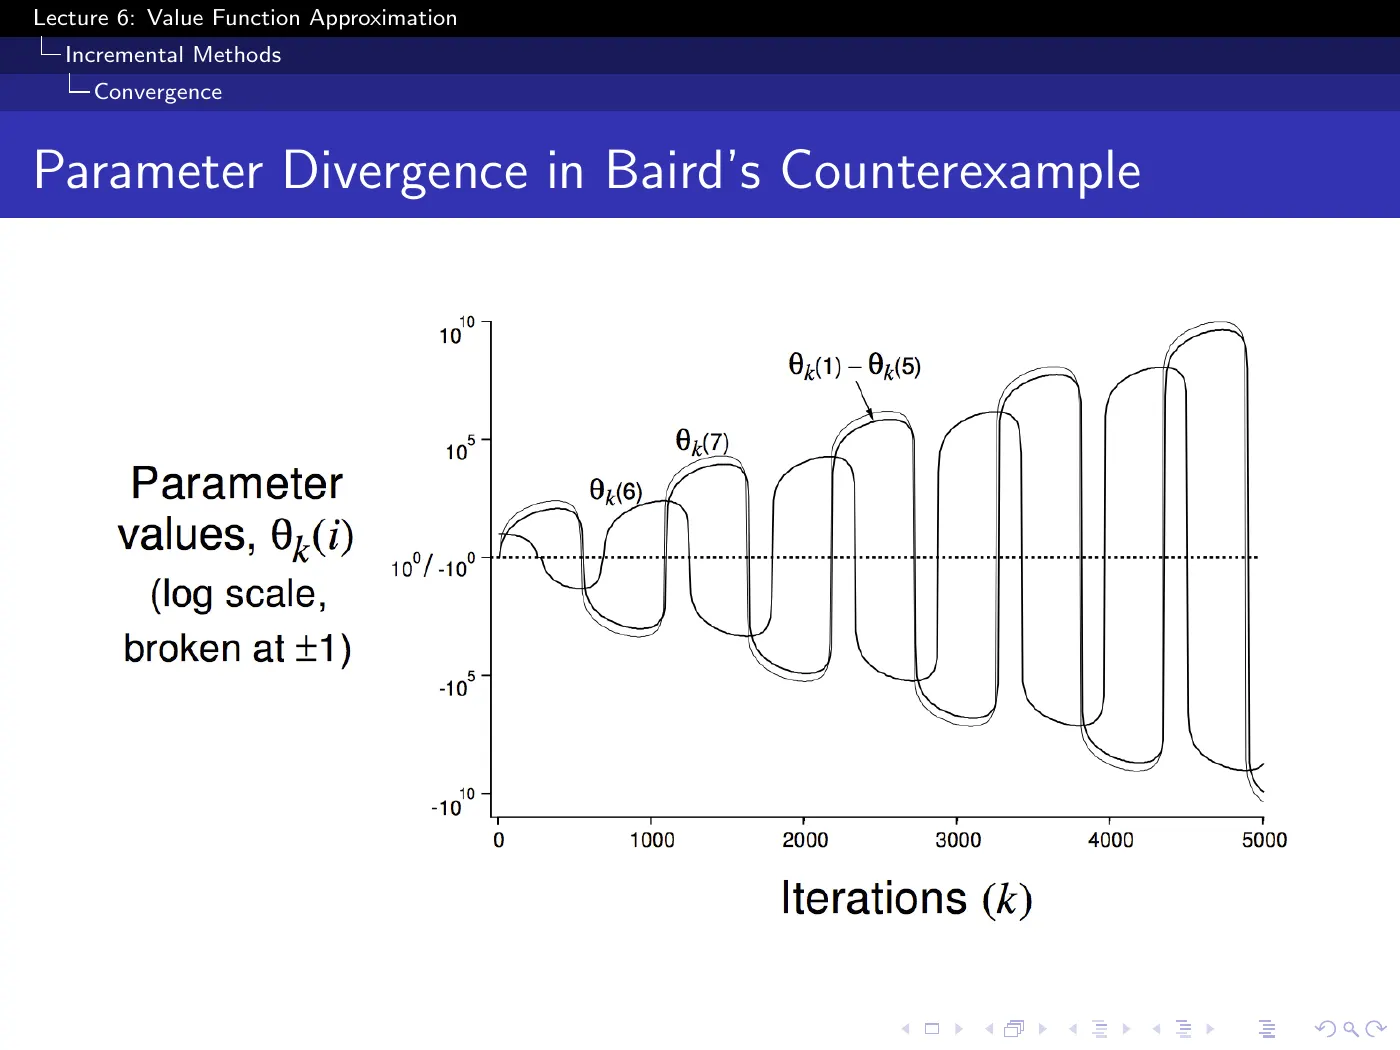
세로축이 로그 스케일이고 에서 끊겨 있다. 곡선은 0 근처에서 진동하는 것이 아니라, parameter가 부호를 바꿔가며 자릿수 단위로 커지고 있다.
MDP는 state 7개에 linear feature다. 반례가 이보다 더 작아질 수 없다는 점이 이 결과의 핵심이다.
이 셋을 이후 문헌에서 deadly triad라고 부른다. Sutton & Barto의 용어(2e §11.3)이며 2015년 이 강의의 용어는 아니다. 현대 deep RL 논문에서 반복해서 등장하는 이름이다. 해당 절에서 가져갈 사실은 두 가지다:
- 셋 중 둘까지는 항상 안전하다. 불안정이 발생하려면 셋이 동시에 있어야 한다. 그래서 triad는 단순한 경고가 아니라 설계 도구다. 무엇을 포기할지 선택하는 기준이 된다
- control과는 무관하다. 불안정은 더 단순한 prediction에서 나타나고, 환경을 완전히 아는 DP 같은 planning method에서도 동일하게 나타난다. 따라서 GPI나 exploration, 환경에 대한 불확실성이 원인이 아니다
p.30 — Convergence of Prediction Algorithms
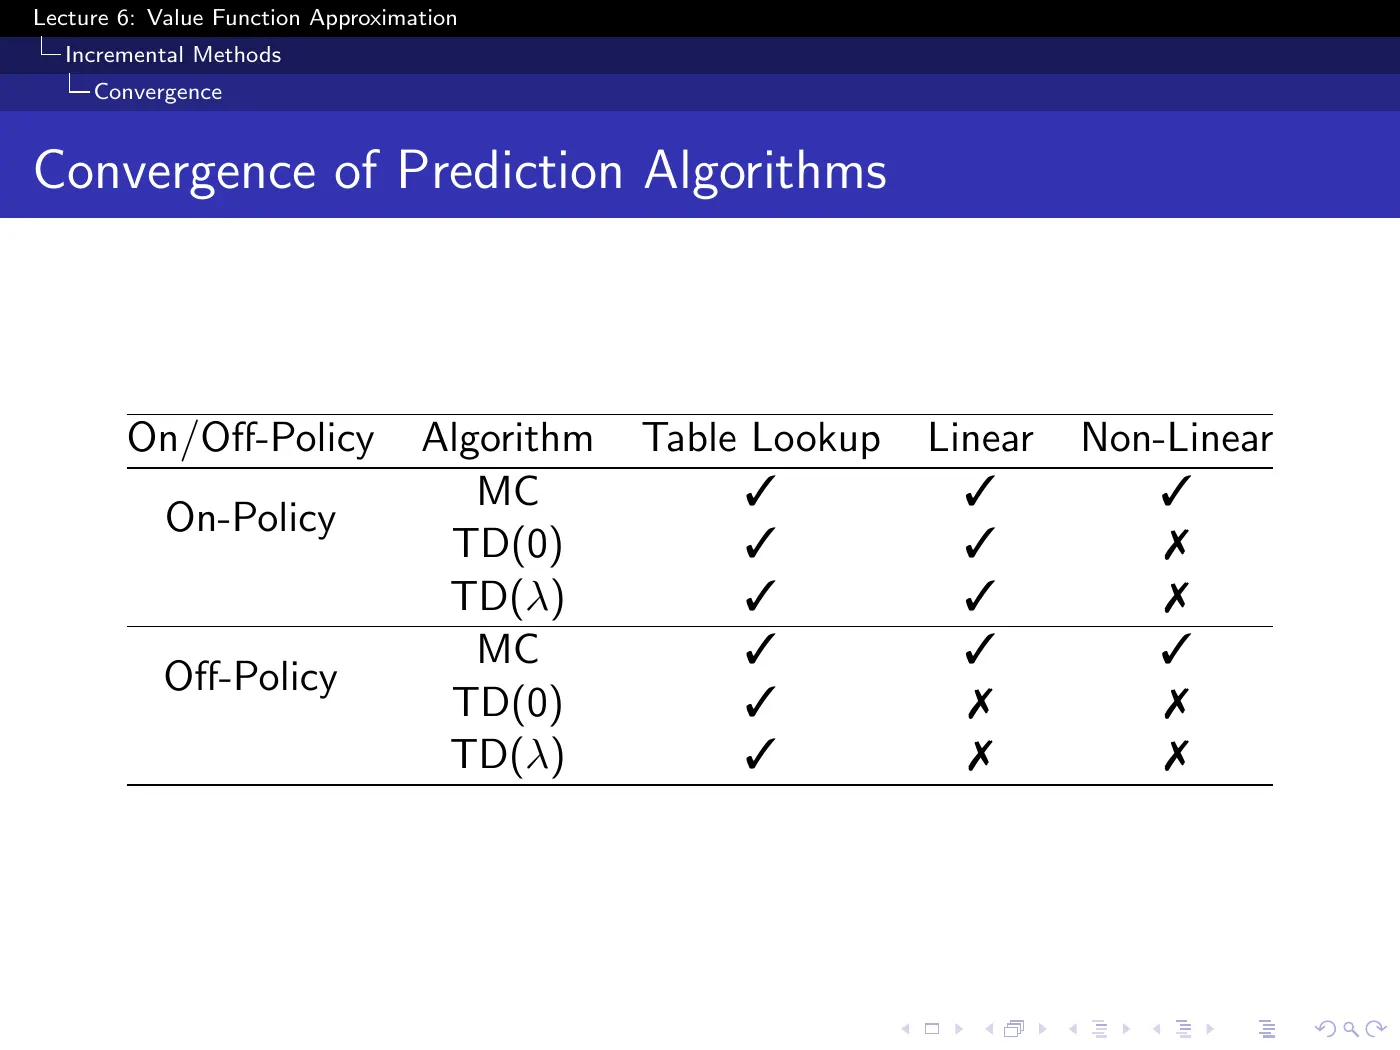
| On/Off-Policy | Algorithm | Table Lookup | Linear | Non-Linear |
|---|---|---|---|---|
| On-Policy | MC | ✓ | ✓ | ✓ |
| TD(0) | ✓ | ✓ | ✗ | |
| TD(λ) | ✓ | ✓ | ✗ | |
| Off-Policy | MC | ✓ | ✓ | ✓ |
| TD(0) | ✓ | ✗ | ✗ | |
| TD(λ) | ✓ | ✗ | ✗ |
12칸을 외울 필요는 없고 패턴만 보면 된다:
- MC 행은 전부 ✓다. target이 에 의존하지 않으므로(p.17) 모든 경우에 SGD가 그대로 성립한다
- 표 안의 모든 ✗는 TD 항목이다. 이 강의의 모든 실패 사례에 bootstrapping이 들어 있다
- Table Lookup 열은 전부 ✓다. 그것이 L1~L5이며, 그동안 문제가 없었던 이유에 대한 사후 설명이다
- TD가 깨지는 경로는 정확히 두 가지다. on-policy인 채로 non-linear로 가거나, linear인 채로 off-policy로 가는 것이다. off-policy 쪽이 더 위험하다. linear 단계에서 이미 깨지기 때문이다
parameter가 fixed point에 도달한다는 뜻일 뿐이다. 그 fixed point가 원하는 지점인지는 별개의 문제다.
여기에는 두 개의 간극이 겹쳐 있고, 체크 표시가 둘 다 가린다:
- 간극 1 — 참 에서 근사기가 표현할 수 있는 최선까지. feature 선택에서 비롯되는 간극이다
- 간극 2 — 그 최선에서 알고리즘이 실제로 도달하는 TD fixed point까지. 알고리즘에서 비롯되며 에 의존한다 (, p.18)
p.31 — Gradient Temporal-Difference Learning
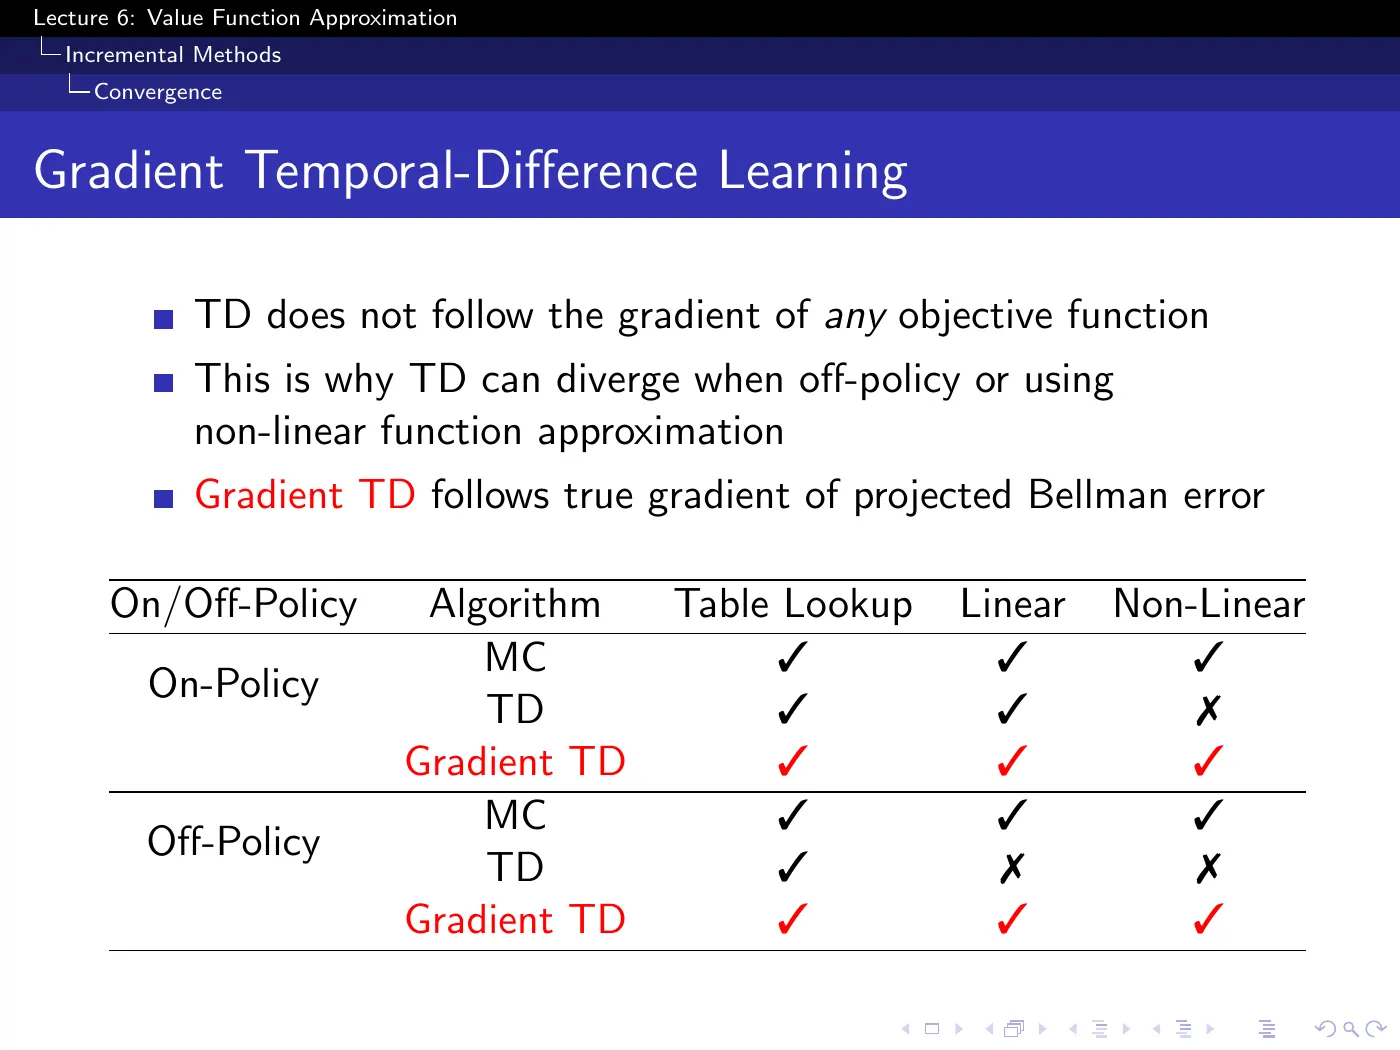
첫 번째 불릿이 이 강의에서 가장 중요한 문장이다.
"TD does not follow the gradient of any objective function."
"TD의 목적함수는 최적화하기 어렵다"가 아니라 목적함수가 존재하지 않는다는 뜻이다.
따라서 "곡면을 내려간다"에 기반한 수렴 논증을 세울 수 없고, 그래서 반례가 성립한다. p.18의 semi-gradient에서 직접 따라 나오는 결과다. 알고리즘을 실용적으로 만들기 위해 항 하나를 버렸는데, 그 항이 gradient라는 성질을 담당하고 있었던 것이다.
Gradient TD는 목적함수를 하나 정의해서 이 문제를 해결한다. projected Bellman error를 정의하고 그것의 실제 gradient를 따라간다. 비용은 보정항 하나가 추가되는 것이고, 결과는 표의 아래 행이다. off-policy non-linear를 포함해 전 칸 ✓다. Emphatic TD도 같은 계열의 방법으로 언급된다. 당시로서는 매우 최근 결과였다.
p.32 — Convergence of Control Algorithms
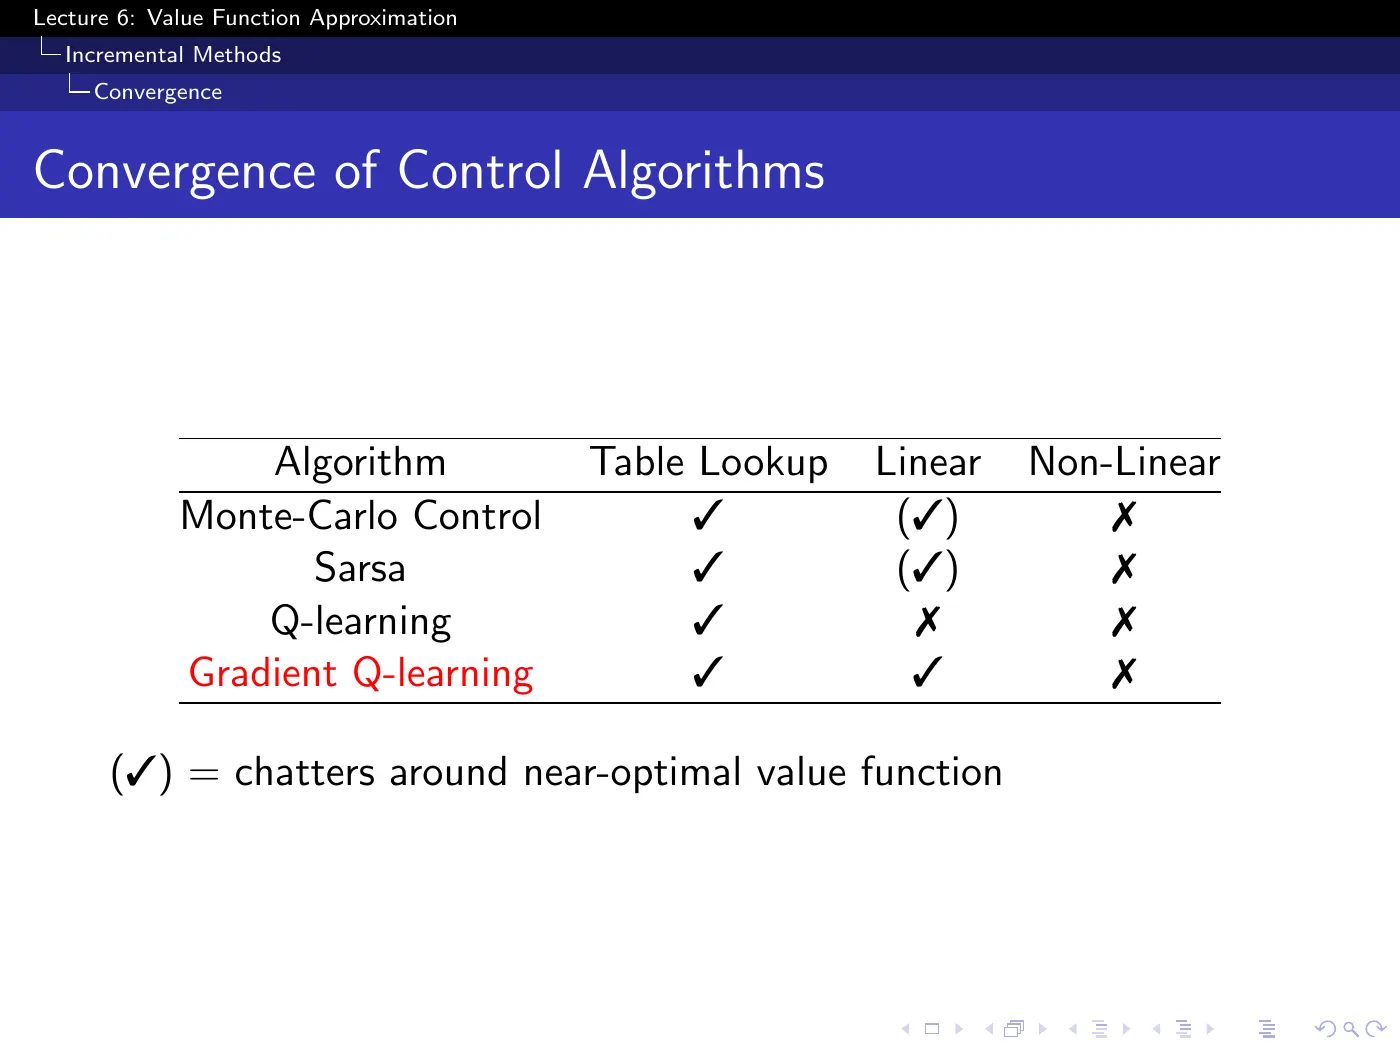
| Algorithm | Table Lookup | Linear | Non-Linear |
|---|---|---|---|
| Monte-Carlo Control | ✓ | (✓) | ✗ |
| Sarsa | ✓ | (✓) | ✗ |
| Q-learning | ✓ | ✗ | ✗ |
| Gradient Q-learning | ✓ | ✓ | ✗ |
control은 prediction보다 상황이 나쁘고, 깨지는 이유도 다르다. 슬라이드는 그 이유를 설명하지 않는다.
- prediction에서의 문제: bootstrap target이 에 의존한다
- control에는 그것 말고 두 번째, 독립적인 실패가 하나 더 있다: improvement step이 더 이상 개선을 보장하지 않는다
L5의 -greedy improvement theorem은 를 정확히 알고 있다고 가정했다. 근사값만 있는 경우, 에 대해 greedy하게 행동하면 실제로 더 나쁜 policy가 나올 수 있다.
그 결과 개선과 후퇴가 반복되며, 최적점 주변의 유계 영역에서 chattering하고 수렴하지 않는다.
두 실패 모드는 기호가 다르다:
| 기호 | 뜻 | 심각도 |
|---|---|---|
| (✓) | 최적점 근처에서 chatter하며 수렴하지 않음 | 대개 수용 가능 |
| ✗ | 파국적 발산이 가능 | 치명적 |
Q-learning은 **linear에서도 ✗**인 반면 Sarsa는 (✓)다. off-policy인 데 따른 차이이며, prediction 표와 같은 패턴이다.
발산이 실제로 문제가 되는 것은 neural network다. 단순한 Q-learning이나 Sarsa를 신경망에 적용하면 상당히 자주 발산한다. 가파른 영역에서 큰 gradient가 나오고 → 큰 step이 policy를 크게 바꾸고 → policy 변화가 value function의 형태를 바꾸고 → 이 과정이 증폭된다.
linear에서는 표에 ✗로 표기된 off-policy에서조차 실무적으로는 대체로 잘 동작한다. 발산시키려면 상당히 의도적으로 조건을 맞춰야 한다. ✗는 빈도가 아니라 가능성을 표시한다.
이 비대칭을 기억해둘 것. 바로 다음 섹션이 이 표에서 가장 나쁜 칸에 해당하는 시스템을 만들어 실제로 동작시키기 때문이다.
§6 · Batch Methods (slides p.34–37)
여기서 강의가 후반부로 넘어간다. 지금까지는 전부 "한 step 관측하고, 조금 움직이고, 버린다"는 방식이었다.
p.34–35 — Batch Reinforcement Learning
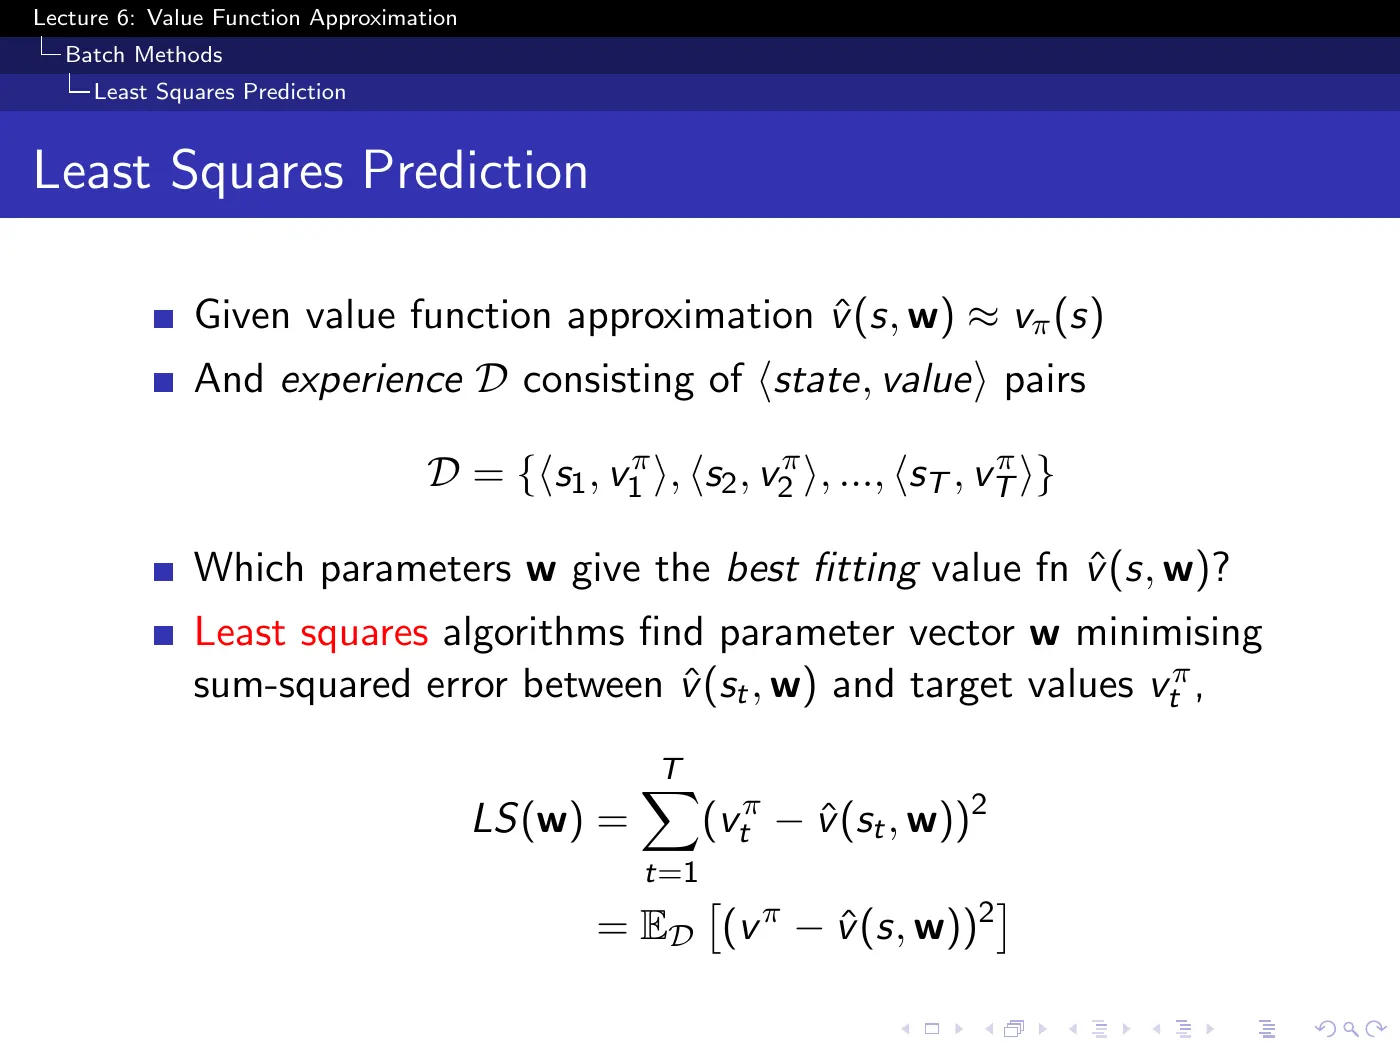
슬라이드가 지적하는 문제: "Gradient descent is simple and appealing. But it is not sample efficient."
전반부 방식의 문제는 transition을 한 번 관측하고, 작은 step을 한 번 적용하고, 데이터를 버린다는 점이다.
경험을 얼마든지 만들 수 있으면 문제가 되지 않는다. 그렇지 않으면 심각한 낭비다. 로봇의 경험에는 실제 시간과 하드웨어 마모라는 비용이 든다. 시뮬레이터가 아닌 실물에서는 그 비용이 그대로 발생한다.
그래서 batch method는 질문을 바꾼다. "지금까지 모은 경험 전체에 가장 잘 맞는 value function은 무엇인가?"
가 또 나온다. 여전히 모르는 값이고, p.44에서 다시 대체된다.
확인할 것은 가 로 바뀌었다는 점 하나다. policy를 따라 이동하며 생기는 분포에서 모아둔 데이터셋의 분포로 바뀐 것이고, 이것이 batch method의 핵심이다.
p.36–37 — SGD with Experience Replay
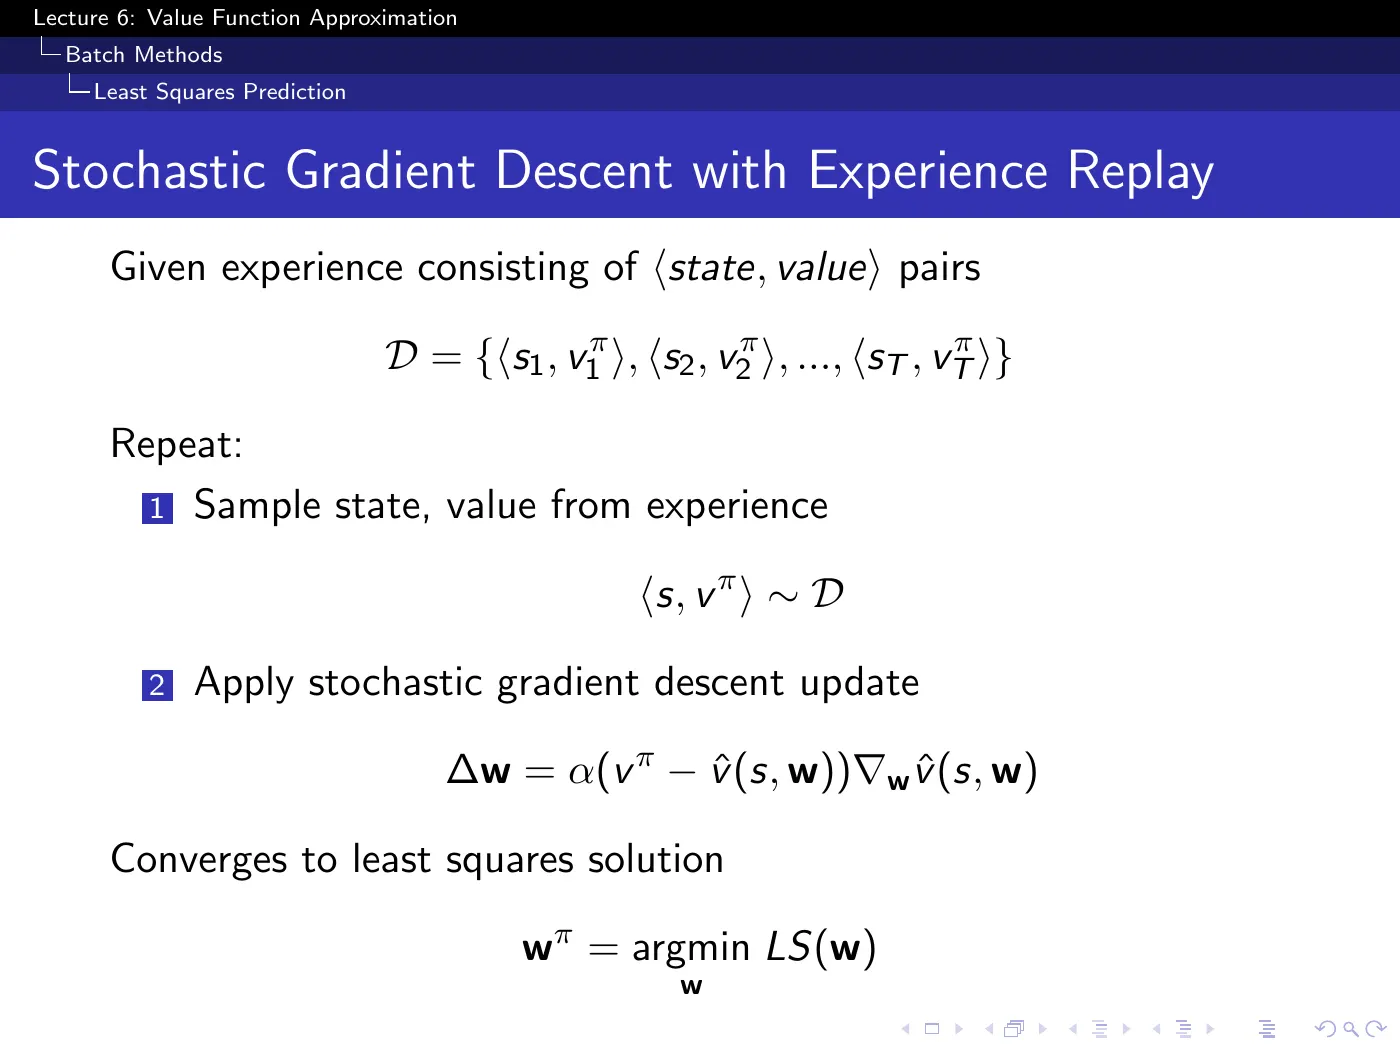
알고리즘 전체:
- 저장된 경험에서 를 무작위로 하나 뽑는다
- SGD 업데이트를 한다:
- 반복
그러면 least squares 해로 수렴한다: .
p.12의 SGD 업데이트를 그대로, 저장된 데이터셋에 무작위 순서로 반복 적용하는 것이다. 학습 규칙 자체는 전혀 바뀌지 않는다.
바뀌는 것은 어떤 데이터를 어떤 순서로 넣느냐뿐이다.
이름 때문에 새로운 기법처럼 보이지만 그렇지 않다. 이 점을 기억하면 다음 섹션의 DQN이 훨씬 단순하게 읽힌다.
얻는 것은 두 가지이고, 중요한 쪽은 두 번째다:
- Sample efficiency — transition 하나를 여러 번 재사용한다. 이미 비용을 치른 데이터를 더 활용하는 것이다. 수렴할 때까지 반복하면 least squares 해에 정확히 도달한다
- Decorrelation — 버퍼에서 균등 무작위로 추출하면 궤적의 순서가 사라진다. 이것이 p.9의 non-i.i.d. 문제에 대한 직접적인 답이고, replay가 단지 학습을 저렴하게 만드는 데 그치지 않고 신경망을 안정화시키는 이유다
§7 · DQN (slides p.38–41)
p.38 — Experience Replay in Deep Q-Networks
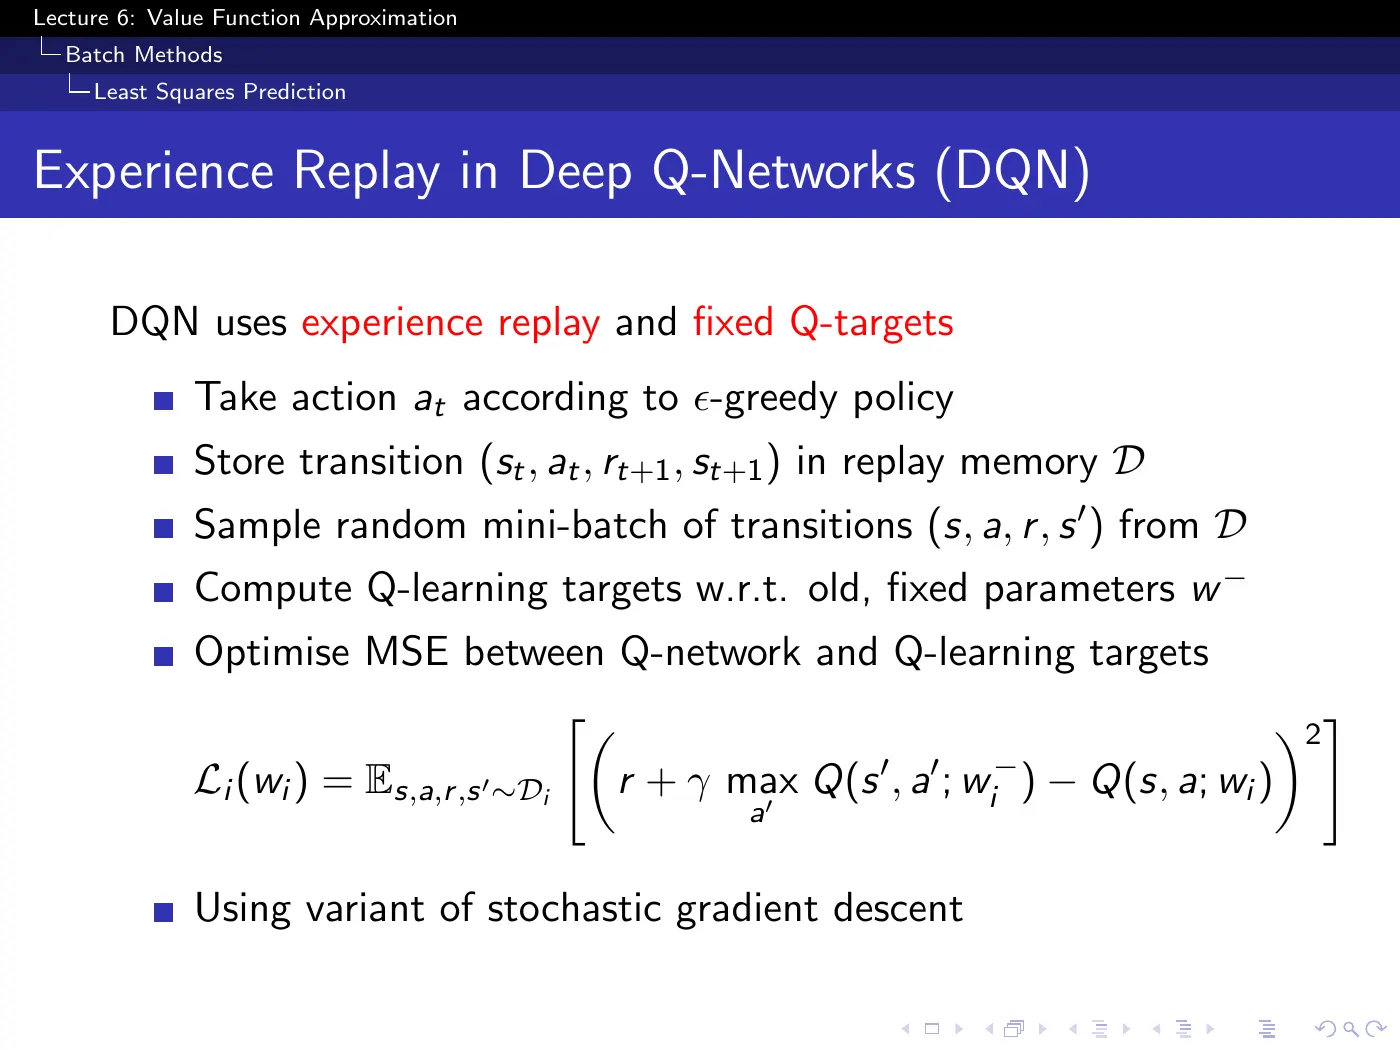
off-policy (Q-learning) + bootstrapping + non-linear approximation, 즉 deadly triad의 세 조건 전부에 해당한다. p.32 control 표의 ✗✗ 위치다.
두 기법은 부수적인 엔지니어링이 아니다. 그 칸을 발산에서 state-of-the-art로 바꾼 요인이고, 각각이 p.9에서 이미 지목된 두 문제 중 하나씩을 겨냥한다.
기법 1 — experience replay: 연속된 업데이트 사이의 상관을 제거한다 → non-i.i.d. 대응
기법 2 — fixed Q-targets: 예측과 그 예측이 추종하는 대상 사이의 결합을 끊는다 → non-stationarity 대응
이 점을 놓치면 슬라이드의 요지를 놓치게 된다.
는 수천 step 전에 복사해 고정해둔 것이고, 는 현재 학습 중인 것이다.
둘이 같다면 모든 업데이트가 예측과 동시에 목표까지 움직이게 된다. non-linear approximator에서는 이 피드백 루프가 발산의 원인이 된다.
를 고정하면 각 구간이 stationary target에 대한 supervised learning과 정확히 같아진다. 수천 step마다 로 복사하고 다음 구간을 시작한다. 교체 주기는 튜닝된 hyperparameter이며 50개 게임 전부에 동일한 스케줄을 사용했다. 부드럽게 추종하는 변형도 가능하지만 논문 실험은 hard switching을 썼다.
Silver는 이 방식이 되살린 기존 아이디어의 이름을 언급한다. fitted Q-iteration이다.
p.39 — DQN in Atari
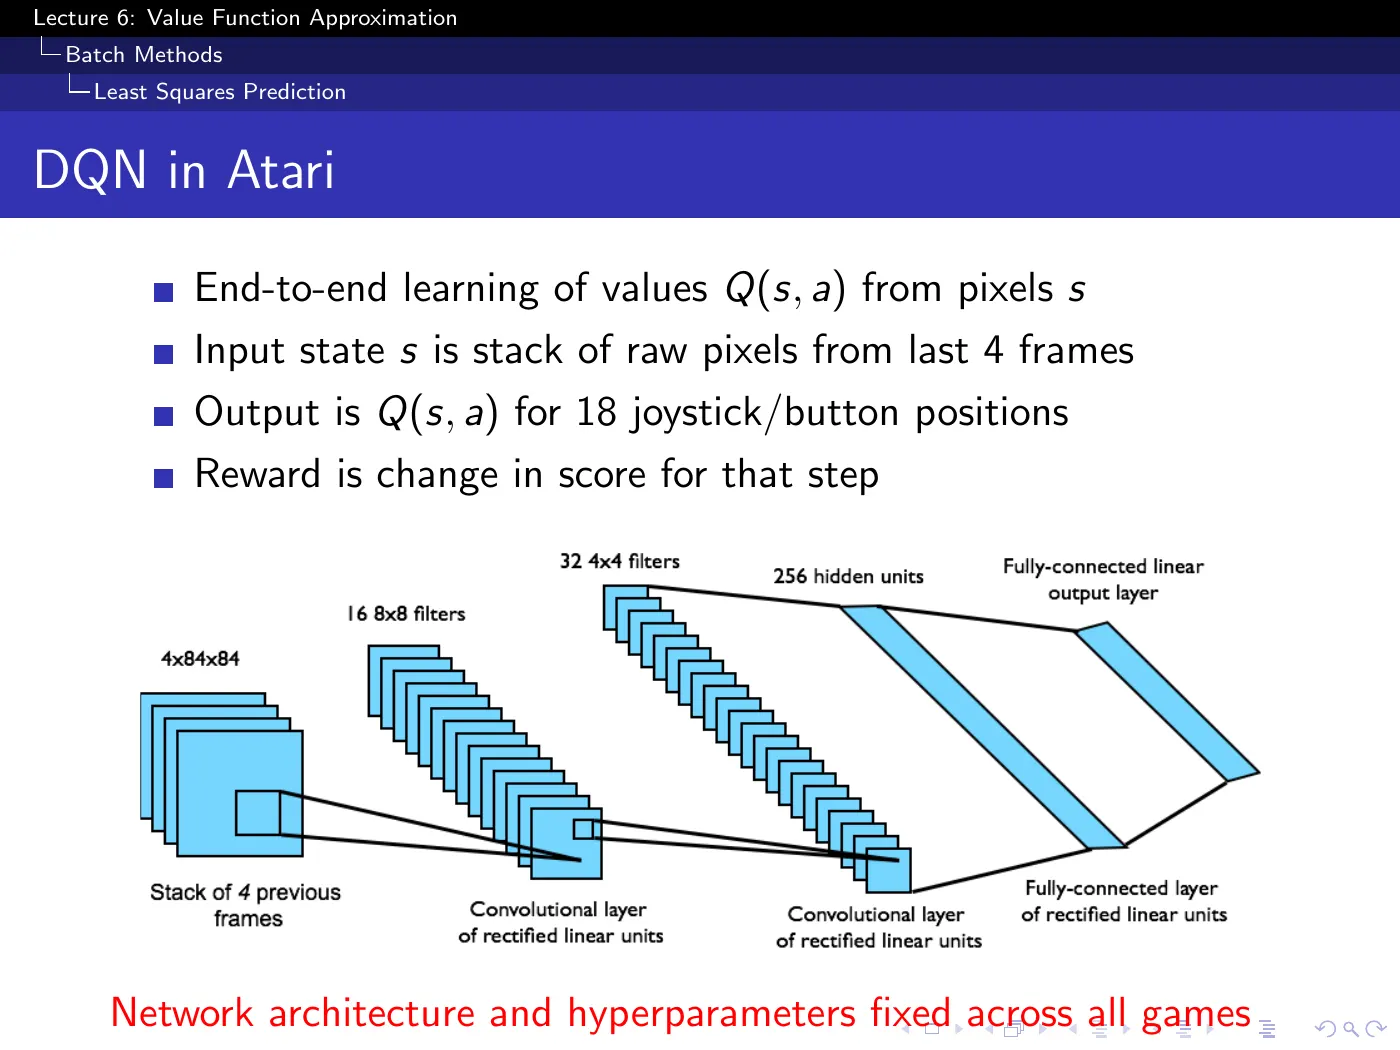
- 픽셀 에서 까지 end-to-end 학습
- 입력: 마지막 4 프레임의 raw pixel stack
- 출력: 조이스틱/버튼 18개 위치에 대한
- reward: 그 step의 점수 변화량
- 네트워크 구조와 hyperparameter를 모든 게임에 고정
구조는 p.7의 action-out 설계다. forward pass 한 번으로 Q값 18개를 출력하므로 매 프레임 를 감당할 수 있다.
Atari 프레임 한 장은 Markov state가 아니다. 이미지 한 장으로는 공의 진행 방향을 알 수 없다.
마지막 4프레임을 쌓으면 velocity를 관측할 수 있을 만큼의 정보가 복원되고, 그때서야 이 강의 전체가 전제하는 MDP 형식화가 성립한다.
이는 네트워크 구조에 관한 결정이 아니라 state를 정의하는 결정이다. 잘못 정하면 그 위의 모든 논의가 무효가 되는 종류의 결정인데, 슬라이드는 구현 세부사항처럼 한 줄로 적고 있다.
p.40–41 — Results and Ablation
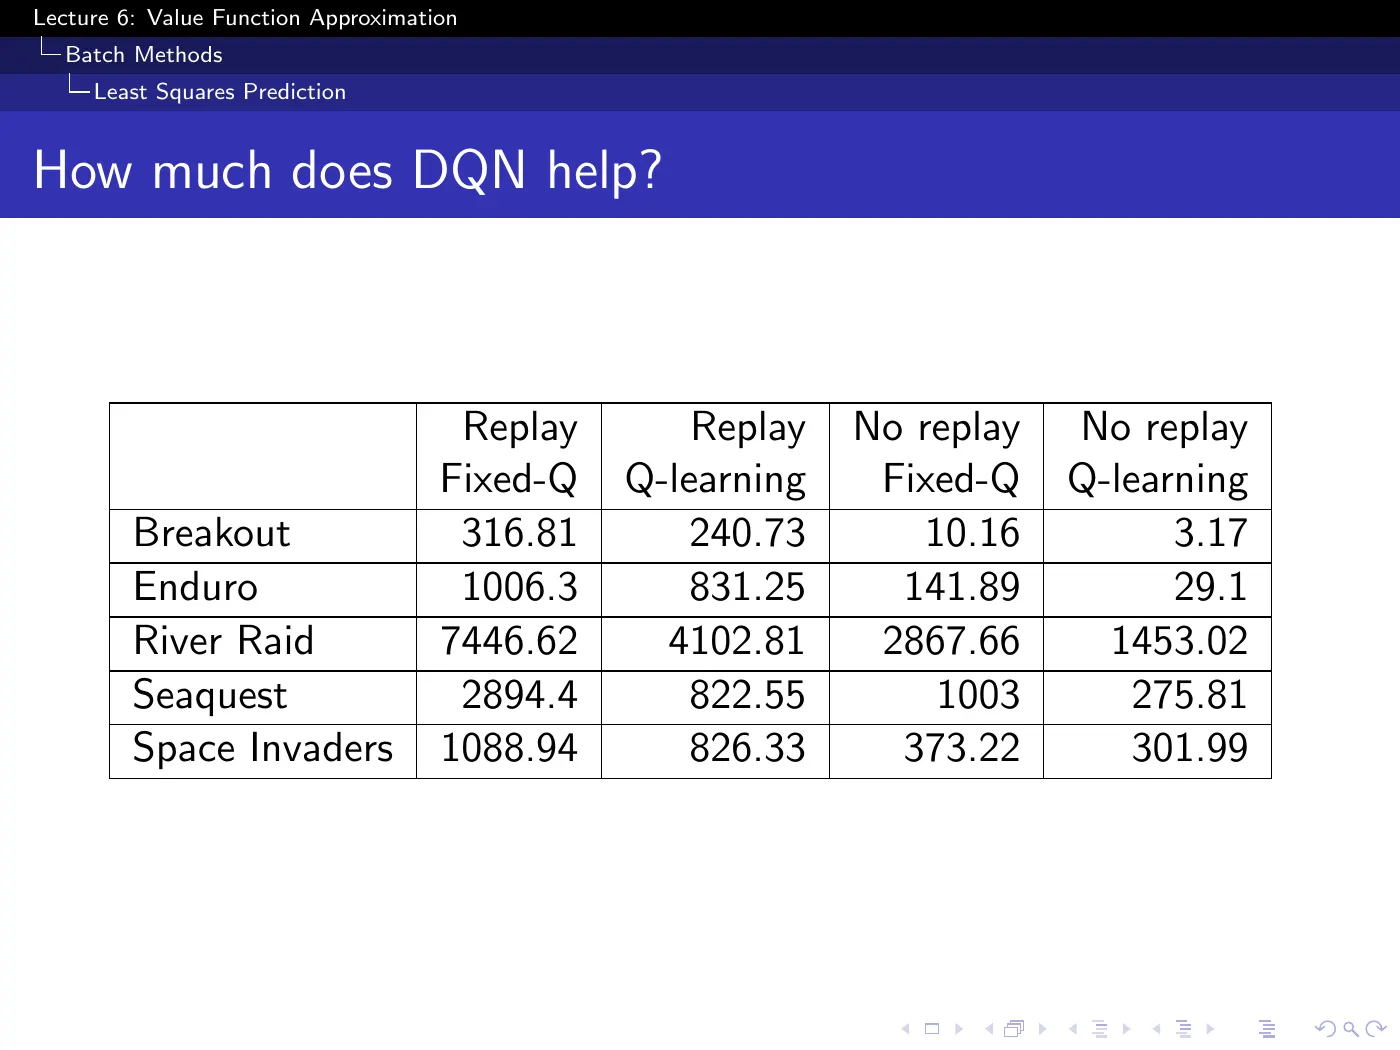
| Replay + Fixed-Q | Replay + Q-learning | No replay + Fixed-Q | No replay + Q-learning | |
|---|---|---|---|---|
| Breakout | 316.81 | 240.73 | 10.16 | 3.17 |
| Enduro | 1006.3 | 831.25 | 141.89 | 29.1 |
| River Raid | 7446.62 | 4102.81 | 2867.66 | 1453.02 |
| Seaquest | 2894.4 | 822.55 | 1003 | 275.81 |
| Space Invaders | 1088.94 | 826.33 | 373.22 | 301.99 |
ablation이다. 둘 다 효과가 있고 함께 쓰면 더 좋아지지만, 기여도는 크게 다르다. replay 쪽이 지배적이다.
Breakout에서 replay를 제거하면 316.81 → 10.16으로 약 31배 떨어진다. fixed-Q만 제거하면 약 24% 감소한다. 다섯 게임 모두 같은 순서다.
p.40에서는 게임들이 인간 전문가 대비 성능으로 정렬되어 있다. 그런데 상위보다 하위 쪽이 더 중요하다:
점수가 거의 0이다. 실패 원인은 표현력이 아니다. 네트워크는 Video Pinball에서 인간을 이기고 있는 것과 동일하다.
이 게임은 reward가 나타나기 전에 올바른 action이 길게 이어져야 한다. 그리고 -greedy exploration에는 그것을 달성할 메커니즘이 없다. policy를 무작위로 흔들어서 100 step짜리 계획에 도달할 수는 없다.
L6는 이 문제를 다루지 않는다. L6는 value function을 어떻게 표현할지에 대한 강의이지, 표현할 가치가 있는 경험을 어떻게 찾을지에 대한 강의가 아니기 때문이다. 그것은 L9의 주제다.
§8 · 닫힌 형태 최소제곱 (slides p.42–55)
p.42–43 — Linear Least Squares Prediction
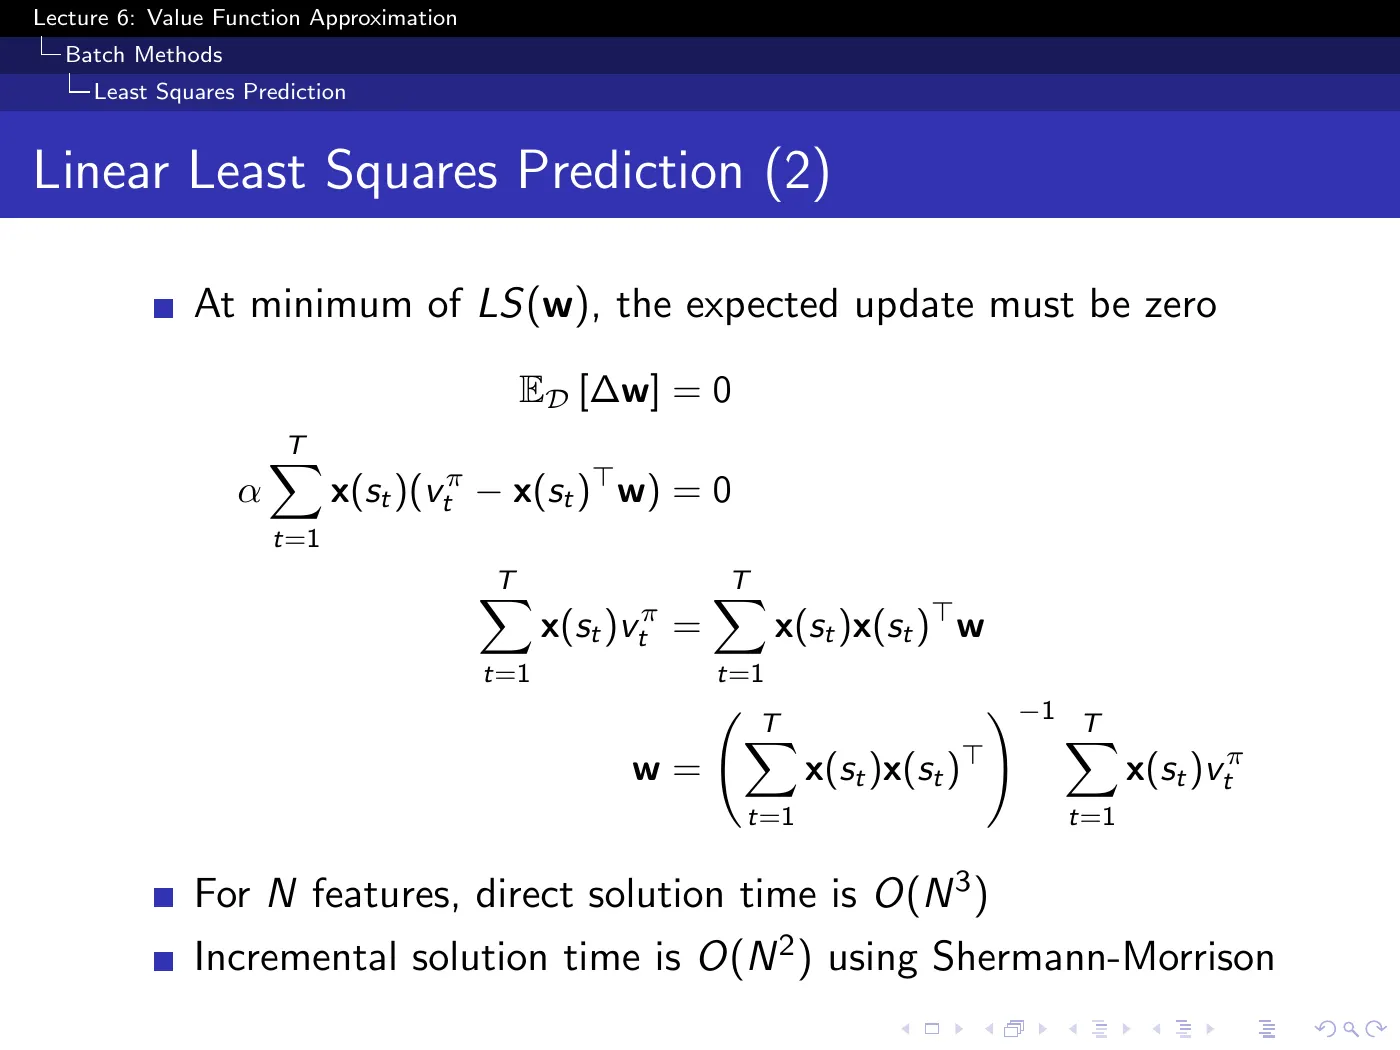
출발점: experience replay는 least squares 해를 찾아주지만 반복이 많이 필요할 수 있다. linear approximation이면 직접 풀 수 있다.
유도는 아이디어 하나로 진행된다. least squares 최소점에서는 를 더 이상 바꿀 이유가 없다. 그러므로 전체 업데이트를 0으로 놓고 푼다.
이후는 전부 항 정리이며, 를 포함하는 항이 하나뿐이라는 점이 핵심이다.
슬라이드가 언급하지 않고 넘어가는 두 가지:
(1) 가 소거된다. 식 전체에 곱해져 있는데 그 전체를 0으로 놓으므로 step size가 답에 영향을 주지 않는다. 튜닝할 learning rate가 존재하지 않는다. 실무적으로 의미 있는 이점이다.
(2) 은 feature 개수이지 state 개수가 아니다. 직접 풀면 , Sherman-Morrison을 써서 incremental하게 하면 다.
강의 내내 matrix inversion을 피해왔다. 비용이 에 따라 커졌기 때문이다.
여기서는 그렇지 않다. 비용이 state 개수와 무관해졌고, 그것이 이 섹션이 성립하는 유일한 근거다.
replay와의 trade-off는 상황에 따라 갈린다. feature가 적고 경험이 길면 닫힌 형태가 유리하고, feature가 많으면 replay가 유리하다. 실무적으로는 데이터를 대여섯 번 반복하면 대부분의 정보를 이미 활용하게 된다.
p.44–46 — LSMC, LSTD, LSTD(λ)
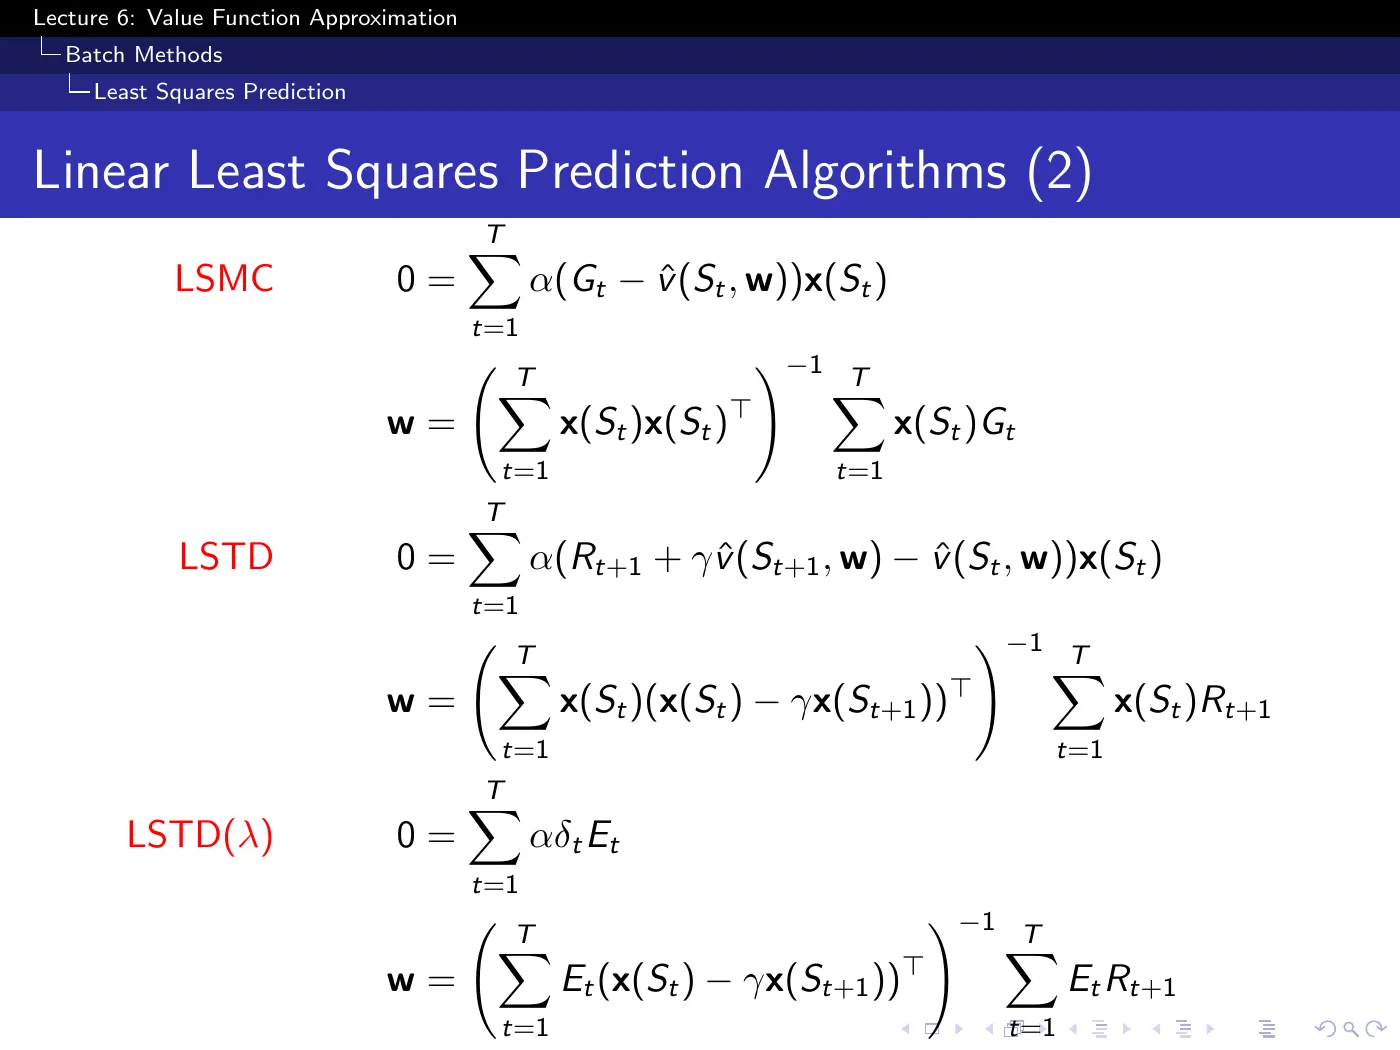
p.35에서 남겨둔 oracle 가정을 p.16과 동일한 대입으로 해소한다 — , 또는 , 또는 .
LSMC가 역행렬을 취하는 대상은 이다. outer product이므로 symmetric이고, 통상적인 least-squares design matrix다.
LSTD가 역행렬을 취하는 대상은 이다. target이 다음 state의 feature를 참조하므로 symmetric이 아니다.
이 비대칭성은 bootstrapping에서 나온다. incremental 설정에서 "업데이트가 어떤 목적함수의 gradient도 아니다"(p.31)라고 말했던 그 비대칭이, 여기서는 covariance가 아닌 행렬의 형태로 나타난다.
같은 사실의 두 표현이다. 이 대응이 보이면 §3과 §8이 하나로 연결된다.
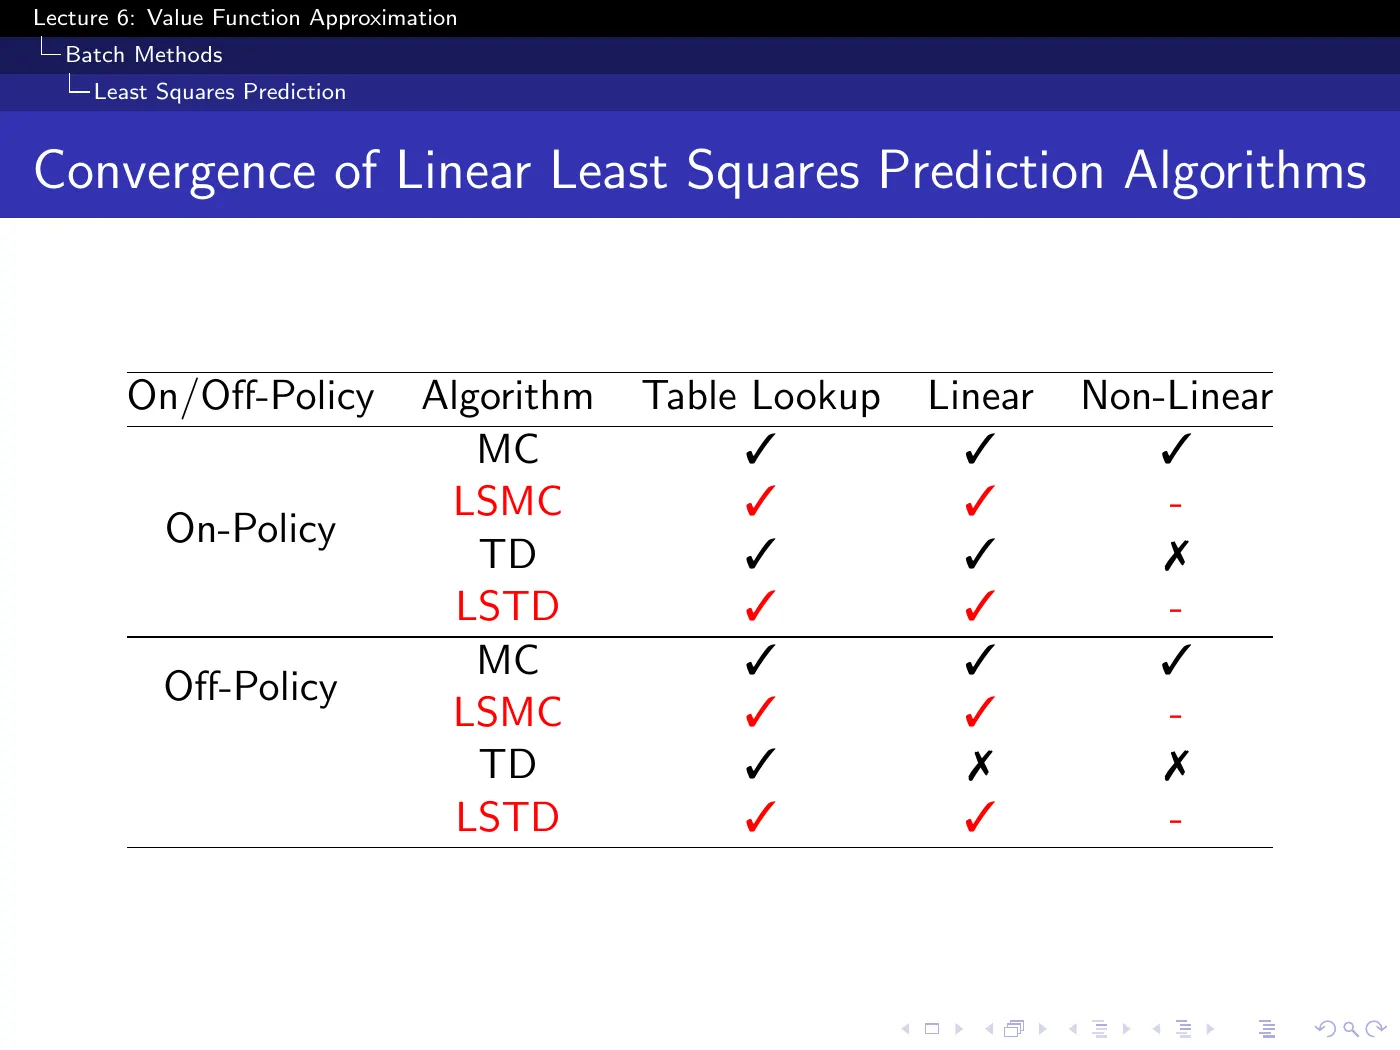
| On/Off-Policy | Algorithm | Table Lookup | Linear | Non-Linear |
|---|---|---|---|---|
| On-Policy | MC / LSMC | ✓ | ✓ | ✓ / – |
| TD | ✓ | ✓ | ✗ | |
| LSTD | ✓ | ✓ | – | |
| Off-Policy | MC / LSMC | ✓ | ✓ | ✓ / – |
| TD | ✓ | ✗ | ✗ | |
| LSTD | ✓ | ✓ | – |
핵심은 이 행이다. LSTD는 off-policy에서 수렴한다. incremental TD는 linear feature로도 ✗인 자리다.
fixed point를 직접 풀면 incremental 버전을 불안정하게 만드는 메커니즘 자체를 거치지 않기 때문이다. (Non-Linear 열의 "–"는 해당 없음이라는 뜻이다. 이 방법들은 linear에서만 정의된다. 닫힌 형태는 linearity에서 나오는 성질이기 때문이다.)
p.47과 p.52 — Least Squares Policy Iteration
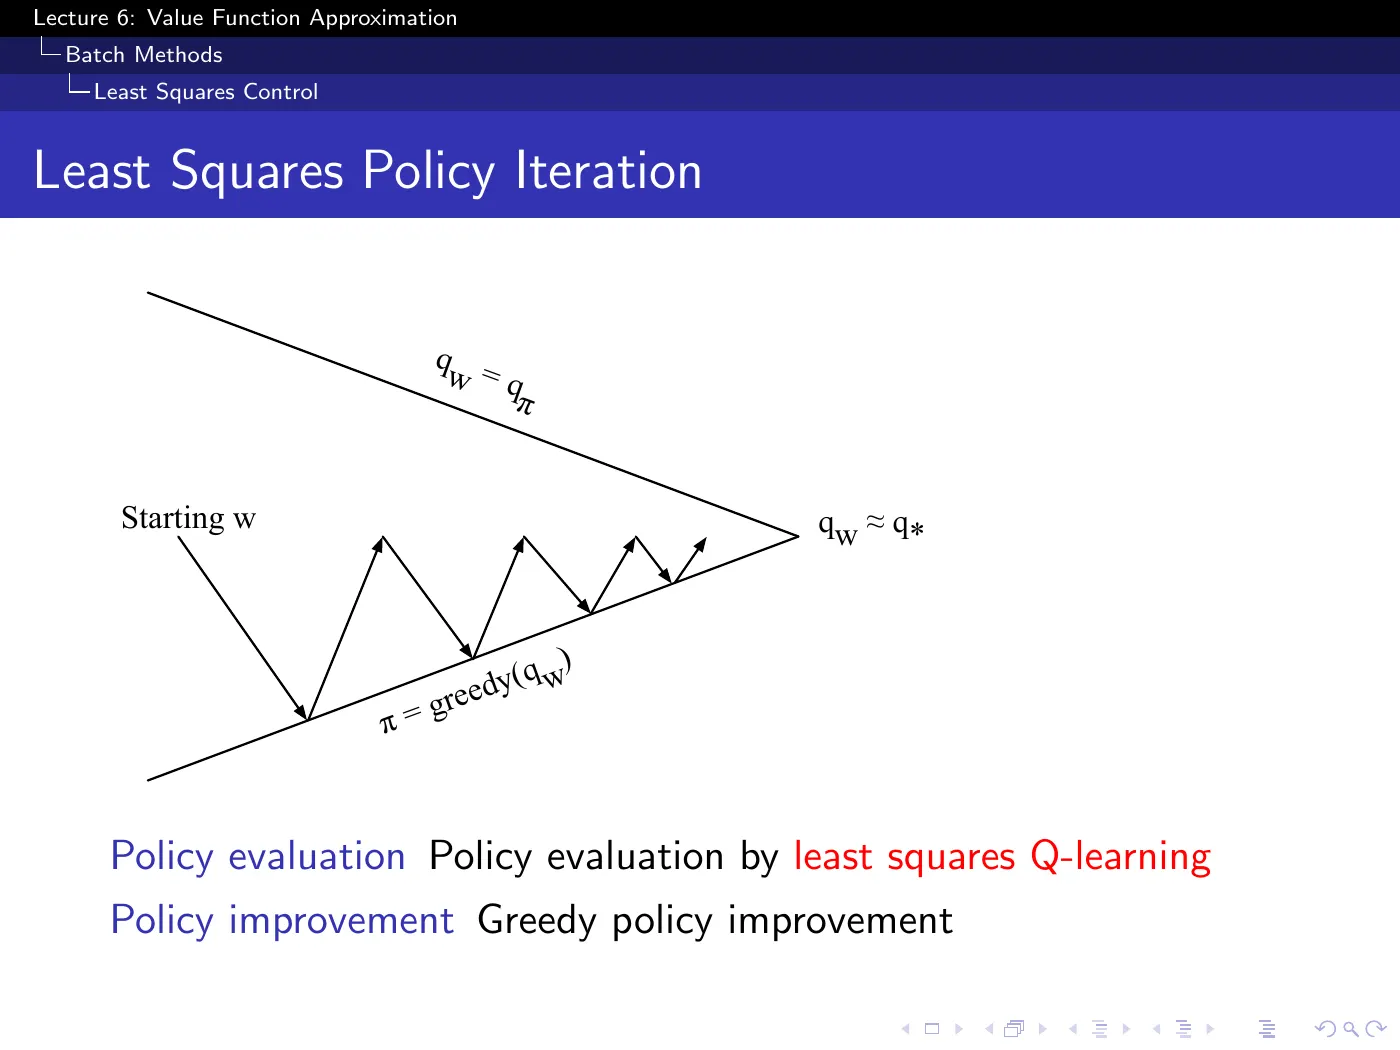
다시 GPI 구조이며, evaluation 자리에 LSTDQ가 들어간다. p.21과 한 가지가 다른데, 짚고 갈 만하다.
p.21에서는 exploration을 improvement step에 포함시켜야 했다. 개선된 policy가 다음 데이터를 생성하기 때문이다. exploration이 없으면 데이터가 편향된다.
LSPI에서는 batch 가 미리 고정되어 있다. chain walk 예제는 random walk 10,000 step을 쓰고 추가로 수집하지 않는다.
따라서 exploration이 improvement와 분리되고, improvement는 순수 greedy여도 된다.
대신 첫 번째 이후의 모든 evaluation이 구조적으로 off-policy가 된다. 데이터가 현재 평가 대상이 아닌 policy들에서 나왔기 때문이다. 이것이 가능한 이유는 LSTD가 off-policy에서 수렴하기 때문(p.46)이다. 앞 표의 그 한 칸이 여기서 근거가 된다.
그럼에도 control은 여전히 수렴하지 않는다. p.52에서 LSPI는 Monte-Carlo control, Sarsa와 함께 **(✓)**로 분류된다. 동일하게 chatter한다.
evaluation을 정확히 푸는 것은 evaluation만 해결한다. p.32의 실제 진단이었던 **"근사 하에서는 improvement step을 신뢰할 수 없다"**는 문제는 그대로 남는다.
p.48–51 — 강의가 건너뛴 네 장
강의가 시간 부족으로 LSPI 다이어그램에서 chain walk로 바로 넘어가며 명시적으로 건너뛴 슬라이드들이다. 내용은 least-squares control이 왜 off-policy여야 하는지에 대한 논증과 LSTDQ 유도다.
논지는 p.49에 있고 짧다:
- evaluation에서는 모든 경험을 효율적으로 쓰고 싶다
- control에서는 policy도 개선하고 싶다
- 그 경험은 여러 policy에서 나왔다
- 따라서 를 평가하려면 off-policy로 배울 수밖에 없다
- 해법은 Q-learning과 같은 아이디어다: batch에서 를 가져오되, 새 policy가 취했을 action 쪽으로 bootstrap한다
LSTD 식과 나란히 놓고 보면 차이는 하나뿐이다. 자리에 가 들어갔다. "다음 state의 feature"에서 "다음 state에서 새 policy가 선택할 action의 feature"로 바뀐 것이다. off-policy 성질이 식 안에서 정확히 이 자리에 들어 있다.
p.51의 pseudocode가 요점을 분명히 한다. 매 iteration마다 같은 가 LSTDQ에 전달된다. 그것이 이 알고리즘의 핵심이다.
function LSPI-TD(D, π₀)
    π' ← π₀
    repeat
        π ← π'
        Q ← LSTDQ(π, D)              ← 같은 D를 매번 다시 쓴다
        for all s ∈ S do
            π'(s) ← argmax_a Q(s, a)
        end for
    until (π ≈ π')
    return π
end function
p.53–55 — Chain Walk
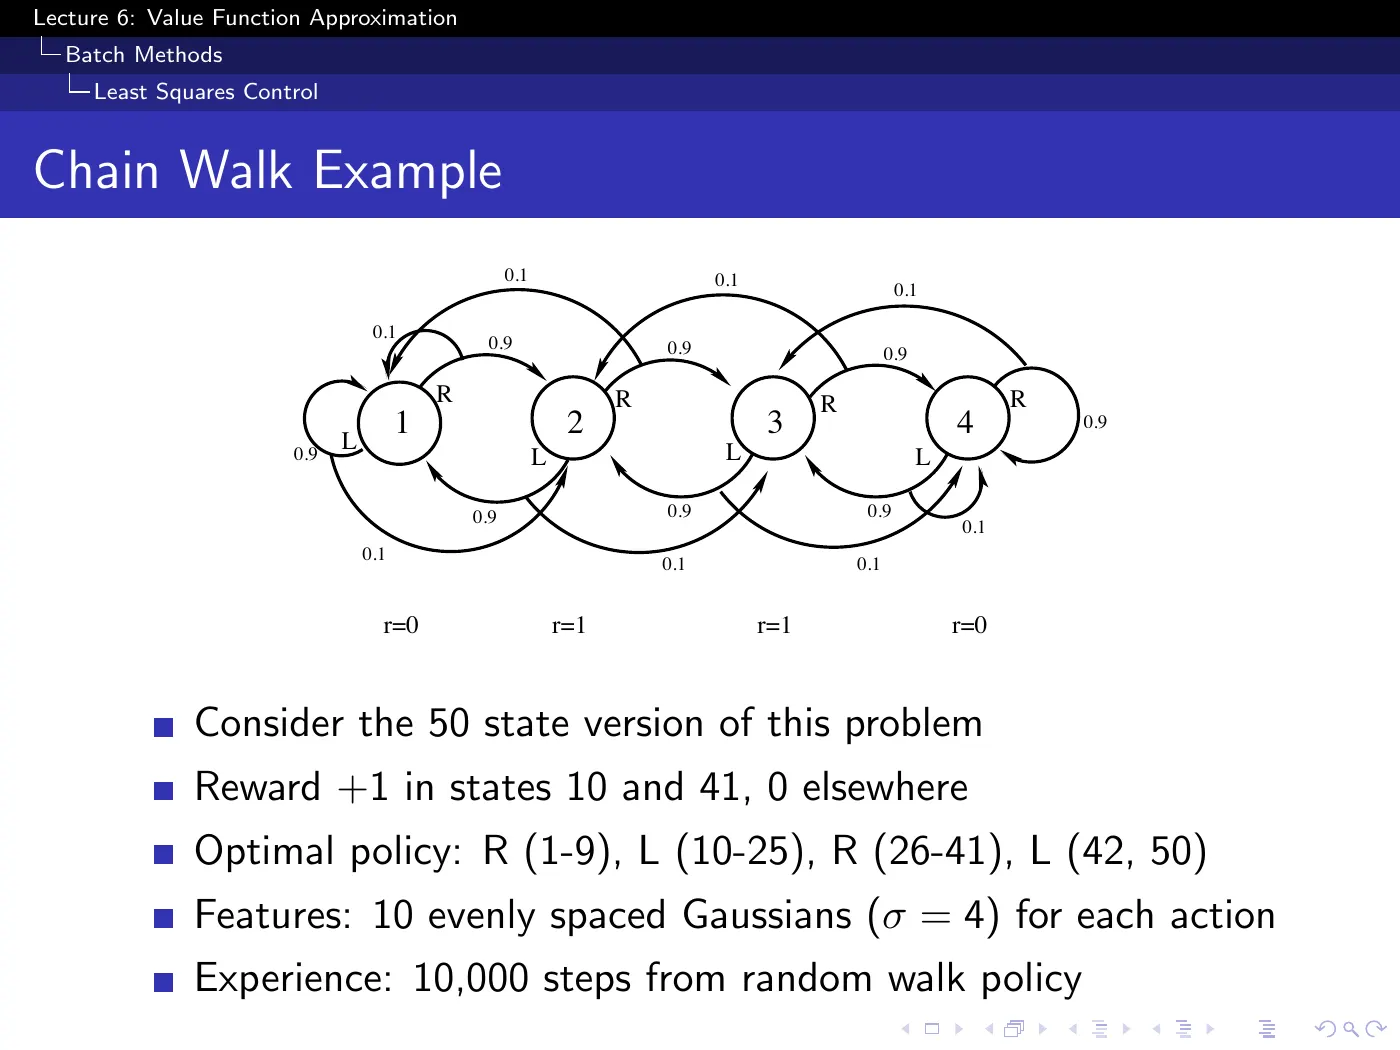
설정: 일렬로 늘어선 state 50개. reward는 state 10과 41에서만 , 나머지는 0. action마다 균등 간격 Gaussian 10개 (). 경험은 random walk policy로부터 10,000 step, 한 번만.
최적 policy는 슬라이드에 R(1–9), L(10–25), R(26–41), L(42–50)로 적혀 있는데, 이 형태로는 외우기 어렵다. **"둘 중 더 가까운 reward state 쪽으로 향한다"**로 읽으면 자명해진다.
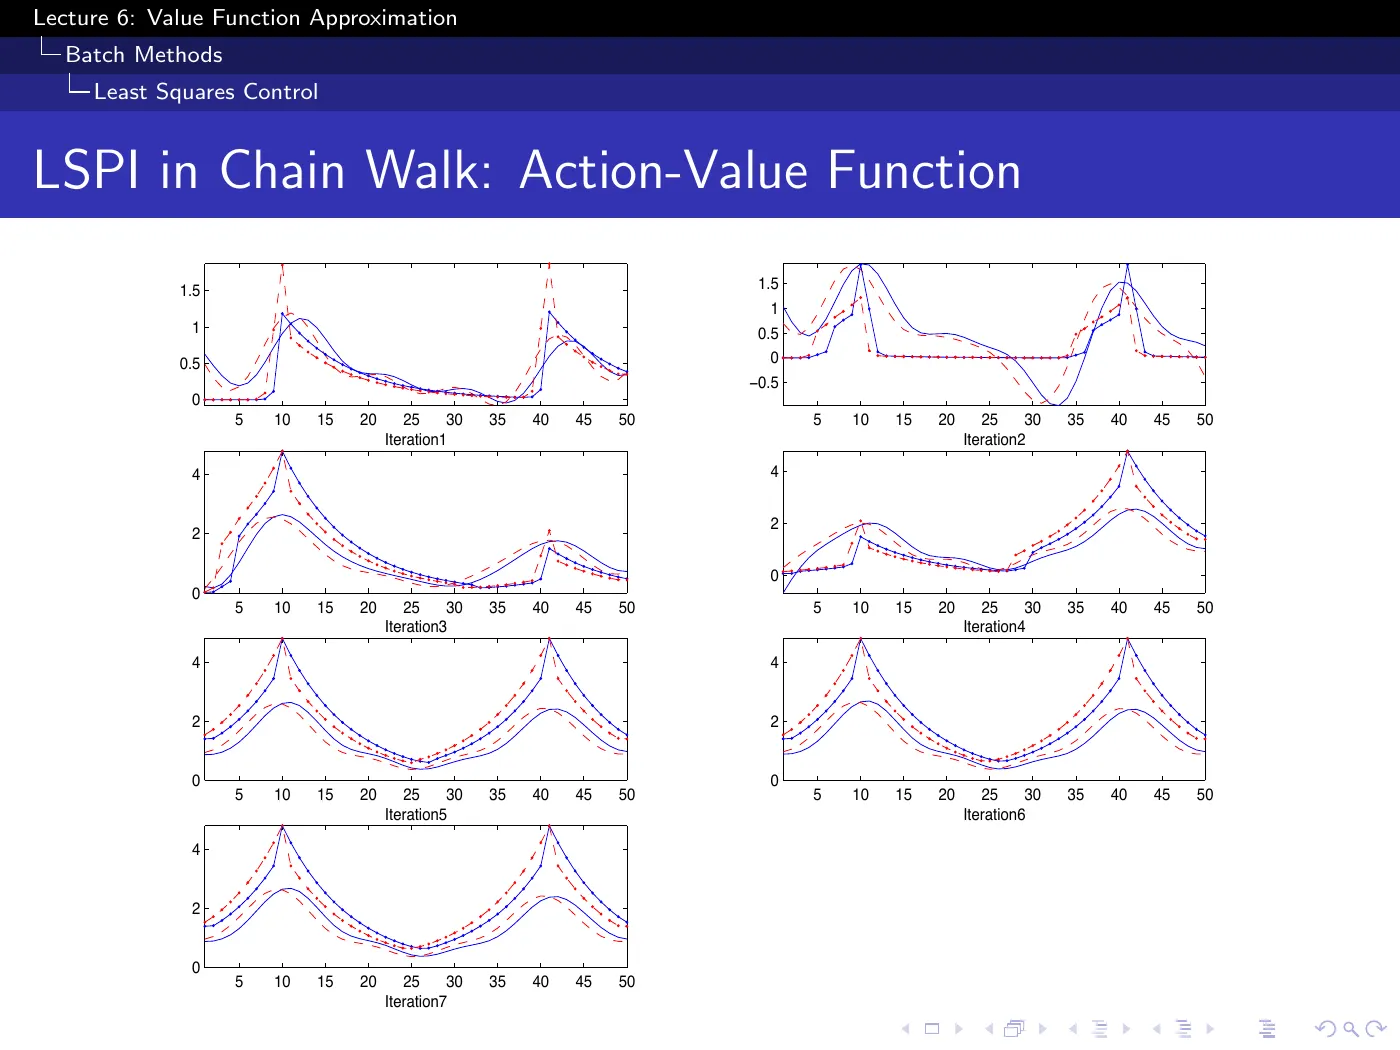
실선이 LSPI 근사, 점선이 정확한 값. 파랑·빨강이 두 action.
같은 10,000개의 transition이 매 iteration마다 다시 평가된다. 새 경험은 한 번도 수집되지 않는다.
policy iteration 7회 전부가 하나의 고정된 batch에서 나온 결과다. 그것이 "sample efficient"의 구체적인 의미다.
봉우리가 뾰족하지 않고 넓은 데에는 서로 독립적인 두 가지 이유가 있고, 혼동하기 쉽다:
- value가 discounting을 통해 사슬을 따라 실제로 퍼진다 — 실제 현상이다
- RBF 근사기가 그 위에서 매끄럽게 만든다 — 근사에 의한 artifact다
둘째만 artifact이므로, 그림을 볼 때 이 둘을 구분해야 한다.
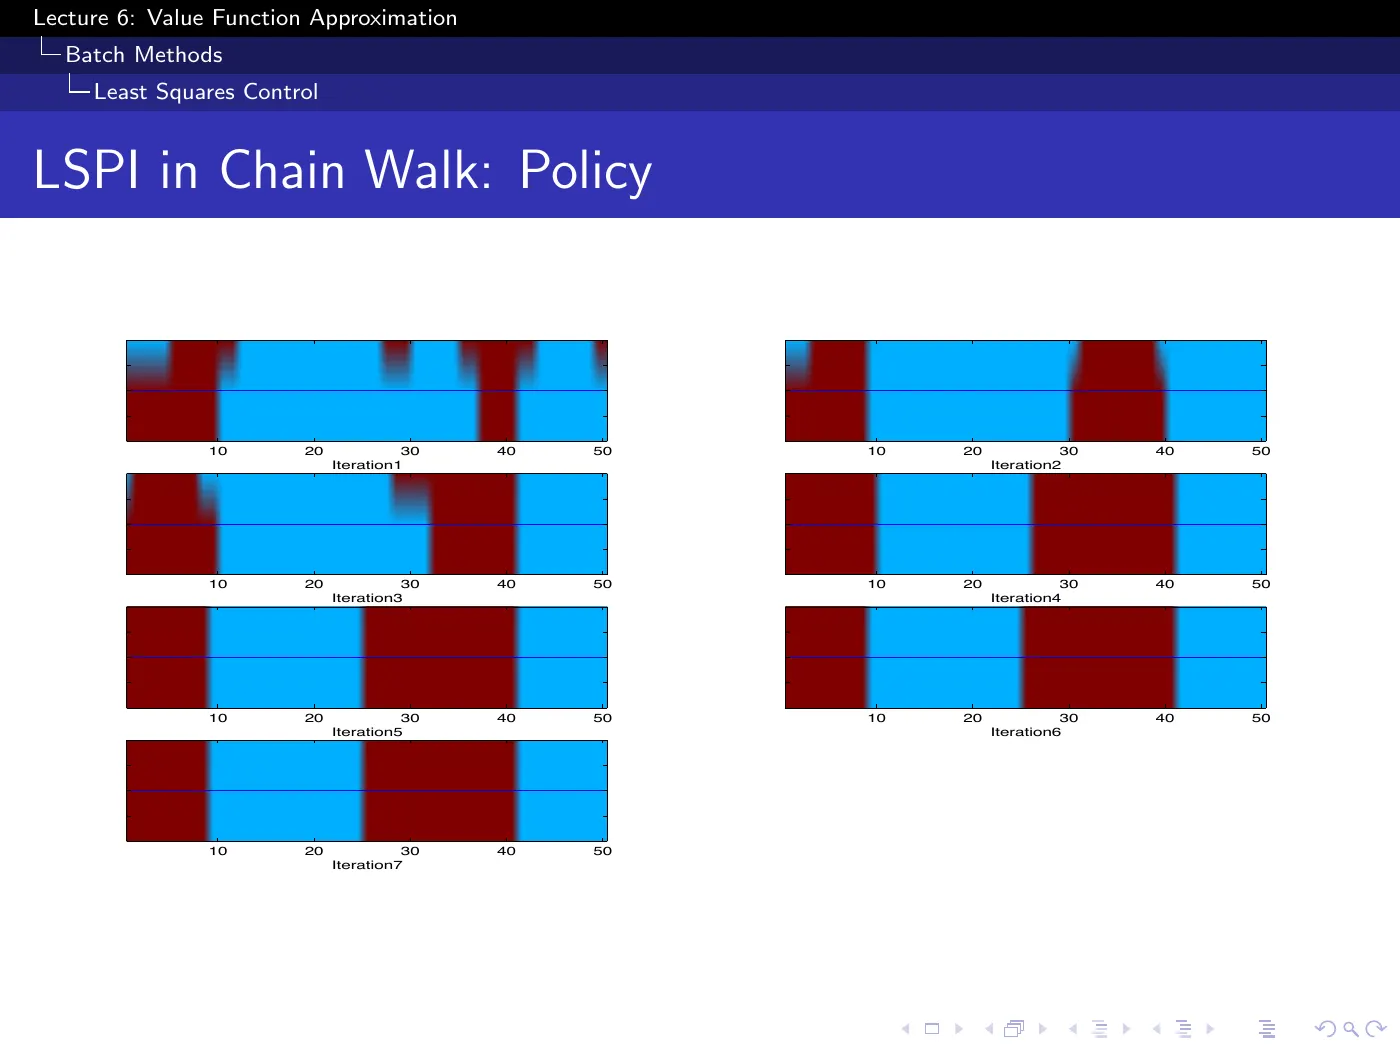
policy plot은 iteration 7쯤에 수렴한다. 그리고 value function이 수렴해 보이는 시점보다 결정이 먼저 정확해진다. 는 크기가 아니라 순서만 맞으면 되기 때문이다.
실무적으로 유용한 감각이다. value가 아직 거칠어 보여도 policy는 이미 옳을 수 있다.
다 읽고 남는 지도
L6 전체를 한 장으로 압축하면 다음과 같다.
1. 새로운 학습 원리는 없었다. MC, TD, TD(λ), Sarsa, Q-learning 전부 L4~L5와 동일하다. 표현만 바뀌었다.
2. 표현이 바뀌면서 깨진 것은 정확히 하나다. target이 에 의존하게 된 것이고, 나머지는 전부 여기서 파생된다:
target이 에 의존한다 → semi-gradient가 된다 → 내려갈 목적함수가 없다 → 발산이 가능하다.
3. MC는 이 연쇄의 첫 단계에서 빠진다. 는 를 사용하지 않으므로 모든 표에서 MC 행이 ✓다. 그러나 variance 때문에 실무에서는 밀린다(p.27). 이것이 L6의 중심 트레이드오프다.
4. deadly triad = bootstrapping + function approximation + off-policy. 둘까지는 안전하고 셋이 모이면 위험하다. 무엇을 포기할지 정하는 설계 도구로 쓸 것.
5. DQN은 셋을 모두 켠 채로 두 가지 보완책을 더한 것이다. replay(non-i.i.d.)와 fixed target(non-stationary)이다. 우아한 해법은 아니지만 동작한다.
6. control은 prediction보다 한 단계 더 어렵다. evaluation을 정확히 풀어도(LSPI) chatter가 남는다. 근사 하에서는 improvement step 자체가 보장을 잃기 때문이다.
스스로 채워야 할 구멍 (강의가 안 다룬 것)
- Gradient TD와 emphatic TD — 이름만 나오고 projected Bellman error나 보정항의 유도가 없다. off-policy + non-linear 환경에서 작업할 계획이라면 여기가 가장 큰 공백이다. Sutton & Barto 2e Ch. 11이 정식 처리이고, §11.3의 "triad 중 무엇을 포기할 것인가" 논증부터 읽는 편이 낫다
- Feature discovery — 명시적으로 범위 밖이다. 좋은 feature가 주어진다고 가정한다. 강의가 제시하는 방향은 "neural network를 쓰라"이고, 그래서 L6의 non-linear 열이 현대 연구가 실제로 다루는 영역이다
- DQN reward clipping — 슬라이드는 "reward는 그 step의 점수 변화"라고 하면서 동시에 "hyperparameter 하나로 50개 게임 전부"를 처리했다고 한다. 게임마다 점수 스케일이 자릿수로 다르므로 두 진술이 그대로 양립하기 어렵다. Nature 논문에서 reward가 어떻게 정규화되었는지 확인할 것. 이 강의에는 나오지 않는다
다음
- L7 Policy Gradient — L6에서 두 번 예고되었다. continuous action에서 가 optimization이 되는 문제(p.26)와, action-out이 discrete action set을 요구하는 제약(p.7)이다. 둘 다 policy를 직접 파라미터화하면 해소된다
- L9 Exploration and Exploitation — Montezuma's Revenge가 남긴 문제
- 본 노트 Study checklist의 12문항을 노트 없이 답해볼 것. 이 문서를 읽었다면 답할 수 있어야 한다
관련 페이지
Model-Free Prediction · Forward and Backward Views of TD Lambda · Importance Sampling in Off-Policy RL · Markov Decision Process (MDP) · Model-Free vs Model-Based RL · David Silver · Learning Log