시리즈: Kalman Filtering · 이전: L1 · 다음: L3
이 강의는 posterior estimate가 dynamics를 통과해 다음 prior가 되는 과정을 유도합니다. Mean은 model을 따라 이동하고, covariance는 linear transformation과 process noise를 함께 반영합니다.
형광펜: 정의·핵심 · 메커니즘·직관 · 조건·주의
목차
1. Posterior에서 prior로
시각 k−1의 posterior가
xk−1∣y1:k−1∼N(x^k−1+,Pk−1+)
라고 하겠습니다. 다음 dynamics는
xk=Akxk−1+Bkuk+wk
입니다. 현재 measurement yk를 아직 받지 않았으므로, 목표는 p(xk∣y1:k−1)의 mean과 covariance입니다.
Prediction은 새 evidence를 사용하는 단계가 아닙니다. 이전 posterior를 process model로 한 step 밀어 다음 prior를 만드는 단계입니다.
2. Mean prediction
Conditional expectation의 linearity를 사용합니다.
x^k−=E[xk∣y1:k−1]=E[Akxk−1+Bkuk+wk∣y1:k−1]=AkE[xk−1∣y1:k−1]+Bkuk+E[wk∣y1:k−1]=Akx^k−1++Bkuk(prior mean definition)(dynamics substitution)(linearity)(zero-mean independent noise).
따라서
x^k−=Akx^k−1++Bkuk
입니다. Mean prediction은 deterministic state-space model의 한-step simulation과 같은 형태입니다.
3. Prediction error
Posterior error와 prior error를
ek−1+=xk−1−x^k−1+,
ek−=xk−x^k−
로 정의합니다. Dynamics와 mean prediction을 빼면
ek−=Akxk−1+Bkuk+wk−(Akx^k−1++Bkuk)=Ak(xk−1−x^k−1+)+wk=Akek−1++wk(definitions)(term cancellation)(posterior error definition).
Prediction uncertainty에는 이전 estimation error가 dynamics를 따라 변형된 부분과 이번 step에 새로 들어온 process noise가 함께 들어갑니다.
4. Covariance propagation
Prior covariance의 정의에 prediction error를 대입합니다.
Pk−=E[ek−ek−⊤∣y1:k−1]=E[(Akek−1++wk)(Akek−1++wk)⊤∣y1:k−1]=AkPk−1+Ak⊤+AkE[ek−1+wk⊤]+E[wkek−1+⊤]Ak⊤+Qk=AkPk−1+Ak⊤+Qk(covariance definition)(error substitution)(expansion)(independence).
따라서
Pk−=AkPk−1+Ak⊤+Qk
입니다. Cross terms가 사라지는 이유는 단순히 noise mean이 0이어서가 아니라 wk와 이전 estimation error가 uncorrelated이기 때문입니다.
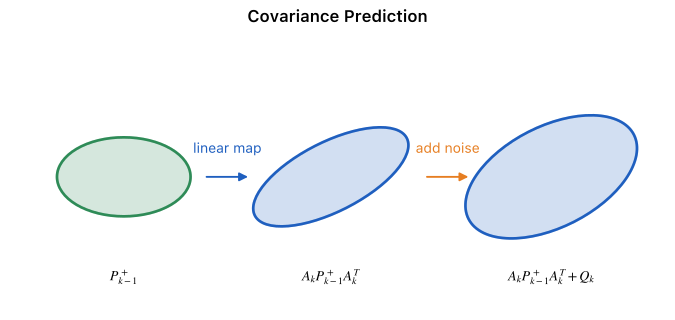
The linear map changes the orientation and scale of uncertainty; process noise then adds covariance in the directions represented by Qk.
5. Process noise covariance
Qk는 한 step 동안 model에 나타나지 않은 disturbance가 state에 추가하는 covariance입니다.
Qk=Cov(wk).
예를 들어 1D constant-velocity state x=[p,v]⊤에 random acceleration ak가
wk=Gkak
형태로 들어오면
Qk=GkVar(ak)Gk⊤
입니다. 즉 Qk의 off-diagonal entry는 임의로 넣는 장식이 아니라 같은 disturbance가 position과 velocity error를 동시에 만들기 때문에 생깁니다. 구체적인 discretization은 L6 §2에서 다룹니다.
Known deterministic input uk는 mean을 Bkuk만큼 이동시키지만 covariance를 직접 늘리지 않습니다. Input 값에 uncertainty가 없다고 conditioning했기 때문입니다.
Input uncertainty가 δuk로 존재하고
Cov(δuk)=Uk
이며 다른 error와 independent라면 covariance에는
BkUkBk⊤
가 추가됩니다. 이를 무시하고 input을 exact로 취급하면 Pk−가 실제 uncertainty를 과소평가할 수 있습니다.
7. Bayes filter prediction과의 대응
일반 Bayes filter prediction은
p(xk∣y1:k−1)=∫p(xk∣xk−1,uk)p(xk−1∣y1:k−1)dxk−1
입니다. Linear-Gaussian model에서는 integrand의 두 distribution이 Gaussian이고 적분 결과도 Gaussian입니다. 위에서 유도한 x^k−와 Pk−는 이 적분 결과의 parameters입니다.
따라서 Kalman prediction은 Bayes prediction의 근사가 아니라, 일반 prediction 식을 linear-Gaussian case에서 exact하게 계산한 결과입니다.
8. Dimension과 단위 검사
Matrix 식은 dimension과 physical unit로 빠르게 검사할 수 있습니다.
| 항 |
Dimension |
단위 예시 |
| Pk−1+ |
n×n |
state unit의 outer product |
| AkPk−1+Ak⊤ |
n×n |
state unit의 outer product |
| Qk |
n×n |
state unit의 outer product |
| Pk− |
n×n |
state unit의 outer product |
Position–velocity state에서는 covariance matrix의 diagonal 단위가 각각 m2와 m2/s2이고, cross-covariance의 단위는 m2/s입니다. 모든 entry가 같은 단위를 가져야 하는 것은 아닙니다.
이해 확인
1. Mean prediction에는 Qk가 직접 나타나지 않지만 covariance prediction에는 나타나는 이유를 설명하시오.
2. Pk−=AkPk−1+Ak⊤+Qk의 cross terms가 사라지는 데 필요한 조건을 쓰시오.
3. Known input과 uncertain input이 covariance에 미치는 영향의 차이를 설명하시오.
4. Kalman prediction이 일반 Bayes-filter prediction integral과 어떤 관계인지 설명하시오.
답
1. Process noise가 zero mean이면 conditional mean에는 기여하지 않지만, 그 variance는 새로운 uncertainty이므로 covariance에 Qk로 더해집니다. → §2 · §4
2. 현재 process noise wk와 이전 posterior error ek−1+가 uncorrelated이어야 합니다. 표준 model에서는 independence가 이를 보장합니다. → §4
3. Conditioning 시점에 정확히 아는 input은 mean만 이동시킵니다. Input error가 random이면 그 covariance가 BkUkBk⊤ 형태로 추가됩니다. → §6
4. Linear-Gaussian assumptions 아래에서 Bayes prediction integral의 Gaussian parameters를 닫힌 형태로 계산한 결과입니다. → §7