Kalman Filtering·Lecture 7 of 7
L7 · Riccati, Observers, and LQG
시리즈: Kalman Filtering · 이전: L6 · concept: LQR and the Riccati Equation
이 강의는 Kalman filter를 stochastic observer로 읽고 covariance Riccati recursion, steady-state gain, LQR duality, separation principle을 연결합니다.
형광펜: 정의·핵심 · 메커니즘·직관 · 조건·주의
목차
- 1. Kalman filter를 observer로 읽기
- 2. Estimation error dynamics
- 3. Covariance Riccati recursion
- 4. Observability와 detectability
- 5. Steady-state Kalman gain
- 6. Control Riccati와 estimation Riccati의 duality
- 7. Separation principle
- 8. LQG
- 9. Nonlinear filtering으로 가는 경계
1. Kalman filter를 observer로 읽기
Deterministic Luenberger observer의 correction은 일반적으로
형태입니다. Kalman filter도 같은 innovation feedback 구조를 사용하며
입니다. 차이는 gain을 정하는 기준에 있습니다.
- Luenberger observer는 desired error dynamics에 맞춰 gain을 설계합니다.
- Kalman filter는 linear-Gaussian model 아래에서 conditional error covariance를 최소화하는 gain을 계산합니다.
Kalman gain은 일반적으로 time-varying입니다. 가 recursion을 따라 변하므로 같은 에서도 transient 동안 gain이 달라집니다.
2. Estimation error dynamics
Prior와 posterior errors를
로 둡니다. Correction equation을 대입하면
다음 prediction error는
입니다. 따라서 observer gain은 measurement가 prior error를 얼마나 제거하는지 정하고, process noise와 measurement noise가 매 step 새로운 error를 주입합니다.
3. Covariance Riccati recursion
Kalman covariance update 두 식은
입니다. 첫 식을 둘째 식에 대입하면 prior covariance에 대한 Riccati map을 얻습니다.
이 nonlinear matrix recursion이 estimation Riccati recursion입니다. 는 value function coefficient가 아니라 conditional estimation error covariance입니다.
4. Observability와 detectability
Observability는 noise가 없는 model에서 finite output sequence와 known inputs로 initial state를 유일하게 복원할 수 있는지 묻습니다. Detectability는 unobservable modes가 존재해도 모두 stable이면 허용합니다.
Kalman filter에서 unstable unobservable mode가 있으면 sensor data가 그 mode의 error를 교정할 수 없고, dynamics가 error를 증폭합니다. 따라서 steady-state covariance가 bounded하게 수렴하기 위한 표준 조건에는 의 detectability가 들어갑니다.
Time-invariant discrete model에서 자주 사용하는 충분조건은 다음과 같습니다.
- ,
- 가 detectable
- 가 stabilizable
정확한 theorem statement는 initialization과 singular covariance conventions에 따라 달라질 수 있습니다. 여기서는 이 조건들이 각각 hidden unstable modes와 process-driven modes를 제어한다는 의미를 가져갑니다. Rank와 PBH 정의는 Controllability, Observability, Stabilizability, Detectability에 있습니다.
5. Steady-state Kalman gain
Time-invariant 에서 prior covariance가 로 수렴하면 gain도 constant matrix로 수렴합니다.
Steady prior covariance는
를 만족합니다. 이는 prior-covariance convention으로 쓴 estimator DARE입니다.
Steady-state filter는 매 step covariance recursion을 반복하지 않고 fixed gain을 사용할 수 있습니다. 다만 model이 time-varying하거나 sensor availability가 바뀌거나 initialization transient가 중요한 경우에는 fixed gain이 같은 posterior를 주지 않습니다.
6. Control Riccati와 estimation Riccati의 duality
Infinite-horizon LQR DARE는
입니다. Estimator prior DARE와 비교하면 다음 transpose correspondence가 보입니다.
| LQR control | Kalman estimation |
|---|---|
| feedback gain | predictor gain 의 transpose |
| stabilizability | detectability |
두 식은 algebraic structure가 dual하지만 matrix 의 의미는 다릅니다. Control에서는 optimal cost-to-go의 quadratic coefficient이고, estimation에서는 error covariance입니다. 여기서 는 correction gain이고, prior-covariance DARE의 subtraction term에 직접 대응하는 predictor gain은 입니다. Control Riccati의 전체 유도는 LQR lecture §5에 있습니다.
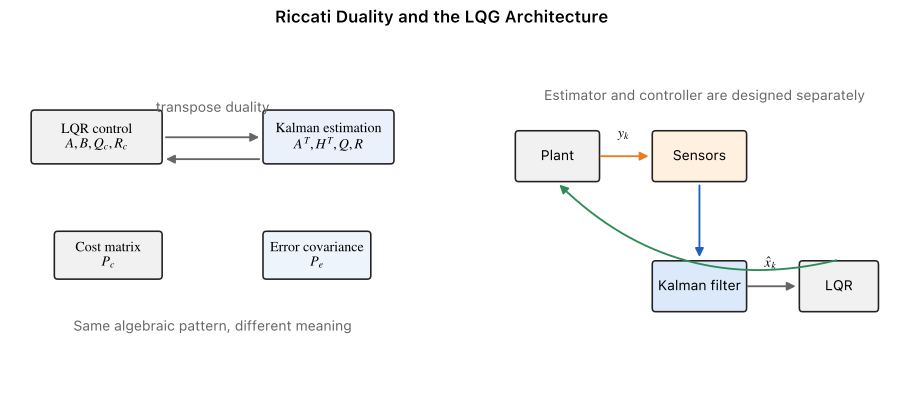
Control and estimation have dual Riccati structures; LQG combines their separately designed gains in one feedback loop.
7. Separation principle
다음 partially observed linear system을 생각합니다.
Full-state LQR gain을 이라 하고 Kalman estimate를 사용해
를 적용합니다. Standard linear-Gaussian, risk-neutral assumptions 아래에서 다음 두 gain을 분리해 설계할 수 있습니다.
- 로 LQR gain 을 설계합니다.
- 로 Kalman gain 를 설계합니다.
Augmented closed-loop eigenstructure는 controller block과 estimator-error block으로 분리됩니다. 따라서 과 해당 estimator error dynamics가 각각 stable일 때 combined loop도 stable입니다. Stabilizing gains의 존재에는 control 쪽 stabilizability·cost detectability와 estimation 쪽 detectability·covariance DARE 조건이 각각 필요합니다. 이 조건 아래에서 controller gain은 estimation noise covariances와 독립적으로, estimator gain은 control cost weights와 독립적으로 설계할 수 있습니다.
분리 설계가 model uncertainty, nonlinearities, risk-sensitive objectives, constraints까지 자동으로 해결한다는 뜻은 아닙니다.
8. LQG
Linear-Quadratic-Gaussian control은 다음 세 요소를 결합합니다.
- linear dynamics와 measurement model
- quadratic expected cost
- Gaussian process와 measurement noise
표준 LQG controller는 Kalman estimate에 LQR feedback을 적용하는 certainty-equivalent form입니다.
Finite horizon에서 additive, zero-mean, control-independent process noise와 full-state observation 아래 risk-neutral expected quadratic cost를 사용하면 process noise는 value function에 state-independent term을 추가하지만 full-state LQR gain은 바꾸지 않습니다. Persistent noise가 있는 undiscounted infinite-horizon total cost는 일반적으로 발산하므로 discounted 또는 average-cost formulation을 따로 지정해야 합니다. Partial observation에서는 Kalman filter가 conditional mean을 제공하고 separation principle이 같은 control gain을 사용할 근거를 줍니다.
LQG는 constraint를 직접 처리하지 않습니다. Input saturation이나 state constraint가 중요하면 constrained estimation과 MPC를 포함한 별도 설계가 필요합니다.
9. Nonlinear filtering으로 가는 경계
Dynamics 또는 measurement가 nonlinear이면
가 됩니다. Gaussian prior를 nonlinear map에 통과시킨 결과는 일반적으로 Gaussian이 아닙니다.
- EKF: Jacobian으로 local linearization한 뒤 Kalman equations를 적용합니다.
- UKF: sigma points로 mean과 covariance transformation을 근사합니다.
- Particle filter: samples로 non-Gaussian posterior를 근사합니다.
이 방법들은 linear Kalman filter와 같은 exactness를 갖지 않습니다. 선택 기준은 nonlinearity, posterior shape, state dimension, compute budget입니다. Particle filter의 기초는 Particle Filter와 L7 · Resampling and SIR에 있습니다.
이해 확인
1. Kalman filter와 Luenberger observer가 공유하는 구조와 gain 설계 기준의 차이를 설명하시오.
2. Estimator Riccati matrix와 control Riccati matrix가 각각 무엇을 나타내는지 쓰시오.
3. Detectability가 steady-state estimation에 필요한 이유를 설명하시오.
4. Separation principle이 허용하는 두 독립 설계를 쓰시오.
답
1. 둘 다 innovation feedback 구조를 사용합니다. Luenberger observer는 desired error dynamics에 맞춰 gain을 정하고, Kalman filter는 stochastic model에서 conditional error covariance를 최소화하는 gain을 계산합니다. → §1
2. Estimation의 는 conditional error covariance이고, control의 는 optimal cost-to-go의 quadratic coefficient입니다. → §3 · §6
3. Unstable unobservable mode는 measurement correction을 받지 못한 채 dynamics에 의해 error가 증폭되므로 bounded steady covariance를 기대할 수 없습니다. → §4
4. LQR gain은 control model과 cost로 설계하고, Kalman gain은 process·measurement model과 noise covariances로 설계합니다. → §7