Filtering의 목표는 매 시각 t마다 p(xt∣y1:t)를 얻는 것입니다. 정의는 L3 §8에서 conditioning set으로 구분했습니다. 매번 y1부터 yt까지 전부 다시 처리하면 measurement가 쌓일수록 계산이 커집니다. Bayes filter는 직전 시각의 결과 하나만 들고 가서 새 measurement 하나로 갱신합니다.
이 강의에서는 두 distribution에 이름을 붙입니다.
belt(xt)=p(xt∣y1:t),belt(xt)=p(xt∣y1:t−1)
belt(xt)는 "y1부터 yt까지 본 뒤 현재 state xt에 대한 belief"라고 읽습니다. Bar가 붙은 belt(xt)는 "yt는 아직 보지 않고 yt−1까지만 본 상태에서 xt에 대한 predicted belief"라고 읽습니다. 둘은 같은 variable xt의 distribution이고, 차이는 conditioning set에 yt가 들어 있는지 하나뿐입니다.
한 step은 두 단계로 나뉩니다.
belt−1predictionbeltupdate with ytbelt
Prediction은 transition model p(xt∣xt−1)을 쓰고, update는 measurement model p(yt∣xt)를 씁니다. 두 가정 아래에서는 과거 measurement y1:t−1이 다음 belief 계산에 belt−1을 통해서만 들어갑니다. 그래서 y1:t−1 자체를 보관할 필요가 없습니다. 이것은 §2와 §4의 유도에서 직접 확인됩니다.
시작점
시리즈 기호표에서 정한 대로 state는 t=0부터, measurement는 t=1부터 있습니다. 따라서 t=0에서 가진 것은 initial belief bel0(x0)=p(x0) 하나입니다. 이 값을 사전 정보나 가정으로 정하는 방법은 L2 §6에서 보았고, 이 강의의 3칸 복도 예는 거기서 든 p(x0)=[0.1,0.8,0.1]에서 시작합니다.
첫 measurement가 t=1에 오므로 첫 동작은 prediction입니다. y1:0은 빈 sequence이므로 bel1(x1)=p(x1)입니다.
p(x0)predictionp(x1)update with y1p(x1∣y1)predictionp(x2∣y1)→⋯
Filter의 출력은 숫자 하나가 아니라 distribution입니다. "로봇이 몇 번 칸에 있다"는 point estimate는 이 distribution의 값이 가장 큰 state(mode)나 mean을 골라 나중에 읽어냅니다.
2. Prediction step 유도
belt−1(xt−1)=p(xt−1∣y1:t−1)은 이미 가지고 있습니다. 시간이 한 step 지나 state가 xt−1에서 xt로 바뀌었고, yt는 아직 오지 않았습니다. 구하려는 것은 belt(xt)=p(xt∣y1:t−1)입니다.
두 state로 먼저 계산하기
State가 A, B 두 개라고 하겠습니다. 이전 belief와 transition model은 다음과 같습니다.
P(Xt−1=A∣y1:t−1)=0.3,P(Xt−1=B∣y1:t−1)=0.7
P(Xt=B∣Xt−1=A)=0.2,P(Xt=B∣Xt−1=B)=0.9
따라서 P(Xt=A∣Xt−1=A)=0.8, P(Xt=A∣Xt−1=B)=0.1입니다. L3 §6과 같은 숫자입니다. L3에서는 과거 measurement가 왜 여전히 필요한지를 보였고, 여기서는 같은 계산을 prediction step으로 읽습니다.
Xt=B에 도달하는 경로는 이전 state에 따라 두 개입니다.
경로
이전 state의 belief
transition probability
곱
A→B
0.3
0.2
0.06
B→B
0.7
0.9
0.63
합
0.69
두 경로는 Xt−1의 값이 서로 다르므로 동시에 일어날 수 없습니다. 그래서 더합니다. 같은 방법으로 P(Xt=A∣y1:t−1)=0.3×0.8+0.7×0.1=0.24+0.07=0.31입니다. 결과 belt=[0.31,0.69]의 합은 1입니다.
일반식을 한 줄에 법칙 하나씩
이제 같은 계산을 기호로 씁니다. 먼저 조건이 붙은 product rule이 필요합니다.
p(a,b∣c)=p(a∣b,c)p(b∣c)
이것은 L1 §6의 product rule을 "c가 이미 주어진 세계" 안에서 쓴 것입니다. 모든 확률에 같은 조건 c가 붙어 있을 뿐 규칙은 같습니다.
첫 줄은 모르는 이전 state xt−1을 joint에 넣고 모든 값에 대해 더합니다. 이 sum이 없애는 variable은 xt−1입니다. 둘째 줄은 product rule에서 a=xt, b=xt−1, c=y1:t−1로 대응시킨 것입니다. 셋째 줄은 조건에서 y1:t−1을 지웠습니다.
이 조건에는 x0:t−2까지 들어 있습니다. 유도에 필요한 것은 x0:t−2가 없는 형태이므로 한 번 더 marginalization을 합니다.
p(xt∣xt−1,y1:t−1)=x0:t−2∑p(xt,x0:t−2∣xt−1,y1:t−1)=x0:t−2∑p(xt∣x0:t−1,y1:t−1)p(x0:t−2∣xt−1,y1:t−1)=p(xt∣xt−1)x0:t−2∑p(x0:t−2∣xt−1,y1:t−1)=p(xt∣xt−1)(marginalization)(product rule)(Markov assumption)(sums to 1)
둘째 줄에서는 a=xt, b=x0:t−2, c=(xt−1,y1:t−1)로 대응시켰고, (x0:t−2,xt−1)=x0:t−1을 썼습니다. t=1이면 x0:t−2와 y1:t−1이 모두 비어 있어서 이 과정이 필요 없습니다. Continuous state라면 sum을 integral로 바꾸면 같은 줄이 성립합니다.
이 줄에는 과거 measurement y1:t−1이 conditioning set에 들어 있는 형태의 Markov assumption이 필요합니다. State만 있는 p(xt∣x0:t−1)=p(xt∣xt−1)로는 부족합니다. 반례는 L3 §5에서 보았습니다.
셋째 줄에서 y1:t−1이 transition factor에서는 사라졌지만 결과식에서 사라진 것은 아닙니다. 과거 measurement는 p(xt−1∣y1:t−1) 쪽에 그대로 남아 있습니다. xt−1을 알면 dynamics에는 과거 measurement가 필요 없지만, 우리는 xt−1을 모르기 때문입니다.
State가 continuous이면 모든 p가 density이고, sum은 integral이 됩니다. xt−1을 폭이 작은 구간으로 나누어 더한 Riemann sum의 극한이라는 점은 L1 §8과 같습니다.
belt(xt)=∫p(xt∣xt−1)belt−1(xt−1)dxt−1
Integrand에는 xt와 xt−1이 둘 다 있습니다. dxt−1로 적분하면 모든 가능한 xt−1에 대해 더해지므로 xt−1이 없어지고 xt만 남습니다. 이 식은 이렇게 읽습니다. "각 xt 값마다, 가능한 모든 이전 state xt−1에 대해 그곳에 있었을 belief와 그곳에서 xt로 갈 transition density를 곱해서 모두 더한다."
Prediction은 L1의 law of total probability p(x)=∑zp(x∣z)p(z)에 y1:t−1을 조건으로 붙이고, Markov assumption으로 한 factor의 조건을 줄인 식입니다. 새로 외울 법칙은 없습니다.
결과는 숫자 하나가 아니라 xt의 함수입니다. 모든 xt 값에 대해 이 integral을 계산해야 한다는 점이 §7에서 문제가 됩니다.
가장 그럴듯한 이전 state 하나만 대입하는 것은 prediction이 아닙니다
belt−1=[0.3,0.7]에서 B만 골라 xt−1=B로 두면 P(Xt=B)=0.9가 나옵니다. 실제 predicted belief는 0.69입니다. 차이 0.21은 A였을 확률 0.3을 B처럼 취급한 데서 옵니다. 계산하면 0.3×(0.9−0.2)=0.21입니다. Prediction은 가능한 모든 이전 state를 각자의 belief만큼 transition시켜 더하는 계산입니다.
3. Prediction을 숫자와 그림으로
Uncertainty의 두 출처
Prediction 식은 두 가지 uncertainty를 한 번에 처리합니다.
xt−1을 정확히 모릅니다. 이것은 belt−1(xt−1)에 들어 있습니다.
xt−1을 알아도 transition 자체가 noisy합니다. 이것은 p(xt∣xt−1)에 들어 있습니다.
xt−1=a라고 확신할 수 있으면 belt−1의 mass가 전부 a에 있으므로 sum에 항이 하나만 남습니다. 그러면 belt(xt)=p(xt∣xt−1=a)이고, 1번은 없어지고 2번만 남습니다. 반대로 transition이 deterministic이면 2번이 없습니다. 예를 들어 xt=xt−1+ut이면 belief는 모양 그대로 ut만큼 옮겨집니다.
Prediction이 belief를 항상 퍼뜨리는 것은 아닙니다. 아래 convolution 절처럼 independent한 additive noise를 더하는 모델에서는 variance가 더해지므로 퍼집니다. 그러나 여러 state를 한 state로 모으는 transition은 predicted belief를 belt−1보다 좁게 만들 수 있습니다. 예를 들어 3칸 복도에서 "오른쪽 벽까지 가라"는 명령이 칸 1, 2에서 0.9로 칸 3에 닿고 0.1로 제자리에 남는다면, 행을 이전 state로 둔 transition matrix는 아래와 같고 [0.1,0.8,0.1]이 [0.01,0.08,0.91]이 되어 가장 큰 값이 0.8에서 0.91로 커집니다.
Tend=0.10000.100.90.91
제어에서 xt=Axt−1+But를 계산할 때는 state 값 하나(vector 하나)를 다음 시각으로 보냅니다. Bayes filter는 같은 dynamics를 써서 distribution 전체를 다음 시각으로 보냅니다. State-space model이 어떤 조건에서 transition model이 되는지는 L3 §7에 있습니다.
Signals and Systems에서 본 prediction: shift와 convolution
모델을 xt=xt−1+ut+wt로 두겠습니다. ut는 알고 있는 control input이고, wt는 density pw를 가진 process noise입니다. wt가 (x0:t−1,y1:t−1) 전체와 independent하다고 가정합니다.
xt−1이 주어지면 xt−xt−1−ut=wt입니다. Shift는 density의 높이를 바꾸지 않으므로 transition model은 noise density를 옮겨 놓은 것입니다.
p(xt∣xt−1)=pw(xt−xt−1−ut)
이것을 prediction 식에 넣습니다. 적분 variable xt−1은 x′로 쓰고, convolution의 정의는 (f∗g)(z)=∫f(x′)g(z−x′)dx′입니다.
belt(x)=∫pw(x−x′−ut)belt−1(x′)dx′=∫belt−1(x′)pw((x−ut)−x′)dx′=(belt−1∗pw)(x−ut)(transition model)(rearrange the argument)(definition of convolution, z=x−ut)
h(z)=(belt−1∗pw)(z)라고 두면 belt(x)=h(x−ut)이므로, h를 오른쪽으로 ut만큼 옮긴 것입니다. Prediction은 belief를 noise density와 convolution해서 퍼뜨리고, control input만큼 shift하는 연산입니다. Convolution과 shift는 순서를 바꿔도 결과가 같습니다. y1:t−1이 주어졌을 때 xt는 xt−1+ut와 그것에 independent한 wt의 합이므로, (variance가 유한하면) Var(xt∣y1:t−1)=Var(xt−1∣y1:t−1)+Var(wt)입니다.
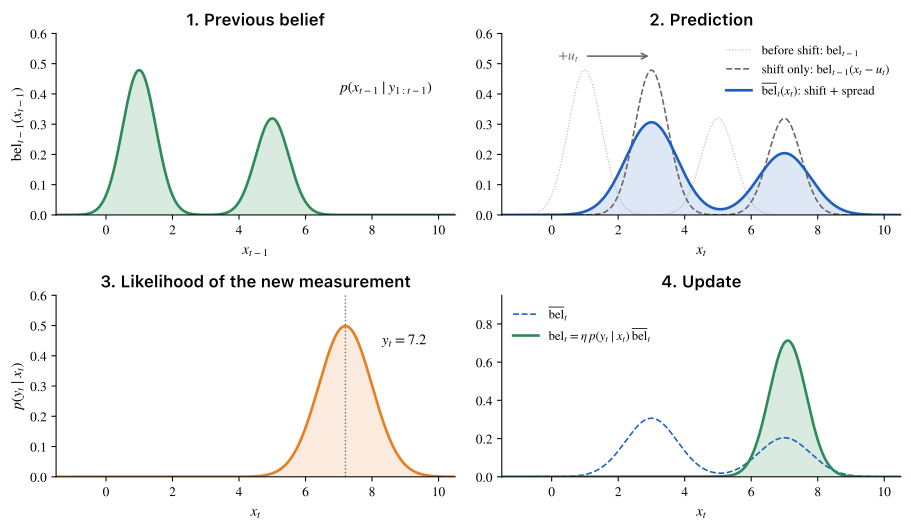
위 두 panel이 이 절의 prediction입니다: belt−1=0.6N(1,0.52)+0.4N(5,0.52), ut=2, wt∼N(0,0.62). 아래 두 panel은 §4의 update이며 yt=xt+vt, vt∼N(0,0.82), yt=7.2입니다.
그림의 둘째 panel에서 옅은 회색 점선은 shift 전의 belief, 회색 파선은 shift만 한 경우이고, 파란 선이 실제 predicted belief입니다. 각 component의 variance는 0.52=0.25에서 0.25+0.62=0.61로 커지고, 왼쪽 component의 최댓값은 약 0.48에서 약 0.31로 낮아집니다. 두 component의 weight 0.6과 0.4는 prediction으로 바뀌지 않습니다.
3칸 복도
같은 계산을 discrete state에서 해봅니다. 복도에 칸 1, 2, 3이 있고 bel0=p(x0)=[0.1,0.8,0.1]입니다. 로봇에게 "제자리에 있어라"라고 명령했지만 미끄러질 수 있어서, 제자리 0.8, 왼쪽 한 칸 0.1, 오른쪽 한 칸 0.1로 움직인다고 하겠습니다. 벽 쪽으로 움직이려 하면 벽에 막혀 제자리에 남습니다.
L3 §3처럼 행을 이전 state로 두면 transition matrix는 다음과 같습니다.
bel1=[0.17,0.66,0.17]입니다. Measurement를 보기 전인데도 2번 칸의 belief가 0.8에서 0.66으로 낮아졌습니다. 로봇이 미끄러질 수 있다는 transition noise가 belief를 퍼뜨린 결과입니다.
벽이 없다면 이 계산은 discrete convolution입니다. 벽이 없는 긴 복도에서 [0.1,0.8,0.1]과 kernel [0.1,0.8,0.1]의 discrete convolution은 칸 0부터 4까지 [0.01,0.16,0.66,0.16,0.01]입니다. 벽은 칸 0과 칸 4로 나갈 mass 0.01을 칸 1과 칸 3으로 되돌려 놓습니다. 그래서 0.16+0.01=0.17이 됩니다.
4. Update step 유도
이제 sensor가 yt를 내놓았습니다. 구하려는 것은 belt(xt)=p(xt∣y1:t)입니다. y1:t=(y1:t−1,yt)이므로 p(xt∣y1:t)와 p(xt∣yt,y1:t−1)은 같은 것을 다르게 쓴 것입니다.
L2 §1의 유도에 y1:t−1을 조건으로 붙인 것입니다. 여기까지는 모델 가정을 하나도 쓰지 않았습니다.
각 항을 읽어봅니다.
좌변 p(xt∣y1:t): 이번 update의 posterior, 즉 belt(xt)입니다.
분자의 p(xt∣y1:t−1): §2에서 계산한 belt(xt)이고, 이번 update의 prior입니다.
분자의 p(yt∣xt,y1:t−1): likelihood인데 아직 조건에 y1:t−1이 붙어 있습니다.
분모 p(yt∣y1:t−1): 이번 update의 evidence입니다. §5에서 다룹니다.
Measurement의 conditional independence
L3 §5의 두 번째 가정은 p(yt∣x0:t,y1:t−1)=p(yt∣xt)입니다. 필요한 것은 x0:t−1이 조건에 없는 형태이므로, §2와 같은 방법으로 한 줄씩 줄입니다.
p(yt∣xt,y1:t−1)=x0:t−1∑p(yt,x0:t−1∣xt,y1:t−1)=x0:t−1∑p(yt∣x0:t,y1:t−1)p(x0:t−1∣xt,y1:t−1)=p(yt∣xt)x0:t−1∑p(x0:t−1∣xt,y1:t−1)=p(yt∣xt)(marginalization)(product rule)(measurement CI)(sums to 1)
말로 하면, 현재 state xt를 알면 yt의 distribution을 계산하는 데 과거 measurement와 과거 state가 더 필요하지 않습니다. 이것은 xt가 주어졌을 때의 conditional independence입니다. 조건 없이 보면 yt와 y1:t−1은 같은 state trajectory에 의존하므로 일반적으로 dependent합니다.
이제 Bayes theorem의 결과에 대입합니다.
belt(xt)=p(yt∣y1:t−1)p(yt∣xt,y1:t−1)p(xt∣y1:t−1)=p(yt∣y1:t−1)p(yt∣xt)p(xt∣y1:t−1)=p(yt∣y1:t−1)p(yt∣xt)belt(xt)(Bayes theorem)(measurement CI)(definition of belt)
분모는 xt에 의존하지 않으므로 η=1/p(yt∣y1:t−1)로 묶어 씁니다.
belt(xt)=ηp(yt∣xt)belt(xt)
숫자로 보는 update
§2와는 별개의 예입니다. Prediction을 마친 결과가 belt=[0.7,0.3] (A, B 순서)이고, sensor가 yt=z를 내놓았습니다. Sensor model은 p(yt=z∣A)=0.2, p(yt=z∣B)=0.9입니다. z는 B에서 훨씬 잘 나오는 reading입니다.
xt
belt
p(yt=z∣xt)
곱
belt
A
0.7
0.2
0.14
0.341
B
0.3
0.9
0.27
0.659
합
1
1.1
0.41
1
곱의 합 0.41로 나누면 0.14/0.41≈0.341, 0.27/0.41≈0.659입니다. Measurement 전에는 A가 더 그럴듯했지만, 뒤에는 B가 더 그럴듯합니다. Likelihood 열의 합이 1.1인 것은 오류가 아닙니다. Likelihood는 yt를 고정한 xt의 함수라서 xt에 대해 더해 1이 될 필요가 없습니다 (L2 §2).
Update는 predicted belief에 likelihood를 칸마다 곱해서 모양을 바꾸고, 합으로 나눠 다시 distribution으로 만드는 두 동작입니다. §3 그림의 아래 두 panel이 continuous 버전입니다. Predicted belief는 왼쪽 component에 mass가 더 많았지만(xt>5에 약 0.40), yt=7.2가 오른쪽 component와 맞으므로 update 뒤에는 xt>5에 약 0.999가 실립니다.
여기서 prior × likelihood를 계산한 곳은 고정된 state 값(칸) 하나하나입니다. Particle을 predicted belief에서 뽑으면(transition model로 propagate하면) prior가 particle의 위치에 이미 들어 있어서 weight가 달라집니다. 그 이야기는 L6 §6에서 합니다.
5. Normalization constant
η=p(yt∣y1:t−1)1
p(yt∣y1:t−1)은 "과거 measurement y1:t−1을 알 때 이번 measurement가 실제로 받은 값 yt로 나올 확률"라고 읽습니다. yt가 continuous이면 확률 대신 density입니다. 이 값은 xt에 의존하지 않습니다. 반면 받은 yt와 과거 y1:t−1에는 의존하므로, 다른 measurement가 오면 값이 달라질 수 있습니다.
"xt에 대해 상수"와 "어떤 measurement에도 같은 값"은 다른 말입니다 (L2 §4).
η−1을 두 가지 방법으로 구해봅니다.
첫째: evidence로 유도하기
yt가 나올 확률을 구하는데 현재 state xt를 모르므로, xt를 joint에 넣고 없앱니다.
필요한 것은 initial belief p(x0), transition model p(xt∣xt−1), measurement model p(yt∣xt), 그리고 들어오는 measurement뿐입니다. Control input이 있으면 transition model을 p(xt∣xt−1,ut)로 쓰고, belief의 조건에도 u를 넣습니다. 이 강의에서는 조건에 u를 적지 않습니다.
u를 적으면 §2 유도의 둘째 줄은 p(xt∣xt−1,y1:t−1,u1:t)p(xt−1∣y1:t−1,u1:t)가 됩니다. 앞 factor를 p(xt∣xt−1,ut)로 줄이는 것은 ut를 남긴 가정 1입니다. 뒤 factor를 belt−1(xt−1)=p(xt−1∣y1:t−1,u1:t−1)로 바꾸려면 ut를 조건에 더해도 이 belief가 바뀌지 않아야 합니다. ut를 미리 정해 두었거나 y1:t−1과 이전 belief만으로 계산했다면, ut는 xt−1에 대한 추가 정보를 담지 않으므로 이 조건이 성립합니다(L3 §3).
State가 M개인 discrete filter의 한 step은 다음과 같습니다.
input : bel[1..M]      # bel_{t-1}
        T[j][i]        # p(x_t = i | x_{t-1} = j)
        L[i]           # p(y_t | x_t = i), received y_t
output: bel_new[1..M]  # bel_t

# prediction
for i in 1..M:
    bel_bar[i] = sum over j of T[j][i] * bel[j]

# update
for i in 1..M:
    g[i] = L[i] * bel_bar[i]
# p(y_t | y_{1:t-1}) = 1 / eta
evidence = sum over i of g[i]
for i in 1..M:
    bel_new[i] = g[i] / evidence
바깥 loop는 bel ← p(x_0)로 시작해서 t=1,2,…마다 yt를 받고 위 step을 실행합니다.
3칸 복도를 두 step 돌리기
§3의 복도를 이어서 씁니다. L2 §5처럼 칸 1, 2, 3에서 기대되는 거리 reading은 각각 2 m, 5 m, 8 m입니다. Sensor 출력을 이 세 값 중 가장 가까운 값으로 바꿔서 받는다고 하고, measurement model을 다음 표로 정합니다.
x
p(y=2m∣x)
p(y=5m∣x)
p(y=8m∣x)
1
0.93
0.05
0.02
2
0.10
0.80
0.10
3
0.05
0.10
0.85
각 행은 state 하나에서 나올 reading의 distribution이라 합이 1입니다. 각 열은 reading 하나를 고정한 likelihood라 합이 1일 필요가 없습니다. y=5m 열은 L2 §5의 likelihood [0.05,0.8,0.1]과 같습니다. 나머지 값도 L2 §5의 sensor처럼 거리가 멀수록 noise가 크다고 두고 정했습니다. 그래서 반대쪽 끝의 reading이 나올 확률도, 벽까지 8 m인 3번 칸에서 2 m로 읽힐 확률 0.05가 벽까지 2 m인 1번 칸에서 8 m로 읽힐 확률 0.02보다 큽니다.
Transition model은 명령에 따라 둘입니다. Step 1의 명령은 "제자리"이고 §3의 Tstay를 씁니다. Step 2의 명령은 "오른쪽으로 한 칸"이고, 0.8로 성공하고 0.2로 실패해 제자리에 남으며, 3번 칸에서는 벽 때문에 그대로 있습니다.
Tright=0.2000.80.2000.81
Measurement는 y1=5m, y2=8m가 들어왔습니다. 계산은 반올림하기 전 값으로 했습니다.
cell 1
cell 2
cell 3
합
bel0=p(x0)
0.10
0.80
0.10
1
bel1=bel0Tstay
0.17
0.66
0.17
1
p(y1=5m∣x1)
0.05
0.80
0.10
곱
0.0085
0.528
0.017
0.5535
bel1
0.015
0.954
0.031
1
bel2=bel1Tright
0.0031
0.203
0.794
1
p(y2=8m∣x2)
0.02
0.10
0.85
곱
0.0001
0.0203
0.6748
0.6951
bel2
0.0001
0.029
0.971
1
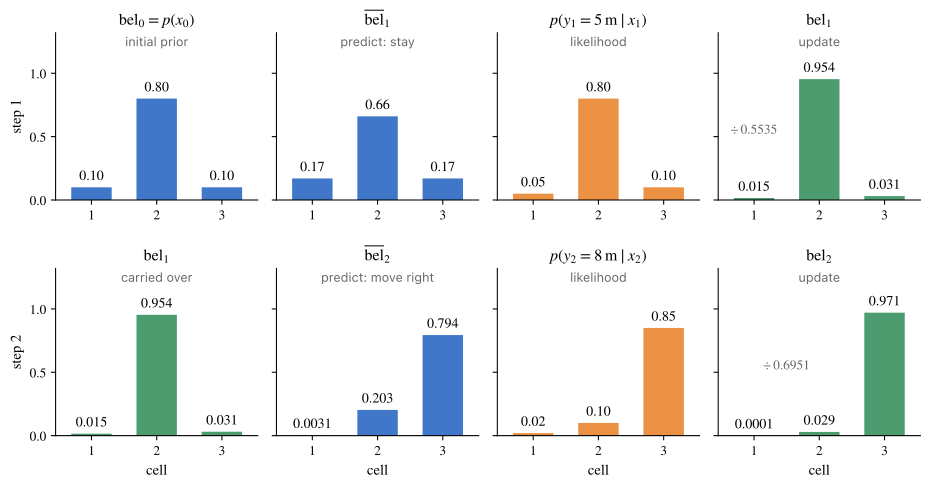
3칸 복도에서 Bayes filter를 두 step 실행한 결과입니다. 파랑은 prior 역할의 belief, 주황은 likelihood, 초록은 update 뒤의 belief이고, 둘째 줄 첫 panel은 첫째 줄의 결과를 그대로 가져온 것입니다.
Step 1에서 prediction은 belief를 퍼뜨렸고(0.8 → 0.66), measurement 5 m가 2번 칸과 잘 맞아서 update가 belief를 모았습니다(0.954). Step 2에서 prediction은 mass를 오른쪽으로 옮겼습니다. 2번 칸의 0.203은 2번 칸에서 이동에 실패한 0.2×0.954≈0.191과 1번 칸에서 오른쪽으로 온 0.8×0.015≈0.012의 합입니다. Measurement 8 m가 3번 칸과 맞아서 update 뒤 3번 칸이 0.971이 됩니다.
이 예에서는 update가 belief를 모았지만, 항상 그런 것은 아닙니다. Step 2에서 y2=2m가 들어왔다면 likelihood [0.93,0.10,0.05]와 곱한 합이 약 0.0629이고, posterior는 약 [0.045,0.323,0.631]입니다. 가장 큰 값이 predicted belief의 0.794보다 낮아집니다. Predicted belief와 어긋나는 measurement는 belief를 더 퍼뜨릴 수 있습니다.
이 강의에서 남길 것
Prediction은 y1:t−1을 조건으로 붙인 law of total probability이고, update는 y1:t−1을 조건으로 붙인 Bayes theorem입니다. 모델 가정은 각 단계에서 한 factor의 조건을 줄이는 데 한 번씩만 쓰입니다.
7. 왜 그대로는 계산하기 어려운가
위 알고리즘은 칸이 3개일 때는 손으로도 됩니다. 어려움은 state space가 커질 때 생깁니다.
첫째, belief는 state space 전체 위의 함수입니다. Prediction은 모든 xt 값마다 xt−1 전체에 대한 integral을 하나씩 계산해야 하고, update도 모든 xt에서 곱한 뒤 xt 전체에 대해 적분해야 합니다.
둘째, grid로 근사하면 차원에 따라 크기가 지수적으로 늘어납니다. 각 축을 M칸으로 나누면 n차원 state의 칸 수는 Mn입니다. M=100, n=10이면 10010=1020칸입니다. Transition이 모든 칸 쌍을 연결한다면 prediction 한 번에 1020×1020=1040번의 곱셈이 필요합니다.
Floating base 로봇은 base의 pose와 velocity만 해도 12차원이므로 n=10은 큰 값이 아닙니다.
셋째, 일반적으로 closed form이 없습니다. Dynamics나 measurement model이 nonlinear이거나 noise가 Gaussian이 아니면, prediction과 update의 결과는 보통 유한한 개수의 parameter로 적히는 distribution family에 머물지 않습니다. State 수가 유한한 discrete model처럼 특수한 구조가 있으면 예외입니다. 똑같이 생긴 두 복도 중 어디인지 모르는 경우처럼 belief가 multimodal이면, mean과 variance 두 숫자로는 belief를 표현할 수 없습니다.
Continuous state에서 중요한 예외가 하나 있습니다. Dynamics와 measurement가 linear이고, noise가 Gaussian이며 시간에 걸쳐 independent하고 서로와 x0에도 independent하고, p(x0)도 Gaussian이면 belief가 계속 Gaussian으로 남고 이 recursion은 Kalman filter라는 closed form을 가집니다. Kalman filter는 따로 공부합니다.
표현
정확한 경우
한계
Grid (칸마다 값 저장)
state 수가 유한한 discrete model
칸 수가 Mn으로 커짐, continuous state에서는 근사
Gaussian (mean, covariance)
linear-Gaussian 모델 (Kalman filter)
multimodal 표현 불가
Particle (sample 집합)
없음 (근사)
Monte Carlo error (적절한 조건에서 N이 커질수록 줄어듦)
그래서 belief 함수 전체를 저장하는 대신, belief가 큰 곳에 모이는 sample로 belief를 표현합니다. Prediction의 integral은 transition model에서 sample을 뽑는 것으로 바뀌고(L5 §6), update의 곱셈은 weight로 바뀝니다(L6 §6). 출발점은 L5 §1입니다.
이해 확인
1. Prediction 유도의 셋째 줄에서 transition factor의 조건 y1:t−1을 지울 수 있는 이유를 설명하시오. 또한 그런데도 결과식이 여전히 y1:t−1에 의존하는 이유를 설명하시오.
2.belt−1=[0.3,0.7]에서 가장 그럴듯한 B만 대입하면 P(Xt=B)=0.9, 제대로 계산하면 0.69이다. 이 차이가 어떤 정보를 버려서 생기는지 설명하고, 대입이 정확한 답을 주는 경우를 쓰시오.
3. Prediction은 dxt−1로, evidence는 dxt로 적분한다. 각각 무엇을 없애려는 것이며 결과가 무엇의 함수인지 설명하시오.
4. Discrete Bayes filter에서 evidence를 따로 계산하지 않고 "곱의 합으로 나누기"만 해도 되는 이유를 설명하시오.
답
1. L3의 Markov assumption은 x0:t−1과 y1:t−1이 주어졌을 때 xt의 distribution이 xt−1에만 의존한다는 것입니다. x0:t−2를 marginalize하고 product rule과 합이 1인 성질을 쓰면 p(xt∣xt−1,y1:t−1)=p(xt∣xt−1)을 얻습니다. 그러나 xt−1을 모르기 때문에 y1:t−1은 belt−1(xt−1)=p(xt−1∣y1:t−1)을 통해 결과에 남습니다. → §2
2.A였을 확률 0.3을 B로 취급해서 생깁니다. 차이는 0.3×(0.9−0.2)=0.21입니다. belt−1의 mass가 전부 한 state에 있으면 대입이 정확하고, 그때는 transition noise만 uncertainty로 남습니다. Mass가 있는 모든 이전 state에서 Xt=B로 갈 transition probability가 같을 때도 값이 같아지지만, 이 예의 0.2와 0.9처럼 다르면 point mass일 때뿐입니다. → §2, §3
3. Prediction은 좌변이 xt의 함수여야 하므로 이전 state xt−1을 없앱니다. Evidence는 좌변에 state가 없어야 하므로 현재 state xt를 없애고, 받은 yt에 대한 숫자 하나가 남습니다. → §5