시리즈: Kalman Filtering · 이전: L3 · 다음: L5
이 강의는 scalar correction을 vector state와 vector measurement로 확장합니다. Kalman gain을 암기식으로 두지 않고 state–measurement cross-covariance와 innovation covariance의 비율로 유도합니다.
형광펜: 정의·핵심 · 메커니즘·직관 · 조건·주의
목차
1. Measurement prediction
Prior와 measurement model은
x k ∣ y 1 : k − 1 ∼ N ( x ^ k − , P k − ) , x_k\mid y_{1:k-1}
\sim\mathcal N(\hat x_k^-,P_k^-),
x k ∣ y 1 : k − 1 ∼ N ( x ^ k − , P k − ) , y k = H k x k + v k , v k ∼ N ( 0 , R k ) y_k=H_kx_k+v_k,\qquad
v_k\sim\mathcal N(0,R_k)
y k = H k x k + v k , v k ∼ N ( 0 , R k ) 입니다. Predicted measurement mean은
y ^ k − = H k x ^ k − \hat y_k^-=H_k\hat x_k^-
y ^ k − = H k x ^ k − 입니다. H k H_k H k
2. Innovation vector
Innovation을
r k = y k − H k x ^ k − r_k=y_k-H_k\hat x_k^-
r k = y k − H k x ^ k − 로 정의합니다. r k ∈ R m r_k\in\mathbb R^m r k ∈ R m
서로 다른 sensor units를 가진 components를 raw magnitude만으로 비교할 수는 없습니다. Scale과 correlation은 innovation covariance S k S_k S k
3. Innovation covariance
Prior error를 e k − = x k − x ^ k − e_k^-=x_k-\hat x_k^- e k − = x k − x ^ k −
r k = H k e k − + v k . r_k=H_ke_k^-+v_k.
r k = H k e k − + v k . 따라서
S k = Cov ( r k ∣ y 1 : k − 1 ) (definition) = Cov ( H k e k − + v k ) (innovation substitution) = H k P k − H k ⊤ + R k (independence) . \begin{aligned}
S_k
&=\operatorname{Cov}(r_k\mid y_{1:k-1})
&&\text{(definition)}\\
&=\operatorname{Cov}(H_ke_k^-+v_k)
&&\text{(innovation substitution)}\\
&=H_kP_k^-H_k^{\top}+R_k
&&\text{(independence)}.
\end{aligned}
S k = Cov ( r k ∣ y 1 : k − 1 ) = Cov ( H k e k − + v k ) = H k P k − H k ⊤ + R k (definition) (innovation substitution) (independence) . 즉
S k = H k P k − H k ⊤ + R k \boxed{S_k=H_kP_k^-H_k^{\top}+R_k}
S k = H k P k − H k ⊤ + R k 입니다. R k ≻ 0 R_k\succ0 R k ≻ 0 S k ≻ 0 S_k\succ0 S k ≻ 0
4. State-measurement cross-covariance
State error와 innovation의 cross-covariance를 계산합니다.
Cov ( e k − , r k ) = E [ e k − ( H k e k − + v k ) ⊤ ] (innovation substitution) = P k − H k ⊤ + E [ e k − v k ⊤ ] (expansion) = P k − H k ⊤ (independence) . \begin{aligned}
\operatorname{Cov}(e_k^-,r_k)
&=\mathbb E[e_k^-(H_ke_k^-+v_k)^{\top}]
&&\text{(innovation substitution)}\\
&=P_k^-H_k^{\top}+\mathbb E[e_k^-v_k^{\top}]
&&\text{(expansion)}\\
&=P_k^-H_k^{\top}
&&\text{(independence)}.
\end{aligned}
Cov ( e k − , r k ) = E [ e k − ( H k e k − + v k ) ⊤ ] = P k − H k ⊤ + E [ e k − v k ⊤ ] = P k − H k ⊤ (innovation substitution) (expansion) (independence) . Matrix P k − H k ⊤ ∈ R n × m P_k^-H_k^{\top}\in\mathbb R^{n\times m} P k − H k ⊤ ∈ R n × m
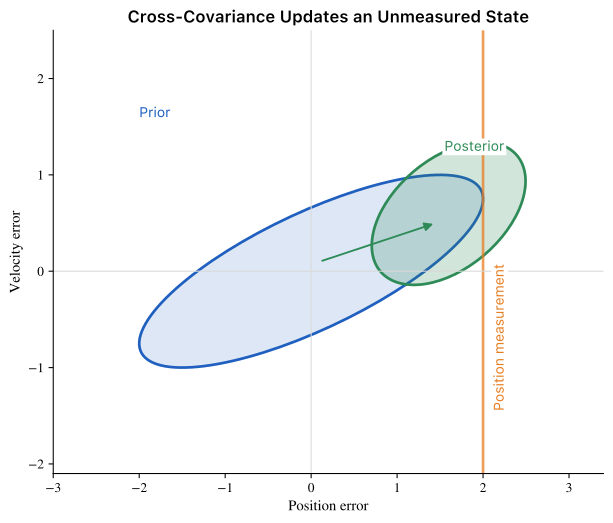
Measurement가 직접 보지 않는 state component도 innovation과 cross-covariance가 있으면 갱신됩니다.
5. Joint Gaussian 구성
x k x_k x k y k y_k y k
[ x k y k ] ∼ N ( [ x ^ k − H k x ^ k − ] , [ P k − P k − H k ⊤ H k P k − S k ] ) . \begin{bmatrix}
x_k\\y_k
\end{bmatrix}
\sim
\mathcal N\left(
\begin{bmatrix}
\hat x_k^-\\H_k\hat x_k^-
\end{bmatrix},
\begin{bmatrix}
P_k^-&P_k^-H_k^{\top}\\
H_kP_k^-&S_k
\end{bmatrix}
\right).
[ x k y k ] ∼ N ( [ x ^ k − H k x ^ k − ] , [ P k − H k P k − P k − H k ⊤ S k ] ) . 각 block은 state covariance, 두 cross-covariances, measurement covariance입니다. 이 joint distribution에 실제 y k y_k y k p ( x k ∣ y 1 : k ) p(x_k\mid y_{1:k}) p ( x k ∣ y 1 : k )
6. Conditional Gaussian 유도
Joint Gaussian
[ a b ] ∼ N ( [ μ a μ b ] , [ Σ a a Σ a b Σ b a Σ b b ] ) \begin{bmatrix}a\\b\end{bmatrix}
\sim\mathcal N\left(
\begin{bmatrix}\mu_a\\\mu_b\end{bmatrix},
\begin{bmatrix}
\Sigma_{aa}&\Sigma_{ab}\\
\Sigma_{ba}&\Sigma_{bb}
\end{bmatrix}
\right)
[ a b ] ∼ N ( [ μ a μ b ] , [ Σ aa Σ ba Σ ab Σ bb ] ) 에서 b b b
E [ a ∣ b ] = μ a + Σ a b Σ b b − 1 ( b − μ b ) , \mathbb E[a\mid b]
=\mu_a+\Sigma_{ab}\Sigma_{bb}^{-1}(b-\mu_b),
E [ a ∣ b ] = μ a + Σ ab Σ bb − 1 ( b − μ b ) , Cov ( a ∣ b ) = Σ a a − Σ a b Σ b b − 1 Σ b a \operatorname{Cov}(a\mid b)
=\Sigma_{aa}-
\Sigma_{ab}\Sigma_{bb}^{-1}\Sigma_{ba}
Cov ( a ∣ b ) = Σ aa − Σ ab Σ bb − 1 Σ ba 입니다. §5 의 blocks를 대입하면
x ^ k + = x ^ k − + P k − H k ⊤ S k − 1 ( y k − H k x ^ k − ) (conditional Gaussian mean) , P k + = P k − − P k − H k ⊤ S k − 1 H k P k − (conditional Gaussian covariance) . \begin{aligned}
\hat x_k^+
&=\hat x_k^-+
P_k^-H_k^{\top}S_k^{-1}
(y_k-H_k\hat x_k^-)
&&\text{(conditional Gaussian mean)},\\
P_k^+
&=P_k^--
P_k^-H_k^{\top}S_k^{-1}H_kP_k^-
&&\text{(conditional Gaussian covariance)}.
\end{aligned}
x ^ k + P k + = x ^ k − + P k − H k ⊤ S k − 1 ( y k − H k x ^ k − ) = P k − − P k − H k ⊤ S k − 1 H k P k − (conditional Gaussian mean) , (conditional Gaussian covariance) . 이 두 식이 multivariate Kalman correction입니다.
7. Kalman gain
Conditional mean의 coefficient를
K k = P k − H k ⊤ S k − 1 \boxed{
K_k=P_k^-H_k^{\top}S_k^{-1}
}
K k = P k − H k ⊤ S k − 1 로 정의합니다. 따라서
K k = Cov ( x k , r k ) ⏟ P k − H k ⊤ Cov ( r k ) − 1 ⏟ S k − 1 K_k=
\underbrace{\operatorname{Cov}(x_k,r_k)}_{P_k^-H_k^{\top}}
\underbrace{\operatorname{Cov}(r_k)^{-1}}_{S_k^{-1}}
K k = P k − H k ⊤ Cov ( x k , r k ) S k − 1 Cov ( r k ) − 1 로 읽을 수 있습니다.
Numerator는 innovation이 어떤 state error를 알려주는지 나타냅니다.
Denominator는 innovation 자체의 scale과 correlation을 normalize합니다.
Kalman gain은 prior와 measurement를 단순 평균하는 scalar weight가 아니라 normalized cross-covariance map입니다.
8. Posterior mean
Gain과 innovation notation을 사용하면
x ^ k + = x ^ k − + K k r k \boxed{
\hat x_k^+=\hat x_k^-+K_kr_k
}
x ^ k + = x ^ k − + K k r k 입니다. Dimension은
K k ∈ R n × m , r k ∈ R m , K k r k ∈ R n K_k\in\mathbb R^{n\times m},\qquad
r_k\in\mathbb R^m,\qquad
K_kr_k\in\mathbb R^n
K k ∈ R n × m , r k ∈ R m , K k r k ∈ R n 입니다. Measurement residual을 state correction으로 변환하는 map이 K k K_k K k
9. Posterior covariance
Conditional covariance는
P k + = P k − − K k S k K k ⊤ P_k^+=P_k^--K_kS_kK_k^{\top}
P k + = P k − − K k S k K k ⊤ 으로 쓸 수 있습니다. K k S k = P k − H k ⊤ K_kS_k=P_k^-H_k^{\top} K k S k = P k − H k ⊤
P k + = P k − − K k H k P k − (gain identity) = ( I − K k H k ) P k − (factorization) . \begin{aligned}
P_k^+
&=P_k^--K_kH_kP_k^-
&&\text{(gain identity)}\\
&=(I-K_kH_k)P_k^-
&&\text{(factorization)}.
\end{aligned}
P k + = P k − − K k H k P k − = ( I − K k H k ) P k − (gain identity) (factorization) . 따라서
P k + = ( I − K k H k ) P k − \boxed{P_k^+=(I-K_kH_k)P_k^-}
P k + = ( I − K k H k ) P k − 입니다. Exact arithmetic에서는 symmetric PSD가 유지됩니다. 그러나 이 compact form은 floating-point roundoff로 symmetry를 잃기 쉽습니다.
Posterior error는
e k + = ( I − K k H k ) e k − − K k v k e_k^+=(I-K_kH_k)e_k^--K_kv_k
e k + = ( I − K k H k ) e k − − K k v k 입니다. 두 error가 independent라는 조건 아래 covariance를 직접 계산하면
P k + = ( I − K k H k ) P k − ( I − K k H k ) ⊤ + K k R k K k ⊤ \boxed{
P_k^+=
(I-K_kH_k)P_k^-(I-K_kH_k)^{\top}
+K_kR_kK_k^{\top}
}
P k + = ( I − K k H k ) P k − ( I − K k H k ) ⊤ + K k R k K k ⊤ 를 얻습니다. 이것이 Joseph form입니다.
Optimal Kalman gain을 exact arithmetic로 사용하면 compact form과 같습니다. Joseph form은 두 PSD terms의 합으로 계산하므로 finite precision에서 symmetry와 PSD를 더 안정적으로 보존합니다.
11. Unmeasured state가 갱신되는 조건
Position–velocity state를 생각하겠습니다.
P − = [ 4 1.5 1.5 1 ] , H = [ 1 0 ] , R = 1. P^-=
\begin{bmatrix}
4&1.5\\
1.5&1
\end{bmatrix},\qquad
H=\begin{bmatrix}1&0\end{bmatrix},\qquad
R=1.
P − = [ 4 1.5 1.5 1 ] , H = [ 1 0 ] , R = 1. Position만 측정하지만
S = H P − H ⊤ + R = 5 , S=HP^-H^{\top}+R=5,
S = H P − H ⊤ + R = 5 , K = P − H ⊤ S − 1 = [ 0.8 0.3 ] . K=P^-H^{\top}S^{-1}
=
\begin{bmatrix}
0.8\\0.3
\end{bmatrix}.
K = P − H ⊤ S − 1 = [ 0.8 0.3 ] . 따라서 innovation r r r
p ^ + = p ^ − + 0.8 r , v ^ + = v ^ − + 0.3 r . \hat p^+=\hat p^-+0.8r,\qquad
\hat v^+=\hat v^-+0.3r.
p ^ + = p ^ − + 0.8 r , v ^ + = v ^ − + 0.3 r . Velocity correction coefficient 0.3 0.3 0.3 1.5 1.5 1.5 0 0 0
Posterior covariance는
P + = [ 0.8 0.3 0.3 0.55 ] . P^+=
\begin{bmatrix}
0.8&0.3\\
0.3&0.55
\end{bmatrix}.
P + = [ 0.8 0.3 0.3 0.55 ] .
A position measurement narrows the joint uncertainty and shifts velocity when position and velocity errors are correlated.
이해 확인
1. P k − H k ⊤ P_k^-H_k^{\top} P k − H k ⊤ S k S_k S k
2. Position만 측정하는 예제에서 velocity gain이 0.3 0.3 0.3
3. Compact covariance update와 Joseph form의 관계를 설명하시오.
4. Actual measurement 값 y k y_k y k K k K_k K k
답
1. P k − H k ⊤ P_k^-H_k^{\top} P k − H k ⊤ S k S_k S k §3 · §4
2. Prior의 position–velocity cross-covariance가 1.5 1.5 1.5 S = 5 S=5 S = 5 1.5 / 5 = 0.3 1.5/5=0.3 1.5/5 = 0.3 §11
3. Optimal gain과 exact arithmetic에서는 두 식이 algebraically 같습니다. Joseph form은 PSD terms의 합으로 계산되어 finite precision에서 더 안정적입니다. → §10
4. Gain은 model과 uncertainty geometry가 정하는 linear map입니다. 실제 measurement 값은 innovation을 통해 posterior mean에만 들어갑니다. → §7 · §8