Kalman Filtering·Lecture 5 of 7
L5 · The Complete Recursive Filter
시리즈: Kalman Filtering · 이전: L4 · 다음: L6
이 강의는 앞에서 유도한 식을 하나의 recursive algorithm으로 조립합니다. Index convention, dimensions, numerical solve, covariance update를 구현 관점에서 점검합니다.
형광펜: 정의·핵심 · 조건·주의
목차
- 1. Index와 timing convention
- 2. Initialization
- 3. Prediction step
- 4. Correction step
- 5. 전체 pseudocode
- 6. 행렬 dimension 검사
- 7. Inverse 대신 linear solve
- 8. Symmetry와 PSD 보존
- 9. Measurement가 없을 때
- 10. Minimal NumPy implementation
1. Index와 timing convention
이 시리즈의 model은
입니다. 따라서 한 cycle의 순서는 다음과 같습니다.
- 시각 의 posterior 에서 시작합니다.
- 와 process model로 시각 의 prior 를 계산합니다.
- Measurement 가 도착하면 innovation과 gain을 계산합니다.
- 시각 의 posterior 로 correction합니다.
일부 교재는 가 에서 로 작용한다고 씁니다. 어느 convention도 가능하지만 model equation과 code index가 일치해야 합니다.
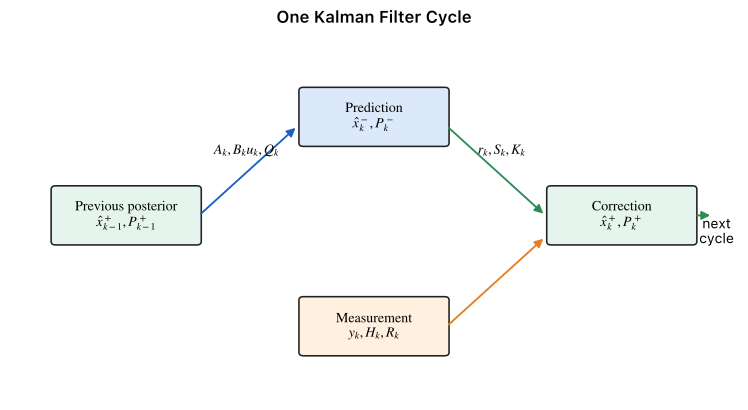
Each cycle propagates the previous posterior into a prior and then conditions that prior on the current measurement.
2. Initialization
초기값은
입니다. Initial mean을 잘 모르면 물리적으로 가능한 중심값을 두고, 그 무지를 에 반영해야 합니다.
은 초기 state를 exact하게 안다는 강한 주장입니다. 실제로 uncertainty가 있는데 으로 두면 초기 measurements를 거의 무시할 수 있습니다. 반대로 지나치게 큰 는 초기 gain과 transient를 크게 만듭니다.
3. Prediction step
Prediction은
입니다. 첫 식은 mean propagation이고, 둘째 식은 covariance propagation입니다. 유도는 L2 §2와 L2 §4에 있습니다.
4. Correction step
Measurement가 도착하면 순서대로 계산합니다.
또는 numerical robustness가 중요하면 Joseph form을 사용합니다.
5. 전체 pseudocode
given x_post, P_post
for each time k:
    x_pred = A x_post + B u
    P_pred = A P_post A^T + Q

    if measurement exists:
        residual = y - H x_pred
        S = H P_pred H^T + R
        K = solve(S, H P_pred)^T
        x_post = x_pred + K residual
        M = I - K H
        P_post = M P_pred M^T + K R K^T
    else:
        x_post = x_pred
        P_post = P_pred
solve(S, H P_pred)^T는 를 풀고 transpose해 를 얻는다는 뜻입니다.
6. 행렬 dimension 검사
| 기호 | Dimension |
|---|---|
Gain dimension은
입니다. 따라서 가 state correction 이 됩니다.
7. Inverse 대신 linear solve
수식은 로 쓰지만 code에서 explicit inverse를 만들 필요는 없습니다. 원하는 식은
이므로 transpose하면
가 symmetric PD이면 Cholesky-based solve를 사용할 수 있습니다. 이는 inverse를 먼저 계산해 곱하는 것보다 빠르고 numerical error가 작습니다.
inv(S)가 수학적으로 틀린 것은 아니지만, linear system을 푸는 문제를 불필요하게 explicit inverse 계산으로 바꾸는 구현입니다.
8. Symmetry와 PSD 보존
Covariance는 symmetric PSD여야 합니다. Exact arithmetic에서 Kalman equations는 이 성질을 보존하지만 finite precision에서는 작은 asymmetry나 negative eigenvalue가 생길 수 있습니다.
실전 순서는 다음과 같습니다.
- Correction에 Joseph form을 사용합니다.
- Gain은 linear solve로 계산합니다.
- Roundoff 수준의 asymmetry만 로 정리합니다.
- 큰 negative eigenvalue가 생기면 clipping보다 model·index·matrix multiplication 오류를 먼저 찾습니다.
Symmetrization은 잘못된 covariance model을 고치는 방법이 아닙니다. Severe conditioning에서는 square-root filter가 더 적합하지만 이 시리즈의 범위에서는 제외합니다.
9. Measurement가 없을 때
Measurement가 누락되면 correction을 건너뜁니다.
Filter를 멈추거나 이전 posterior를 그대로 유지하는 것이 아닙니다. Dynamics prediction은 계속 수행하며, process noise 때문에 uncertainty가 일반적으로 증가합니다.
Asynchronous sensors가 있으면 도착한 measurement마다 해당 와 로 correction할 수 있습니다. 다만 timestamp와 propagation interval을 정확히 처리해야 합니다.
10. Minimal NumPy implementation
다음 code는 식의 순서를 그대로 보존한 최소 implementation입니다.
import numpy as np


def predict(x, P, A, B, u, Q):
    x = A @ x + B @ u
    P = A @ P @ A.T + Q
    return x, P


def correct(x, P, y, H, R):
    r = y - H @ x
    S = H @ P @ H.T + R
    K = np.linalg.solve(S, H @ P).T
    x = x + K @ r
    I = np.eye(P.shape[0])
    M = I - K @ H
    P = M @ P @ M.T + K @ R @ K.T
    P = 0.5 * (P + P.T)
    return x, P, r, S
Production implementation에서는 dimension assertions, Cholesky failure handling, timestamp validation, innovation logging을 추가해야 합니다.
이해 확인
1. Superscript 와 가 같은 시각에서 무엇을 구분하는지 설명하시오.
2. Code에서 를 직접 계산하지 않고 Kalman gain을 구하는 linear system을 쓰시오.
3. Measurement가 누락됐을 때 covariance를 이전 posterior에 고정하면 안 되는 이유를 설명하시오.
4. Joseph form과 단순 symmetrization의 역할 차이를 설명하시오.
답
1. 는 현재 measurement를 반영하기 전의 prior이고, 는 반영한 후의 posterior입니다. → §1
2. 를 풀고 결과를 transpose합니다. → §7
3. Measurement가 없어도 dynamics와 process noise는 계속 작용하므로 prediction을 수행해 로 갱신해야 합니다. → §9
4. Joseph form은 covariance update 자체를 PSD-preserving한 합으로 계산합니다. Symmetrization은 roundoff로 생긴 작은 비대칭만 제거하며 잘못된 model이나 큰 negative eigenvalue를 해결하지 않습니다. → §8