시리즈: Kalman Filtering · 이전: L2 · 다음: L4
이 강의는 scalar prior와 scalar measurement를 결합해 Kalman correction을 유도합니다. Matrix 식에 들어가기 전에 innovation, gain, posterior variance의 역할을 한 변수에서 분리합니다.
형광펜: 정의·핵심 · 메커니즘·직관
목차
1. Predicted measurement
Prior와 measurement model을
x∼N(μ−,P−),
y=hx+v,v∼N(0,R)
로 둡니다. State prior mean이 μ−라면 predicted measurement mean은
y^−=hμ−
입니다. State unit과 measurement unit이 다를 수 있으므로, measurement y와 직접 비교할 대상은 μ−가 아니라 hμ−입니다.
2. Innovation
Innovation 또는 measurement residual을
r=y−hμ−
로 정의합니다. 이는 실제 measurement와 prior가 예측한 measurement의 차이입니다.
Innovation은 estimate error 자체가 아닙니다. Measurement space에서 관측되는 prediction error이며 sensor noise도 포함합니다. 따라서 r이 크다는 사실만으로 state estimate가 틀렸다고 판정할 수 없고, 그 크기를 innovation variance와 함께 봐야 합니다.
3. Innovation variance
x=μ−+e−로 쓰면
r=h(μ−+e−)+v−hμ−=he−+v.
e−와 v가 independent이므로
S=Var(r)=Var(he−+v)=h2P−+R(definition)(innovation substitution)(independent variance sum).
따라서
S=h2P−+R
입니다. S는 prior가 measurement space에서 만드는 uncertainty와 sensor uncertainty의 합입니다.
4. Gaussian posterior 유도
Bayes theorem에서 y에만 의존하는 normalization factor를 생략하면
p(x∣y)∝p(y∣x)p(x).
Gaussian prior와 likelihood를 대입합니다.
p(x∣y)∝exp[−2P−(x−μ−)2−2R(y−hx)2].
Exponent를 x에 대해 정리하면
P−(x−μ−)2+R(y−hx)2=(P−1+Rh2)x2−2(P−μ−+Rhy)x+constant(quadratic expansion).
Posterior precision과 mean은
P+1=P−1+Rh2,
μ+=P+(P−μ−+Rhy)
입니다. 이 precision form은 independent information이 더해진다는 사실을 직접 보여줍니다.
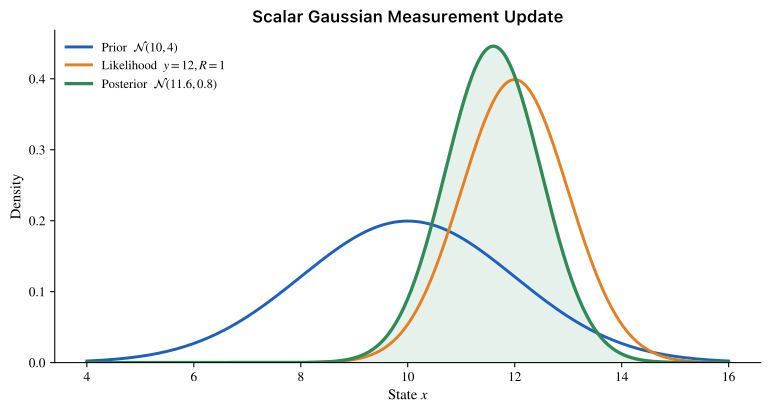
Multiplying the prior and likelihood produces a narrower posterior located between the prior mean and the measurement-implied state.
5. Scalar Kalman gain
Posterior variance를 먼저 정리합니다.
P+=(P−1+Rh2)−1=h2P−+RP−R(precision result)(fraction simplification).
Kalman gain을
K=h2P−+RP−h
로 정의합니다. Denominator는 §3의 S이므로
K=SP−h
입니다. Numerator P−h는 state error와 innovation의 covariance이고, denominator S는 innovation 자체의 variance입니다.
6. Posterior mean
Precision form의 posterior mean을 innovation form으로 바꿉니다.
μ+=h2P−+RP−R(P−μ−+Rhy)=h2P−+RRμ−+P−hy=μ−+h2P−+RP−h(y−hμ−)=μ−+Kr(posterior parameters)(cancellation)(add and subtract P−h2μ−)(gain and innovation definitions).
따라서
μ+=μ−+K(y−hμ−)
입니다. Correction은 measurement 값을 그대로 더하는 것이 아니라 예상하지 못한 부분인 innovation만 state space로 되돌려 보냅니다.
숫자로 확인하겠습니다.
μ−=10,P−=4,h=1,R=1,y=12.
그러면
S=5,K=54=0.8,r=2,
μ+=10+0.8×2=11.6.
Prior보다 measurement uncertainty가 작으므로 posterior가 measurement 쪽에 더 가깝습니다.
7. Posterior variance
Gain form으로 posterior variance를 쓰면
P+=h2P−+RP−R=(1−h2P−+RP−h2)P−=(1−Kh)P−(precision result)(common denominator)(gain definition).
따라서
P+=(1−Kh)P−
입니다. 숫자 예제에서는
P+=(1−0.8)4=0.8.
Measurement를 반영한 뒤 uncertainty가 4에서 0.8로 감소합니다. 이 감소량은 실제 measurement 값 y에 의존하지 않습니다. Linear-Gaussian model에서는 covariance update가 uncertainty geometry에만 의존하기 때문입니다.
8. Limiting cases
| 경우 |
Gain과 posterior |
의미 |
| R→0, h=0 |
Kh→1, P+→0 |
거의 noise 없는 measurement가 state를 결정 |
| P−→0 |
K→0, P+→0 |
prior가 이미 거의 확정됨 |
| R→∞ |
K→0, P+→P− |
measurement가 정보 없음 |
| h=0 |
K=0, P+=P− |
sensor가 state에 의존하지 않음 |
Gain의 크기만 독립적으로 해석하면 안 됩니다. h가 unit conversion을 포함하므로 estimate에 실제로 작용하는 비율은 Kh이고, matrix case에서는 방향별 작용을 봐야 합니다.
이해 확인
1. Innovation과 state estimation error가 다른 이유를 설명하시오.
2. S=h2P−+R의 두 항이 각각 무엇을 나타내는지 쓰시오.
3. 숫자 예제에서 posterior mean과 variance를 구하시오.
4. Actual measurement 값이 posterior covariance 식에 나타나지 않는 이유를 설명하시오.
답
1. Innovation은 measurement space의 prediction error이며 measurement noise를 포함합니다. State estimation error는 hidden state와 estimate의 차이이므로 직접 관측되지 않습니다. → §2
2. h2P−는 prior state uncertainty를 measurement space로 옮긴 variance이고, R은 sensor noise variance입니다. → §3
3. S=5, K=0.8, r=2이므로 μ+=11.6, P+=0.8입니다. → §6 · §7
4. Linear-Gaussian conditioning에서 posterior covariance는 prior covariance와 measurement model·noise covariance로 결정됩니다. Measurement 값은 posterior mean만 이동시킵니다. → §7