이 강의는 원하는 distribution에서 직접 sample을 뽑을 수 없을 때 다른 distribution의 sample로 expectation을 계산하는 방법을 다룹니다. 그 결과로 transition model로 particle을 뽑는 bootstrap particle filter에서 weight가 prior × likelihood가 아니라 likelihood만으로 정해지는 이유를 유도합니다.
L5 §4의 Monte Carlo estimator는 x(i)∼p를 직접 뽑을 수 있다는 전제에서 출발했습니다. L5 §7에서 멈춘 곳이 바로 이 전제가 깨지는 지점입니다. Transition model을 simulator로 돌리면 predicted belief p(xt∣y1:t−1)를 나타내는 particle은 만들 수 있습니다. 하지만 우리가 원하는 posterior p(xt∣y1:t)에서 바로 sample을 내주는 random number generator는 없습니다.
일반적인 형태로 문제를 적습니다. 값을 알고 싶은 것은 distribution p 아래의 expectation입니다.
Ep[f(X)]=∫f(x)p(x)dx
그런데 sample은 다른 distribution q에서만 뽑을 수 있습니다.
x(i)∼q(x),i=1,…,N
p를 target distribution, q를 proposal distribution이라고 부릅니다. Proposal은 importance distribution이라고도 합니다. 이 강의의 질문은 "q에서 뽑은 sample로 p에 대한 expectation을 어떻게 계산하는가"입니다.
Importance sampling이 요구하는 것은 두 가지입니다.
q에서 sample을 뽑을 수 있어야 합니다.
뽑힌 점마다 p(x(i))/q(x(i)), 또는 §4에서 볼 unnormalized 형태 p~(x(i))/q(x(i))를 계산할 수 있어야 합니다.
두 번째 조건 때문에 importance sampling은 target에 대해 아무것도 모를 때 쓰는 방법이 아닙니다. Target의 값을 점마다 계산할 수는 있지만 그 distribution에서 sample을 뽑기는 어려운 상황에 쓰는 방법입니다.
RL에서 이미 같은 비율을 만났습니다. Importance Sampling in Off-Policy RL에서는 behaviour policy μ로 모은 데이터로 target policy π의 return을 추정했고, 그때 쓴 비율이 target 확률 / sampling 확률이었습니다. 거기서는 sample이 state와 action이 이어진 trajectory 전체였고 environment의 transition 확률이 분자와 분모에서 약분되어 step마다의 π/μ의 곱이 남았습니다. 이 강의에서는 sample이 state 하나이므로 비율도 하나입니다.
2. Weight의 직관
세 값짜리 예시
X∈{A,B,C}이고 target과 proposal이 다음과 같다고 합시다.
p=[0.1,0.2,0.7],q=[0.4,0.4,0.2]
q에서 그냥 뽑으면 C는 20%만 나오는데 target에서는 70%입니다. 반대로 A는 target에서 10%인데 proposal에서는 40%나 나옵니다. 따라서 q의 sample을 그대로 세면 C는 너무 적게, A는 너무 많게 셉니다.
보정은 sample 하나가 몇 개로 세어져야 하는지를 바꾸는 방식으로 합니다. 비율을 계산합니다.
w(x)=p(x)/q(x)는 "target에서 x가 나오는 확률이 proposal에서 x가 나오는 확률의 몇 배인가"라고 읽습니다. Proposal이 A를 target보다 4배 자주 뽑으므로 A sample 하나는 0.25개로 세고, C는 target보다 3.5배 드물게 뽑으므로 C sample 하나는 3.5개로 셉니다. 이 w를 importance weight라고 합니다.
10개를 뽑아서 세기
q에서 10개를 뽑았더니 A,B,A,A,B,C,B,A,B,C가 나왔다고 합시다.
값
개수
그냥 센 비율
w
개수 × w
weight로 센 비율 (÷ 10)
A
4
0.4
0.25
1.0
0.1
B
4
0.4
0.5
2.0
0.2
C
2
0.2
3.5
7.0
0.7
합
10
1
10.0
1.0
P(C)를 그냥 센 비율로 추정하면 0.2이고, 이것은 target이 아니라 proposal의 확률입니다. Weight를 곱해 세면 101(3.5+3.5)=0.7이 되어 target의 p(C)와 같습니다.
이 10개는 개수 비율이 q와 정확히 같게 골라 둔 sample이라서 추정이 정확히 맞았습니다. 실제로 무작위로 뽑으면 개수가 정확히 4, 4, 2로 나올 확률은 약 0.083입니다. 같은 q에서 다시 10개를 뽑았더니 B,C,B,A,A,C,A,C,B,B가 나왔습니다 (A 3개, B 4개, C 3개).
추정
P(A)
P(B)
P(C)
그냥 센 비율
0.3
0.4
0.3
N1∑iw(i)1{x(i)=⋅}
0.075
0.2
1.05
∑iwˉ(i)1{x(i)=⋅}
0.057
0.151
0.792
target p
0.1
0.2
0.7
둘째 줄은 weight를 곱해 더한 뒤 N=10으로 나눈 값입니다. P(C) 추정이 1.05로 1을 넘었습니다. 이 sample에서 weight의 합은 3(0.25)+4(0.5)+3(3.5)=13.25라서 10보다 크고, 그만큼 전체가 부풀었습니다.
셋째 줄은 N 대신 weight의 합 13.25로 나눈 값입니다. wˉ(i)=w(i)/∑jw(j)를 normalized weight라고 하고, 합이 1이므로 확률 추정이 0과 1 사이에 머뭅니다. Weight의 합으로 나누는 이 방식이 particle filter가 쓰는 방식입니다. 이 방식이 왜 맞는지와 무엇을 대가로 치르는지는 §4에서 봅니다.
3. Expectation에서 유도하기
Discrete case에서 한 줄씩
이 절 전체에서 아래 Support condition, 즉 p(x)>0인 곳에서는 q(x)>0이라고 가정합니다. p(x)=0인 항은 합에 기여하지 않으므로 합을 p(x)>0인 x로 제한할 수 있고, 그 x에서는 q(x)/q(x)=1을 곱해도 값이 변하지 않습니다. p(x)=0인 곳에서는 w(x)=0으로 둡니다.
Ep[f(X)]=x:p(x)>0∑f(x)p(x)=x:p(x)>0∑f(x)q(x)p(x)q(x)=Eq[f(X)w(X)](definition of expectation; terms with p(x)=0 vanish)(multiply and divide by q(x)>0, by the support condition)(definition of expectation under q,w=p/q)
셋째 줄의 Eq[⋅]는 "X가 q를 따를 때의 expectation"이라고 읽습니다. 합 안의 q(x)가 확률 자리에 있고 나머지 f(x)w(x)가 값 자리에 있으므로, q 아래에서 함수 f⋅w의 expectation입니다. §2의 예에서 f=1{x=C}로 두면 ∑x1{x=C}w(x)q(x)=3.5×0.2=0.7=p(C)입니다.
Continuous case
Continuous variable에서는 합이 적분이 될 뿐 같은 계산입니다. 적분 범위를 p(x)>0인 곳으로 제한하고, 그 밖에서는 w(x)=0으로 둡니다.
Ep[f(X)]=∫{p>0}f(x)p(x)dx=∫{p>0}f(x)q(x)p(x)q(x)dx=Eq[f(X)q(X)p(X)](definition of expectation)(multiply and divide by q(x)>0, by the support condition)(definition of expectation under q)
Ep[f(X)]=Eq[f(X)q(X)p(X)],if p(x)>0⇒q(x)>0
Importance sampling의 출발점은 이 identity입니다. p에 대한 expectation을 q에 대한 expectation으로 바꿔 쓴 것입니다. 우변은 q 아래의 expectation이므로 L5 §4의 Monte Carlo estimator를 함수 g(x)=f(x)w(x)에 그대로 적용할 수 있습니다.
I^NIS=N1i=1∑Nf(x(i))w(x(i)),x(i)∼qi.i.d.
Support condition이 성립하면 L5 §4의 결과가 g에 대해 그대로 성립합니다. E[I^NIS]=Eq[fw]=Ep[f]이므로 unbiased이고 (Bias and Variance), Varq(fw)가 유한하면 standard deviation이 Varq(fw)/N로 줄어듭니다.
Weight의 평균은 1이다
f=1로 두면 weight 자체의 expectation이 나옵니다.
Eq[w(X)]=∫{q>0}q(x)p(x)q(x)dx=∫{q>0}p(x)dx=1(definition of expectation under q)(cancel q)(support condition, p integrates to 1)
§2의 예로 확인하면 0.4(0.25)+0.4(0.5)+0.2(3.5)=0.1+0.2+0.7=1입니다. 따라서 N개 weight의 합은 1 근처가 아니라 N 근처에 있습니다. §2의 두 sample에서 합이 10.0과 13.25였던 것이 이것입니다.
f=1이면 estimator가 N1∑iw(i) 자체라서, 두 번째 sample에서는 참값 1 대신 13.25/10=1.325가 나옵니다. 일반 f의 오차는 weight 합만으로 정해지지 않지만, §2의 P(C) 추정 1.05도 이 sample에서 나왔습니다.
Support condition
위 유도의 둘째 줄에서 q(x)로 나누는 것은 q(x)>0인 곳에서만 할 수 있습니다. 그래서 유도 전체가 다음 조건을 가정했습니다.
p(x)>0⇒q(x)>0
말로는 "proposal의 support가 target의 support를 덮는다"고 합니다. 이 조건이 깨지면 N을 아무리 늘려도 고쳐지지 않습니다. 예를 들어 q′=[0.5,0.5,0]이면 C는 한 번도 뽑히지 않으므로, 모든 sample에서 w⋅1{x=C}=0이고 P(C) 추정은 항상 0입니다. 실제 값은 0.7입니다.
이때 Eq′[w]=0.1+0.2=0.3으로 1이 되지 않는 것도 같은 원인입니다. Sample이 전혀 오지 않는 영역의 기여는 weight로 보정할 수 없습니다.
Support condition은 identity가 성립하기 위한 조건일 뿐, 추정이 좋다는 보장은 아닙니다. q가 p보다 훨씬 작은 영역이 있으면 그곳에 가끔 떨어진 sample이 매우 큰 weight를 받고 variance가 커집니다. Particle filter에서 이 문제가 어떻게 나타나는지는 L7 §2에서 다룹니다.
4. Normalization constant를 모를 때
Unnormalized target이 나오는 곳
§3은 p(x) 값을 점마다 정확히 계산할 수 있다고 가정했습니다. Bayesian 계산에서는 보통 그렇지 않습니다. Posterior는 L2 §4에서 본 것처럼 다음 모양입니다.
p(x∣y)=p(y)p(y∣x)p(x),p(y)=∫p(y∣x)p(x)dx
분자는 x 하나를 주면 measurement model과 prior로 계산됩니다. 분모는 x 전체에 대한 적분입니다. 이런 구조를 일반적으로 다음처럼 씁니다.
p(x)=Zp~(x),Z=∫p~(x)dx
p~(x)는 "p tilde"라고 읽고, 모양은 target과 같지만 적분이 1이 아닌 함수입니다. p~를 unnormalized target, Z를 normalization constant라고 합니다. Target이 posterior p(x∣y)인 경우에는 p~(x)=p(y∣x)p(x)이고 Z=p(y)입니다. 이 식의 p(x)는 target이 아니라 prior입니다.
한 점에서 계산하기와 전체를 적분하기
Bayes 식이 아닌 예도 하나 봅니다. p~(x)=e−V(x)이고 V(x)=2(x2−1)2−0.5x라고 합시다. x=1을 주면 V(1)=−0.5이므로 p~(1)=e0.5≈1.649입니다. x=−1이면 e−0.5≈0.607, x=0이면 e−2≈0.135입니다. 점 하나의 값은 함수 호출 한 번으로 나옵니다.
반면 Z=∫e−V(x)dx는 모든 x에 대한 계산입니다. 이 예는 1차원이라 수치적분으로 Z≈1.565를 구할 수 있지만, x가 n차원이면 L4 §7의 grid 비용 Mn이 그대로 돌아옵니다.
계산
필요한 것
비용
p~(x(i))
점 하나에서 함수 평가
sample 수 N에 비례
Z=∫p~(x)dx
state space 전체에 대한 적분
고차원에서 closed form이 없으면 grid Mn
x(i)∼p
target의 sample generator
일반적으로 없음
p~라는 기호를 쓴다고 해서 어떤 적분도 쉬워지지 않습니다. Posterior의 경우 Z=∫p~(x)dx와 p(y)=∫p(y∣x)p(x)dx는 같은 적분을 다르게 쓴 것입니다. p~가 하는 일은 점마다 계산되는 부분과 적분이 필요한 부분을 식에서 분리해 보여주는 것뿐입니다.
w~(i)=p~(x(i))/q(x(i))로 두면 w(i)=w~(i)/Z입니다. 1/Z는 모든 sample에 같은 값이므로 sample 사이의 상대적인 크기는 w~(i)만으로 정해집니다. 그러나 §3의 estimator N1∑if(x(i))w(i)는 Z 값을 알아야 계산됩니다. 그래서 estimator 자체를 바꿉니다.
Ep[f(X)]=Z1∫f(x)p~(x)dx=∫p~(x)dx∫f(x)p~(x)dx=∫w~(x)q(x)dx∫f(x)w~(x)q(x)dx=Eq[w~(X)]Eq[f(X)w~(X)]≈N1∑jw~(j)N1∑if(x(i))w~(i)=i=1∑Nwˉ(i)f(x(i))(p=p~/Z)(Z=∫p~(x)dx)(multiply and divide by q,w~=p~/q)(definition of expectation under q)(Monte Carlo with the same x(i)∼q)(cancel N1,wˉ(i)=w~(i)/∑jw~(j))
이것을 self-normalized importance sampling이라고 합니다. 마지막 식에는 Z가 없고 p~와 q의 점 값만 들어갑니다.
Z는 피한 것이 아니라 같은 sample로 추정한 것이다
유도의 다섯째 줄 분모를 따로 봅니다.
Eq[w~(X)]=∫q(x)p~(x)q(x)dx=∫p~(x)dx=Z(definition of expectation under q)(support condition)
따라서 Z^=N1∑jw~(j)는 Z의 Monte Carlo estimator이고, unbiased입니다. Self-normalized estimator를 다시 쓰면 ∑iwˉ(i)f(x(i))=N1∑if(x(i))w~(i)/Z^입니다. §3의 estimator에서 모르는 Z 자리에 같은 sample로 만든 추정값 Z^를 넣은 것입니다. 적분이 사라진 것이 아니라, 적분도 sample 평균으로 추정되고 있습니다.
숫자로 확인합니다. 세 sample에서 w~=[2,5,3]이 나왔다고 합시다. 이 값은 어떤 unnormalized target과 proposal의 비율 p~/q입니다. 비율이므로 q가 작은 점에서는 1을 넘을 수 있습니다.
Normalized weight: wˉ=[2,5,3]/10=[0.2,0.5,0.3]
Z의 추정: Z^=31(2+5+3)≈3.33
실제 Z가 4였다면 참 weight는 w=w~/4=[0.5,1.25,0.75]이고 합은 2.5입니다. 합이 1이 아니라 N=3 근처에 있고, normalize하면 역시 [0.2,0.5,0.3]입니다.
Self-normalization이 하는 일
wˉ(i)는 Z를 알든 모르든 같은 값입니다. 대신 estimator는 모르는 Z를 Z^=N1∑jw~(j)로 추정해서 씁니다. 필요한 것은 점마다 p~/q를 계산하는 것이고, 전체 적분은 같은 sample의 평균으로 대신합니다.
Continuous 예시
위의 p~(x)=e−V(x)를 target으로, q=N(0,1.52)를 proposal로 씁니다. q는 모든 실수에서 양수이므로 support condition이 성립합니다. 1차원이므로 수치적분으로 정답을 구해 비교할 수 있습니다.
Z^
∑iwˉ(i)x(i) (≈ Ep[X])
∑iwˉ(i)1{x(i)>0} (≈ P(X>0))
N=1,000
1.607
0.428
0.709
N=100,000
1.563
0.399
0.703
수치적분
Z=1.565
0.403
0.704
N=1,000일 때 참 weight w~(i)/Z의 합은 약 1027로, §3에서 말한 대로 N 근처입니다.
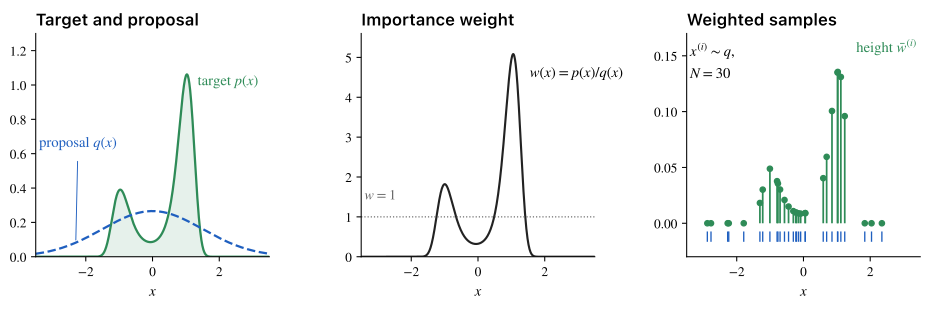
왼쪽: target p(x)∝e−V(x), V(x)=2(x2−1)2−0.5x (초록 실선)과 proposal q=N(0,1.52) (파랑 점선). 가운데: weight p/q. 이 곡선을 그릴 때만 수치적분으로 구한 Z로 p를 normalize했습니다. 오른쪽: q에서 뽑은 30개 sample의 위치(아래 눈금)와 normalized weight(막대); ∣x∣>1.8에 떨어진 sample의 normalized weight는 10−5보다 작습니다.
그림 가운데 panel에서 weight는 target의 큰 mode(x≈1.06) 근처에서 최대 약 5.08까지 올라가고, ∣x∣>1.8에서는 0.001보다 작습니다. Proposal이 넓게 뿌린 sample 중 target이 proposal에 비해 큰 곳(p/q가 큰 곳)에 떨어진 것만 큰 weight를 받아서, 막대의 높이와 위치를 함께 보면 target의 모양이 드러납니다.
Finite N에서는 bias가 있다
Self-normalized estimator는 unbiased가 아닙니다. 가장 쉬운 경우인 N=1을 봅니다. Sample이 하나면 wˉ(1)=1이므로 estimator는 f(x(1))이고, x(1)∼q이므로 그 expectation은 Eq[f(X)]입니다. Ep[f(X)]가 아닙니다.
§2의 discrete 예에서 f=1{x=C}로 두고, 가능한 모든 sample 조합에 대해 estimator의 expectation을 정확히 계산하면 다음과 같습니다.
N
1
2
5
10
100
E[∑iwˉ(i)1{x(i)=C}]
0.2
0.329
0.518
0.616
0.693
E[N1∑iw(i)1{x(i)=C}]
0.7
0.7
0.7
0.7
0.7
N=1에서는 q(C)=0.2이고, N이 커지면 p(C)=0.7에 다가갑니다. 유도의 분자와 분모는 각각 law of large numbers로 Eq[fw~]와 Z>0에 수렴하므로, 두 값의 비율인 estimator는 참값에 수렴합니다. 이 예에서는 estimator가 항상 0과 1 사이에 있으므로 그 expectation도 0.7로 다가가고, 표가 그것을 보여 줍니다. Self-normalized estimator는 finite N에서 biased이고, N→∞에서 참값에 수렴(consistent)합니다. (Bias and Variance)
이 bias를 받아들이는 이유는 두 가지입니다. 첫째, Z를 모르면 unbiased인 §3의 estimator는 애초에 계산할 수 없습니다. 둘째, wˉ(i)가 합이 1인 음이 아닌 수이므로 estimator는 f(x(i)) 값들의 weighted average이고, §2의 1.05 같은 범위 밖의 값이 나오지 않습니다.
여기서 p~(xt)=p(yt∣xt)belt(xt)로 두면 Z는 evidence p(yt∣y1:t−1)이고, 이 Z는 self-normalization에서 같은 sample의 Z^로 추정됩니다. 그런데 p~ 자체도 점마다 계산되지 않습니다. belt(xt) 값 하나가 xt−1 전체에 대한 prediction 적분이기 때문입니다. 이 문제를 §6에서 풉니다.
5. Weighted particle set
묶음으로 distribution을 나타내기
Importance sampling의 결과는 위치와 weight의 쌍입니다.
{(x(i),wˉ(i))}i=1N
"위치 x(i)와 normalized weight wˉ(i)의 쌍 N개"라고 읽습니다. 이것을 weighted particle set이라고 합니다. L5의 particle 묶음은 모든 weight가 1/N인 특수한 경우입니다.
이 묶음을 distribution처럼 쓰기 위해 다음 기호를 씁니다.
p^(x)=i=1∑Nwˉ(i)δ(x−x(i))
p^는 "p hat"이라고 읽고, 각 particle 위치에 weight만큼의 mass를 둔 approximation입니다.
여기의 δ는 Dirac delta다
δ(x−x(i))는 Signals & Systems의 continuous-time δ(t)와 같은 대상입니다. 독립변수가 시간 t에서 state x로 바뀌었을 뿐입니다. Dirac delta는 점마다 값을 갖는 보통 함수가 아니라, 적분 안에서 다음 sifting property로 정의되는 대상입니다.
∫f(x)δ(x−a)dx=f(a)
이 성질로 p^ 아래의 expectation을 계산합니다.
∫f(x)p^(x)dx=∫f(x)i=1∑Nwˉ(i)δ(x−x(i))dx=i=1∑Nwˉ(i)∫f(x)δ(x−x(i))dx=i=1∑Nwˉ(i)f(x(i))(definition of p^)(swap sum and integral)(sifting property)
f=1이면 ∫p^(x)dx=∑iwˉ(i)=1입니다. p^ 아래의 expectation이 §4의 self-normalized estimator와 정확히 같습니다. 그래서 weighted particle set을 "distribution p^"로 다룰 수 있습니다.
p^≈p는 함수 값이 비슷하다는 뜻이 아닙니다. p^는 particle 위치 밖에서는 mass가 없고 위치에서는 값이 정의되지 않습니다. 이 근사는 expectation에 대한 것입니다. 즉 적당한 f에 대해 ∑iwˉ(i)f(x(i))≈Ep[f(X)]라는 뜻이고, 구간 확률은 f가 indicator인 경우라서 P(a≤X≤b)≈∑i:a≤x(i)≤bwˉ(i)입니다.
Discrete state에서는 indicator를 쓴다
Signals & Systems의 discrete-time δ[n]은 Kronecker delta로, n=0에서 값 1, 나머지에서 0인 보통 함수입니다. Dirac delta와는 다른 대상입니다. State가 discrete이면 p^를 PMF로 적어야 하므로 Kronecker delta와 같은 뜻인 indicator를 씁니다.
p^(x)=i=1∑Nwˉ(i)1{x=x(i)}
같은 값에 particle이 여럿 있으면 weight가 더해집니다. Particle 위치가 [A,C,C]이고 wˉ=[0.2,0.5,0.3]이면 p^(A)=0.2, p^(B)=0, p^(C)=0.5+0.3=0.8입니다.
State
기호
대상
확률을 얻는 방법
Continuous
δ(x−x(i))
Dirac delta (적분 안에서만 의미)
구간의 weight 합, 또는 ∫fp^dx
Discrete
1{x=x(i)}
값이 0 또는 1인 함수
p^(x) 값 자체가 확률
확률·ML 문헌에서는 두 경우 모두 δ라고 느슨하게 쓰기도 합니다. 이 시리즈에서는 continuous state에 δ(⋅), discrete state에 1{⋅}을 씁니다.
6. Particle filter의 weight는 왜 likelihood인가
전제
시각 t−1에서 posterior belt−1을 나타내는 weighted particle set {(xt−1(j),wˉt−1(j))}j=1N이 있다고 합시다. Resampling을 막 거쳤다면 L7 §4에서 볼 것처럼 모든 weight가 1/N입니다. t=1에서는 x0(j)∼p(x0)이므로 역시 1/N입니다.
1단계: 정확한 target 대신 쓸 수 있는 target
§4 끝에서 본 대로 정확한 unnormalized target p(yt∣xt)belt(xt)는 점마다 계산할 수 없습니다. 그래서 prediction 적분 안의 belt−1을 §5의 p^로 바꿉니다.
belt(xt)=∫p(xt∣xt−1)belt−1(xt−1)dxt−1≈∫p(xt∣xt−1)j=1∑Nwˉt−1(j)δ(xt−1−xt−1(j))dxt−1=j=1∑Nwˉt−1(j)∫p(xt∣xt−1)δ(xt−1−xt−1(j))dxt−1=j=1∑Nwˉt−1(j)p(xt∣xt−1(j))(prediction step)(weighted particle approximation of belt−1)(swap sum and integral)(sifting property)
마지막 식을 p^(xt∣y1:t−1)로 씁니다. Weight가 모두 1/N이면 L5 §6의 mixture N1∑jp(xt∣xt−1(j))와 같습니다. 이 mixture로 만든 target을 importance sampling의 target으로 삼습니다.
이 proposal에서 뽑는 방법은 L5에서 이미 봤습니다. 조상 번호 J를 확률 wˉt−1(J)로 고르고, xt∼p(xt∣xt−1(J))를 뽑습니다. Weight가 모두 1/N이면 조상 번호를 뽑는 대신 L5 §5의 propagation 코드처럼 조상을 하나씩 차례로 써도 됩니다. 이렇게 만든 particle의 평균 N1∑if(xt(i))도 그 expectation이 mixture에 대한 expectation과 같습니다 (L5 §6). Proposal에서 뽑는 데는 transition model을 simulator로 실행하는 것만 필요하고, mixture의 density 값은 한 번도 계산하지 않습니다.
w~t(i)=q(xt(i))p~(xt(i))=p^(xt(i)∣y1:t−1)p(yt∣xt(i))p^(xt(i)∣y1:t−1)=p(yt∣xt(i))(importance weight with unnormalized target)(substitute target and proposal)(p^(xt(i)∣y1:t−1)>0 at a point sampled from it)
wt(i)∝p(yt∣xt(i)),xt(i)∼p^(xt∣y1:t−1)
Mixture p^(xt∣y1:t−1)에서, 즉 조상을 wˉt−1에 비례해 고른 뒤 transition model로 particle을 뽑으면 weight는 likelihood 하나입니다. Resampling 직후처럼 t−1의 weight가 모두 같으면 조상을 차례로 써도 같은 결과입니다. 이 proposal을 쓰고 매 step resampling하는 particle filter를 bootstrap filter라고 합니다 (L7 §7). Support condition도 따로 확인할 필요가 없습니다. Target p(yt∣xt)p^는 p^가 0인 곳에서 0이므로 proposal p^가 target의 support를 항상 덮습니다.
다만 support가 덮인다고 해서 모든 weight가 0이 되는 일까지 막히지는 않습니다. Noise가 없는 sensor처럼 likelihood가 xt 공간에서 부피가 0인 집합 위에서만 양수이고 p^가 density를 가지면, 뽑은 particle의 likelihood는 probability 1로 모두 0입니다. 그러면 ∑jp(yt∣xt(j))=0이어서 wˉt가 정의되지 않습니다.
흔히 쓰는 해결책은 measurement model의 noise를 실제 sensor보다 크게 잡는 것입니다. 대신 filter가 근사하는 posterior는 원래 model의 posterior와 달라집니다. 다른 방법은 yt까지 써서 particle을 뽑는 proposal입니다. Likelihood가 0은 아니지만 transition이 퍼뜨린 폭보다 훨씬 날카로울 때 생기는 문제는 L7 §2에서 봅니다.
Normalize는 §4대로 합니다. wˉt(i)=p(yt∣xt(i))/∑jp(yt∣xt(j))입니다. 이때 §4의 Z^에 해당하는 N1∑jp(yt∣xt(j))는 ∫p(yt∣xt)p^(xt∣y1:t−1)dxt의 추정값이고, p^가 belt에 가까운 만큼 evidence p(yt∣y1:t−1)의 추정값이 됩니다.
근사는 어디서 들어오는가
위의 약분은 1단계에서 만든 target p(yt∣xt)p^(xt∣y1:t−1)에 대해서는 정확합니다. 근사는 1단계에서 belt−1을 유한한 particle로 바꾼 곳에서 들어오고, 이 Monte Carlo error가 다음 시각으로 넘어갑니다. 여기에 3단계의 weighted set 자체가 유한한 sample이라는 Monte Carlo error가 더해집니다.
또 weight를 likelihood의 합으로 나누는 self-normalization 때문에, finite N에서는 random한 Monte Carlo error와 별개로 bias가 있습니다 (§4). 극단적으로 N=1이면 wˉt(1)=1이어서 yt가 결과에 전혀 반영되지 않고, estimator의 expectation은 posterior가 아니라 proposal p^(xt∣y1:t−1)에 대한 expectation이 됩니다. 이 bias는 N→∞에서 사라집니다.
정확한 belt를 proposal로 쓴다고 해도 결과식은 같은 모양으로 약분됩니다. 하지만 그 distribution에서는 뽑을 수 없고, 실제로 뽑는 것은 mixture입니다. p^의 값은 transition density를 계산할 수 있다면 점 하나당 N개 항의 합으로 계산할 수는 있지만, 약분 덕분에 그 계산도 필요 없습니다. Transition model은 sample만 뽑을 수 있으면 됩니다.
t−1의 weight가 같지 않은 채로 각 particle이 자기 조상을 그대로 쓰면, 그 proposal은 위의 mixture가 아닙니다. 그 경우의 weight는 이전 weight가 곱해진 wt(i)∝wt−1(i)p(yt∣xt(i)) 꼴이 되고, trajectory 전체를 target으로 두는 다른 유도가 필요합니다. 이 유도는 L7 §1에서 합니다. 3단계 끝에서 말한, measurement yt까지 쓰는 proposal은 이 시리즈에서 다루지 않습니다.
Prior는 particle 위치에 이미 들어 있다
Predicted belief가 x≈0 근처에 70%, x≈10 근처에 30%라고 합시다. Particle 100개를 propagation으로 만들면 대략 70개가 0 근처, 30개가 10 근처에 놓입니다. Prior의 정보는 이미 개수로 들어가 있습니다.
이번 measurement가 x≈10과 잘 맞는다면, 10 근처의 particle은 큰 likelihood를, 0 근처의 particle은 작은 likelihood를 받습니다. 각 particle에 묻는 질문은 "이 particle이 실제 state라면 방금 받은 yt가 나올 density가 얼마인가" 하나이고, prior를 묻는 질문은 위치를 정할 때 이미 끝났습니다.
Prior를 한 번 더 곱하면
L2 §5의 복도 예로 확인합니다. Prior [0.2,0.6,0.2], likelihood [0.05,0.8,0.1]이고 정확한 posterior는 약 [0.020,0.941,0.039]였습니다. Prior에서 뽑은 particle 10개가 칸 1, 2, 3에 정확히 2, 6, 2개 있다고 합시다.
Likelihood만 weight로 쓰면 칸별 weight 합이 2(0.05)=0.1, 6(0.8)=4.8, 2(0.1)=0.2이고, 전체 5.1로 나누면 [0.0196,0.941,0.0392]입니다. 개수를 prior에 정확히 맞춰 두었기 때문에 정확한 posterior와 정확히 같고, 실제로 뽑은 particle에서는 근사적으로 같습니다.
Prior × likelihood를 weight로 쓰면 칸별 합이 2(0.01)=0.02, 6(0.48)=2.88, 2(0.02)=0.04이고, 전체 2.94로 나누면 [0.0068,0.980,0.0136]입니다. 이것은 p(y∣x)p(x)2을 normalize한 값과 같습니다. 이것도 개수를 prior에 맞춰 두었기 때문에 정확히 같고, 실제로 뽑은 particle에서는 근사적으로 같습니다.
Particle weight에 prior를 곱하지 않는다
Prior × likelihood가 unnormalized posterior인 것은 고정된 후보 state(grid) 위에서입니다. Particle을 prior에서 뽑았다면 prior는 위치에 이미 반영되어 있고, weight에 prior를 또 곱하면 weighted set은 p(y∣x)p(x)2에 비례하는 잘못된 distribution을 나타냅니다.
Weight에 어떤 factor가 들어가는지는 proposal이 정합니다. 후보 state를 uniform proposal에서 뽑았다면 q가 상수이므로 weight는 p~/q∝p(y∣x)p(x)가 되어 prior × likelihood가 맞습니다. Proposal이 prior이면 prior가 약분되고 likelihood만 남습니다.
7. 숫자로 보는 weighting
모델과 계산
Propagation을 마친 particle 5개가 다음 위치에 있고, weight는 모두 같다고 합시다.
xt(1:5)=[1.0,2.0,2.2,5.0,8.0]
Measurement model은 yt=xt+νt, νt∼N(0,0.32)입니다. L3 §3에서처럼 이 식이 likelihood를 정합니다.
받은 measurement는 yt=2.1입니다. 각 particle에서 likelihood를 계산하고 합으로 나눕니다.
i
xt(i)
yt−xt(i)
지수 −(yt−xt(i))2/(2⋅0.32)
p(yt∣xt(i))
wˉt(i)
1
1.0
1.1
−6.722
0.0016
0.00064
2
2.0
0.1
−0.0556
1.258
0.4997
3
2.2
−0.1
−0.0556
1.258
0.4997
4
5.0
−2.9
−46.72
6.8×10⁻²¹
2.7×10⁻²¹
5
8.0
−5.9
−193.4
1.4×10−84
5.4×10−85
합
2.517
1
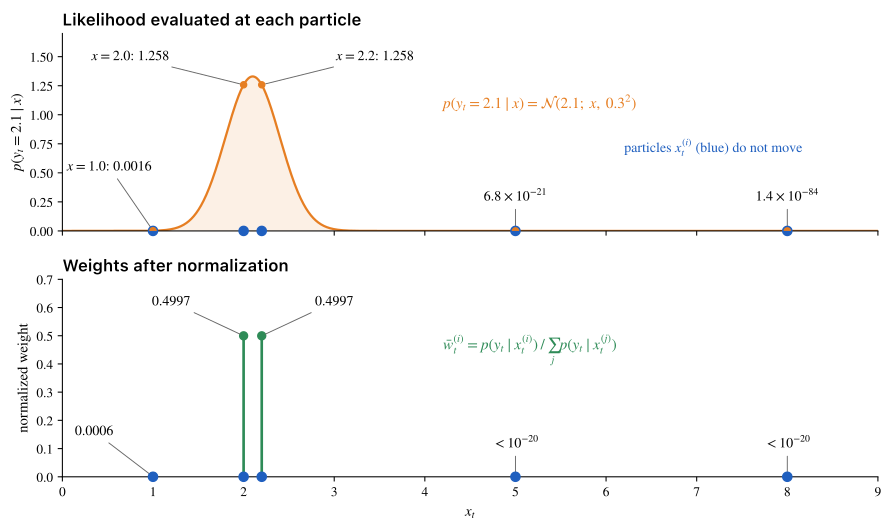
Likelihood 1.258은 1을 넘지만 오류가 아닙니다. yt가 continuous라서 likelihood는 확률이 아니라 density 값이고, noise가 좁을수록 density는 커집니다 (L1 §7). Normalize하면 합이 1이 되므로 weight에는 문제가 없습니다.
위: yt=2.1일 때 x의 함수로 본 likelihood N(2.1;x,0.32)와 다섯 particle 위치에서의 값. 아래: 합으로 나눈 normalized weight. 위치(파란 점)는 두 panel에서 같습니다.
이 모델은 noise가 더해지므로 p(yt∣xt)=pν(yt−xt)이고, Gaussian noise density가 대칭이라서 그림 위 panel의 곡선이 x에 대해서도 같은 Gaussian 모양입니다. 이 경우에는 x로 적분해도 ∫pν(u)du=1입니다. 일반적인 measurement model에서는 likelihood를 x로 적분한 값이 1이 아닙니다 (L2 §2). 그래서 위 panel의 세로축은 x의 density가 아니라 yt에 대한 density 값입니다.
무엇이 바뀌었고 무엇이 그대로인가
Particle의 위치는 [1.0,2.0,2.2,5.0,8.0] 그대로입니다. 바뀐 것은 weight뿐입니다. Weighting 뒤의 묶음 {(xt(i),wˉt(i))}가 posterior belt를 나타냅니다. §5에서 정리한 뜻, 즉 expectation을 근사한다는 뜻입니다.
Posterior mean을 추정하면 ∑iwˉt(i)xt(i)≈2.099입니다. 같은 weight로 본 predicted mean 51∑ixt(i)=3.64에서 measurement 쪽으로 옮겨졌습니다. Likelihood의 평균 2.517/5≈0.503은 §6에서 말한 evidence p(yt∣y1:t−1)의 추정값입니다. Particle이 5개뿐이라 거친 추정입니다.
5.0과 8.0의 particle은 weight가 10−20보다 작아서 추정에 기여하지 않지만, 계산과 메모리는 똑같이 차지합니다. 이 문제가 시간이 지나며 쌓이는 과정과 resampling은 L7 §1에서 시작합니다.
코드
# x: particles at t after propagation (equal weights)
# y: received measurement y_t
input : x[1..N], y
for i = 1..N:
    # p(y_t | x_t^(i))
    w[i] = normal_pdf(y; mean = x[i], std = 0.3)
s = sum over i of w[i]
for i = 1..N:
    w_bar[i] = w[i] / s
# estimate of E[x_t | y_{1:t}]
mean_est     = sum over i of w_bar[i] * x[i]
# estimate of p(y_t | y_{1:t-1})
evidence_est = s / N
output: x[1..N] (unchanged), w_bar[1..N]
이 모델에서 measurement와 약 11.6 이상 떨어진 particle은 likelihood가 float64의 가장 작은 양수보다 작아져 0으로 반올림됩니다. 그래서 실제 구현에서는 likelihood 대신 log-likelihood를 계산하고, 가장 큰 값을 뺀 뒤 exponential을 취해 normalize하는 방식을 씁니다. 이 방법이 막는 것은 floating-point underflow뿐입니다. §6에서 본 것처럼 likelihood가 실제로 모두 0이면 log-likelihood가 모두 −∞라서 여전히 normalize할 수 없습니다.
L5 끝의 알고리즘에서 비어 있던 weighting 줄이 채워졌습니다.
for i = 1..N:
    # initial particles (L5)
    x[0][i] ~ p(x_0)
for t = 1, 2, ...:
    for i = 1..N:
        # propagate (L5); x[t-1] has equal weights
        x[t][i] ~ p(x_t | x[t-1][i])
        # weight (this lecture)
        w[i] = p(y_t | x[t][i])
    # normalize (this lecture)
    w_bar = w / sum(w)
    # back to equal weights 1/N (L7)
    x[t] = resample(x[t], w_bar)
마지막 resample 줄이 있어야 다음 반복에서 x[t−1]의 weight가 모두 같고, §6의 약분이 성립합니다. 이 줄을 빼면 weight는 wt−1(i)p(yt∣xt(i))로 바꿔야 합니다 (L7 §1). Resampling이 무엇이고 estimate를 왜 그 전에 계산하는지는 L7에서 다룹니다.
이해 확인
1.§2의 예에서 A sample 하나를 0.25개로 세는 이유를 p(x)/q(x)로 설명하시오. 또 q(C)=0인 proposal을 쓰면 N을 늘려도 P(C)를 추정할 수 없는 이유를 설명하시오.
2. "Self-normalized importance sampling은 normalization constant Z를 계산하지 않아도 된다"는 문장에서 맞는 부분과 부정확한 부분을 각각 설명하시오. 또 이 방법이 치르는 대가는 무엇인가?
3. Bootstrap particle filter에서 target은 p(yt∣xt)p^(xt∣y1:t−1)이다. Weight에 p^ 값이 들어가지 않는 이유를 설명하시오. 또 그래도 weight에 prior를 곱하면 weighted set은 무엇을 나타내는가?
4.§7에서 ∑iwˉt(i)xt(i)≈2.099를 posterior mean의 추정으로 썼다. 이 식이 posterior expectation의 근사인 이유를 p^와 sifting property로 설명하시오.
답
1.A는 target 확률 0.1, proposal 확률 0.4라서 proposal이 target보다 4배 자주 뽑습니다. 그래서 A sample 하나의 기여를 0.1/0.4=0.25로 줄여야 expectation이 target과 맞습니다. q(C)=0이면 C sample이 한 번도 나오지 않고, identity를 유도할 때 q로 곱하고 나누는 단계를 C에서 할 수 없습니다. 추정은 항상 C의 기여를 0으로 두고, sample 수를 늘려도 이것은 바뀌지 않습니다. → §3
2. 맞는 부분은 Z의 정확한 값이 필요 없다는 것입니다. wˉ(i)가 Z와 무관하고, 최종 식에는 p~/q의 점 값만 들어갑니다. 부정확한 부분은 적분을 피했다는 뉘앙스입니다. Estimator는 같은 sample로 Z^=N1∑jw~(j)를 만들어 Z 자리에 쓰므로, 적분은 Monte Carlo로 추정되고 있습니다. 대가는 finite N에서의 bias이고, N→∞에서는 참값에 수렴합니다. → §4
3. Proposal을 target 안의 mixture p^(xt∣y1:t−1)와 같게 골랐기 때문에 weight p~/q에서 분자와 분모의 p^가 약분됩니다. Prior 정보는 particle을 그 mixture에서 뽑을 때 위치로 이미 들어갔습니다. 여기에 prior를 또 곱하면 weighted set은 p(yt∣xt)p^2에 비례하는 distribution을 나타내고, 복도 예에서는 정확한 0.941 대신 0.980이 나왔습니다. → §6
4. Weighted set을 p^(xt)=∑iwˉt(i)δ(xt−xt(i))로 쓰면 sifting property로 ∫xtp^(xt)dxt=∑iwˉt(i)xt(i)입니다. 이 값은 f(x)=x에 대한 self-normalized estimator이고, target이 posterior이므로 E[Xt∣y1:t]를 근사합니다. p^가 posterior와 가깝다는 말은 함수 값이 아니라 이런 expectation이 가깝다는 뜻입니다. → §5