두 random variable이 함께 있을 때, joint distribution에서 한 variable만의 distribution과 조건이 걸린 distribution을 어떻게 꺼내는지 다룹니다. L4의 Bayes filter 유도는 이 강의의 세 연산(marginalization, conditioning, product rule)에 L3의 두 가정을 더해서 이루어집니다.
Bayes filter는 두 종류의 양을 동시에 다룹니다. 직접 볼 수 없는 state와, 센서가 주는 measurement입니다. 둘 다 불확실하므로 각각을 random variable로 두고, 둘 사이의 관계를 확률로 적습니다.
두 random variable을 함께 다룰 때 필요한 질문은 세 가지입니다.
둘이 동시에 특정 값을 가질 확률은 얼마인가. 이것이 joint distribution p(x,y)입니다.
한쪽은 신경 쓰지 않을 때 다른 쪽의 확률은 얼마인가. 이것이 marginal distribution p(x)이고, 구하는 연산이 marginalization p(x)=∑yp(x,y)입니다.
한쪽 값을 이미 알 때 다른 쪽의 확률은 얼마인가. 이것이 conditional probability p(x∣y)=p(x,y)/p(y)입니다.
이 강의에서는 한 가지 예를 끝까지 씁니다. 로봇이 지나가는 지형 X와 통과 결과 Y입니다.
X∈{flat,rough},Y∈{success,fail}
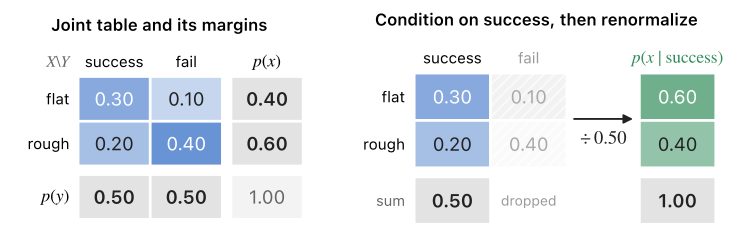
로봇을 여러 번 주행시켰더니 네 경우의 비율이 아래와 같았다고 두겠습니다. 숫자는 설명을 위해 정한 값입니다. 행이 X, 열이 Y입니다.
X / Y
success
fail
flat
0.30
0.10
rough
0.20
0.40
이 강의는 discrete case(§2–§6)를 먼저 끝내고, 같은 연산을 continuous case(§7–§8)로 옮긴 다음, 식을 읽는 습관(§9)으로 정리합니다.
2. Random variable과 PMF
확률 실험에서 일어날 수 있는 결과를 모두 모은 집합을 sample space라고 하고 Ω로 씁니다. 동전을 한 번 던지는 실험이라면 Ω={H,T}입니다.
Random variable은 sample space의 각 결과에 값 하나를 대응시키는 함수입니다. 동전 예에서 앞면에 1, 뒷면에 0을 주면
X(H)=1,X(T)=0
이고, X는 {0,1} 중 한 값을 갖는 random variable입니다. 이름은 variable이지만 실제로는 함수입니다. 그래서 "X=1"은 X가 1을 주는 결과가 일어났다는 사건 {ω∈Ω:X(ω)=1}을 뜻합니다.
지형 예에서 X의 값은 flat, rough라는 이름입니다. 엄밀한 정의에서 random variable은 실수 값을 주므로, flat을 0, rough를 1로 번호 붙였다고 생각하면 됩니다.
Notation은 대문자와 소문자를 구분합니다.
X (대문자): random variable 자체
x (소문자): X가 가질 수 있는 특정 값 하나
P(X=x)는 "X가 값 x를 가질 확률"이라고 읽습니다. Discrete random variable에서 이 확률을 x의 함수로 본 것이 PMF (probability mass function)입니다.
pX(x)=P(X=x),pX(x)≥0,x∑pX(x)=1
논문에서는 아래첨자를 떼고 p(x)라고 씁니다. 이때 p(x)와 p(y)는 같은 함수에 다른 값을 넣은 것이 아니라, 괄호 안의 문자로 구분되는 서로 다른 함수 pX와 pY입니다. p(rough)처럼 값을 직접 넣으면 어느 variable인지는 문맥으로 판단하고, 헷갈릴 때는 P(X=rough)로 씁니다.
같은 p(x)가 discrete variable이면 PMF를, continuous variable이면 PDF를 뜻한다는 점도 논문 표기의 관례입니다. PDF는 §7에서 다룹니다.
3. Joint distribution
§1의 표에 있는 숫자 하나하나는 두 사건이 동시에 일어날 확률입니다. 예를 들어 오른쪽 아래 칸은
P(X=rough,Y=fail)=0.40
입니다. 지형이 rough이고 동시에 통과에 실패할 확률이 0.40이라는 뜻입니다.
두 discrete random variable의 joint distribution은 일반적으로 이렇게 씁니다.
p(x,y)=pX,Y(x,y)=P(X=x,Y=y)
p(x,y)는 "p of x comma y"라고 읽습니다. 쉼표는 두 사건이 모두 일어난다는 뜻이고, 사건으로는 교집합 {X=x}∩{Y=y}입니다.
표의 네 칸을 모두 더하면 1입니다. 네 경우는 서로 겹치지 않고, 한 번의 주행에서 반드시 이 중 하나가 일어나기 때문입니다.
0.30+0.10+0.20+0.40=1,x∑y∑p(x,y)=1
Joint distribution은 X와 Y로 표현되는 모든 사건의 확률을 정합니다. X만의 확률, Y만의 확률, 한쪽을 알 때 다른 쪽의 확률이 모두 이 표에서 계산됩니다. §4와 §5가 그 계산 방법입니다.
4. Marginalization
결과가 success인지 fail인지는 상관하지 않고, 지형이 rough일 확률은 얼마입니까?
rough가 일어나는 경우는 (rough, success)와 (rough, fail) 두 가지입니다. 사건으로 쓰면 다음과 같습니다.
{X=rough}={X=rough,Y=success}∪{X=rough,Y=fail}
한 번의 주행이 success이면서 fail일 수는 없으므로, 오른쪽의 두 사건은 서로 겹치지 않습니다. 겹치지 않는 사건 A,B에 대해 P(A∪B)=P(A)+P(B)이므로 두 확률을 더합니다.
같은 논리는 어떤 x에서도 성립합니다. Y는 한 번에 한 값만 가지므로, 사건 {X=x}는 y마다 하나씩인 서로 겹치지 않는 사건 {X=x,Y=y}들로 나뉩니다. 확률은 그 합입니다.
p(x)=y∑p(x,y)
이 연산을 marginalization이라고 합니다. ∑y는 y의 가능한 모든 값에 대해 더해서 결과에서 y를 없앱니다. 이것을 "y를 marginalize out한다"고 말합니다. 왼쪽의 p(x)는 x만의 함수이고, 합 안의 p(x,y)는 x와 y 두 variable의 함수입니다.
X를 없애는 것도 같습니다. p(y)=∑xp(x,y)이고, 예를 들어 p(Y=success)=0.30+0.20=0.50입니다.
왜 marginal이라고 부르는가
표의 가장자리(margin)에 행의 합과 열의 합을 적으면 그것이 곧 p(x)와 p(y)입니다.
X / Y
success
fail
행의 합 p(x)
flat
0.30
0.10
0.40
rough
0.20
0.40
0.60
열의 합 p(y)
0.50
0.50
1
그래서 joint에서 한 variable을 합으로 없애 얻은 distribution을 marginal distribution이라고 부릅니다.
반대 방향은 성립하지 않습니다. Marginal 두 개만으로는 joint를 복원할 수 없습니다. 네 칸이 flat/success 0.20, flat/fail 0.20, rough/success 0.30, rough/fail 0.30인 표도 margin이 똑같이 0.40, 0.60, 0.50, 0.50입니다. Joint를 되살리려면 두 variable이 어떻게 엮여 있는지에 대한 정보가 더 필요하고, §6에서 보듯 conditional p(x∣y)와 그 조건 variable의 marginal p(y)가 있으면 joint가 정해집니다.
Marginal 두 개만으로 joint가 정해지는 경우가 하나 있습니다. 모든 x,y에 대해 p(x,y)=p(x)p(y)이면 X와 Y가 independent하다고 합니다. 방금 만든 두 번째 표는 네 칸이 모두 margin의 곱이므로(0.40×0.50=0.20, 0.60×0.50=0.30) independent한 경우입니다. 원래 표는 p(rough,success)=0.20이고 p(rough)p(success)=0.30이므로 independent하지 않습니다.
L3에서 쓰는 conditional independence는 이 정의의 모든 항에 조건을 붙인 것입니다 (L3 §4).
5. Conditional probability
이번에는 로봇이 성공했다는 사실을 이미 알고 있습니다. 이때 지형이 rough였을 확률은 얼마입니까?
P(X=rough∣Y=success)
세로선 ∣은 "given"이라고 읽습니다. 위 식은 "probability of X=rough given Y=success", 즉 success가 주어졌을 때 rough일 확률입니다.
계산은 두 단계입니다.
세계를 줄입니다. success라는 것을 알았으므로 fail 열의 경우는 더 이상 가능하지 않습니다. 남는 것은 (flat, success)의 0.30과 (rough, success)의 0.20입니다.
합이 다시 1이 되도록 나눕니다. 남은 두 칸의 합은 0.50입니다. 이제 줄어든 세계가 일어날 수 있는 전부이므로, 그 안의 확률은 합이 1이어야 합니다. 그래서 0.50으로 나눕니다.
세로선 뒤의 y는 고정된 조건이고, 합이 1이 되는 것은 세로선 앞의 x에 대해서입니다. 반대로 x를 고정하고 y를 바꾸면 합이 1일 이유가 없습니다. 이 예에서 p(rough∣fail)=0.40/0.50=0.80이므로 p(rough∣success)+p(rough∣fail)=0.40+0.80=1.20입니다. 이 차이는 L2에서 likelihood를 읽을 때 다시 나옵니다 (L2 §2).
숫자의 의미도 봅니다. 아무것도 모를 때 rough의 확률은 0.60이었고, success를 안 뒤에는 0.40입니다. 새로 알게 된 사실로 확률을 바꾸는 연산이 conditioning이고, Bayes filter의 update step은 새 measurement에 대한 conditioning입니다.
확률이 바뀌지 않는 경우가 §4의 independence입니다. p(x,y)=p(x)p(y)의 양변을 p(y)>0으로 나누면 p(x∣y)=p(x)이고, p(y)=0인 y에서는 p(x,y)≤p(y)=0이므로 원래 식이 저절로 성립합니다. 그래서 independence는 p(y)>0인 모든 y에서 p(x∣y)=p(x)라는 것과 같습니다. 이 표에서는 p(rough∣success)=0.40이 p(rough)=0.60과 다르므로 X와 Y는 independent하지 않습니다.
6. Product rule과 law of total probability
Product rule
Conditional probability 정의의 양변에 p(y)를 곱합니다.
p(x∣y)=p(y)p(x,y)⟹p(x,y)=p(x∣y)p(y)
x와 y의 역할을 바꾸면 p(y∣x)=p(x,y)/p(x)이고, 양변에 p(x)를 곱하면 다른 방향의 분해가 나옵니다. 둘을 합친 것이 product rule입니다.
p(x,y)=p(x∣y)p(y)=p(y∣x)p(x)
Joint는 conditional × marginal로 쪼갤 수 있고, 어느 variable을 조건으로 둘지는 고를 수 있습니다. 같은 joint를 두 방향으로 쪼갠 이 등식이 L2에서 Bayes theorem의 출발점입니다 (L2 §1). 각 분해는 조건 variable의 확률이 양수일 때 씁니다. p(x∣y)p(y)는 p(y)>0에서, p(y∣x)p(x)는 p(x)>0에서 씁니다.
숫자로 두 방향을 모두 확인합니다. p(success∣rough)=0.20/0.60=1/3입니다.
읽는 법은 이렇습니다. y의 경우마다 나누고, 각 경우에서 x가 일어날 확률 p(x∣y)에 그 경우 자체의 확률 p(y)를 곱해 모두 더합니다. 즉 p(y)를 weight로 한 conditional들의 weighted average입니다.
이 형태가 쓸모 있는 이유는, 실제 문제에서는 joint table이 통째로 주어지는 일이 드물고 conditional과 marginal이 각각 따로 모델로 주어지기 때문입니다. Bayes filter에서는 "이전 state가 주어졌을 때 지금 state의 distribution"(transition model)과 "이전 state에 대한 belief"가 따로 있고, 지금 state의 distribution을 이 식과 같은 모양으로 계산합니다. 유도는 L4에서 합니다 (L4 §2).
Law of total probability는 두 연산의 조합입니다
Marginalization으로 모르는 variable을 합으로 없애고, 합 안의 joint를 product rule로 conditional × marginal로 쪼갠 결과입니다. L4의 prediction step은 같은 두 단계를 모든 항에 조건 y1:t−1이 붙은 채로 쓰고, 여기에 L3의 Markov assumption을 더한 것입니다.
7. Continuous variable과 density
로봇의 위치 X∈R처럼 연속적인 값을 갖는 random variable을 생각합니다. 이런 variable은 PMF 대신 probability density function (PDF) fX로 기술합니다.
P(a≤X≤b)=∫abfX(x)dx,fX(x)≥0,∫−∞∞fX(x)dx=1
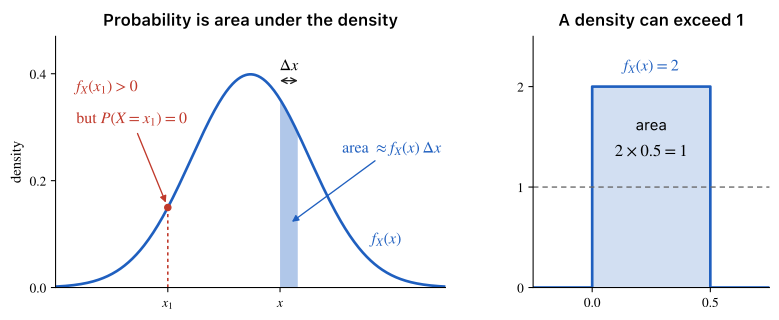
Continuous variable에서 확률은 density 곡선 아래의 넓이이고, density 값 자체는 확률이 아닙니다.
아주 좁은 구간 [x,x+Δx]에서는, fX가 x 근처에서 continuous하다면 거의 일정하므로 넓이를 직사각형으로 근사할 수 있습니다.
P(x≤X≤x+Δx)≈fX(x)Δx
그래서 fX(x)는 x 근처에서 단위 길이당 확률, 즉 확률이 얼마나 빽빽하게 모여 있는지를 나타냅니다. x의 단위가 m이면 fX의 단위는 1/m입니다.
숫자로 보겠습니다. Standard normal density fX(x)=2π1e−x2/2에서 fX(0.5)≈0.3521입니다.
Δx=0.1: 근사 fX(0.5)Δx≈0.0352, 실제 넓이 P(0.5≤X≤0.6)≈0.0343
Δx=0.01: 근사 ≈0.00352, 실제 넓이 ≈0.00351
구간이 좁을수록 근사가 정확해집니다.
한 점의 확률은 0이다
구간 폭을 0으로 줄이면 한 점의 확률이 나옵니다. 점 x는 모든 Δ>0에 대해 구간 [x,x+Δ] 안에 들어 있으므로 다음이 성립합니다.
0≤P(X=x)≤P(x≤X≤x+Δ)=∫xx+ΔfX(u)duΔ→00
따라서 density를 갖는 X에서는 P(X=x)=0입니다.
한 점의 확률이 0인 이유
이유는 X가 density를 갖는다는 것이고, 값이 무한히 많다는 것은 이유가 아닙니다. Poisson random variable은 0,1,2,…로 값이 무한히 많지만 각 값이 양의 확률을 갖습니다. 실수 값을 갖는 variable이라도 확률 일부가 한 점에 몰려 있으면 그 점의 확률은 0이 아닙니다. 예를 들어 range sensor가 최대 거리 rmax를 넘는 거리를 모두 rmax로 출력하고, 실제 거리가 rmax 이상인 경우가 양의 확률로 일어나면 P(Y=rmax)>0입니다.
또 P(X=x)=0은 "x는 일어날 수 없다"는 뜻이 아닙니다. 실제로 관측되는 값 하나하나도 확률 0인 점입니다.
Density 값은 1보다 클 수 있다
fX는 확률이 아니므로 1 이하일 필요가 없습니다. 제약은 전체 넓이가 1이라는 것뿐입니다. [0,0.5] 위의 uniform distribution은 그 구간에서 fX(x)=2이고, 넓이는 2×0.5=1입니다.
좁은 구간에 확률이 몰릴수록 density 값은 커집니다. 정확한 센서의 likelihood가 1을 넘는 값으로 나오는 것도 같은 이유이고, L6의 숫자 예에서 실제로 나옵니다 (L6 §7).
왼쪽: 폭 Δx인 띠의 넓이가 fX(x)Δx로 근사되는 확률이고, 점 x1에서는 density가 양수여도 확률은 0입니다. 오른쪽: [0,0.5] 위의 uniform density는 높이가 2이지만 넓이는 1입니다.
PMF와 PDF 비교
Discrete (PMF)
Continuous (PDF)
값의 의미
pX(x)=P(X=x), 확률
fX(x), 단위 길이당 확률
한 점의 확률
pX(x)
0
값의 범위
0≤pX(x)≤1
fX(x)≥0, 1을 넘을 수 있음
정규화
∑xpX(x)=1
∫fX(x)dx=1
집합 A의 확률
∑x∈ApX(x)
∫AfX(x)dx
논문은 두 경우를 구분하지 않고 모두 p(x)라고 씁니다. 뒤 강의에서 continuous variable에 대한 p(⋅)는 density이고, discrete variable에 대한 p(⋅)는 PMF입니다. p(a∣b)가 PMF인지 density인지는 세로선 앞의 a가 discrete인지 continuous인지로 정해지고, 조건 b가 continuous여도 a가 discrete이면 PMF입니다. 식에 p가 나오면 그 variable이 discrete인지 continuous인지 먼저 확인하고, 합과 적분 중 어느 쪽을 쓸지 정합니다.
8. Continuous marginal과 conditional
Joint density
두 continuous variable X,Y의 joint density fX,Y(x,y)는 작은 직사각형에 들어갈 확률을 줍니다.
P(x≤X≤x+Δx,y≤Y≤y+Δy)≈fX,Y(x,y)ΔxΔy
영역 A에 들어갈 확률은 ∬AfX,Y(x,y)dxdy입니다. 1차원에서 넓이였던 확률이 2차원에서는 곡면 아래의 부피가 됩니다.
Marginal density
Discrete에서는 p(x)=∑yp(x,y)였습니다. Continuous Y에는 하나씩 더할 개별 값이 없으므로, y축을 폭 Δy인 bin으로 잘라 discrete 문제로 바꾼 다음 극한을 취합니다. bin의 대표점을 y1,y2,…라고 하겠습니다.
X가 [x,x+Δx]에 있다는 사건은, Y가 어느 bin에 있는지에 따라 서로 겹치지 않는 사건들로 나뉩니다. 그래서 §4와 같은 논리로 bin마다의 확률을 더합니다.
논문 표기로는 p(x)=∫p(x,y)dy입니다. 여기서 dy가 없애는 variable은 y입니다.
Discrete의 ∑y가 continuous에서 ∫dy로 바뀌었을 뿐, y의 모든 경우를 모아 y를 없앤다는 연산은 같습니다. Signals & Systems에서 ∑kg(kΔ)Δ가 Δ→0에서 ∫g(τ)dτ가 되는 것과 같은 극한입니다.
Conditional density
Discrete와 같은 비율이 density에서도 성립합니다.
fX∣Y(x∣y)=fY(y)fX,Y(x,y),fY(y)>0
그런데 continuous Y에서 사건 Y=y는 확률이 0이라 §5의 정의에 바로 넣을 수 없습니다. 대신 Y가 y 근처의 작은 구간에 있다는 확률이 양수인 사건으로 조건을 겁니다.
P(x≤X≤x+Δx∣y≤Y≤y+Δy)=P(y≤Y≤y+Δy)P(x≤X≤x+Δx,y≤Y≤y+Δy)≈fY(y)ΔyfX,Y(x,y)ΔxΔy=fY(y)fX,Y(x,y)Δx(conditional probability)(small rectangle, small interval)
Δy가 약분되고, 남은 식은 "density × Δx" 모양입니다. §7에서 density를 읽은 방식 그대로, Δx 앞의 계수 fX,Y(x,y)/fY(y)가 X의 conditional density입니다.
엄밀하게는 확률이 0인 사건 위의 conditioning을 정의하려면 measure theory가 필요합니다. Bayes filter와 particle filter를 이해하고 쓰는 데에는 위의 density 관계로 충분하므로, 이 시리즈에서는 다루지 않습니다.
Continuous product rule과 law of total probability
Conditional density의 정의에서 product rule p(x,y)=p(x∣y)p(y)가 discrete와 똑같이 나옵니다. Law of total probability도 합을 적분으로 바꾼 같은 두 단계입니다. 두 줄 모두 dy가 y를 없앱니다.
한 variable은 discrete이고 다른 variable은 continuous인 경우에도 같은 식을 쓰고, discrete 쪽은 합, continuous 쪽은 적분으로 처리합니다. 예를 들어 state는 discrete한 칸이고 measurement는 continuous한 거리값이면, p(y)=∑xp(y∣x)p(x)에서 p(x)는 PMF, p(y∣x)와 p(y)는 y에 대한 density이고, 합은 x에 대해서만 합니다. 이 경우 Bayes theorem에서 달라지는 점은 L2 §3에서 봅니다.
Discrete와 continuous 비교
연산
Discrete
Continuous
Marginalization
p(x)=∑yp(x,y)
p(x)=∫p(x,y)dy
Conditional
p(x∣y)=p(x,y)/p(y)
같은 식, 모든 p가 density
Product rule
p(x,y)=p(x∣y)p(y)
같은 식, 모든 p가 density
Law of total probability
p(x)=∑yp(x∣y)p(y)
p(x)=∫p(x∣y)p(y)dy
Conditional의 정규화
∑xp(x∣y)=1
∫p(x∣y)dx=1
9. 확률식을 읽는 세 가지 습관
새 확률식을 보면 공식 이름을 떠올리기 전에 아래 세 가지를 먼저 확인합니다.
합이나 적분은 어떤 variable을 없애는가
p(x)=∫p(x,z)dz를 보면, 적분 안의 p(x,z)는 x와 z 두 variable의 함수입니다. dz가 붙어 있으므로 적분은 z의 가능한 모든 값을 모읍니다. 결과에는 z가 남지 않고 x만 남습니다. 즉 z를 marginalize out했습니다.
L4에서는 아래 모양의 식이 나옵니다. xt−1은 시각 t−1의 state이고, y1:t−1은 시각 1부터 t−1까지의 measurement 전부입니다. 이 notation은 L3에서 자세히 다룹니다 (L3 §2).
∫p(xt∣xt−1)p(xt−1∣y1:t−1)dxt−1
지금은 dxt−1이 붙어 있으니 이 적분이 이전 state xt−1을 없애고, 결과는 xt와 조건 y1:t−1에만 의존한다는 것까지 읽을 수 있으면 됩니다. 적분을 보면 d 뒤에 붙은 variable이 무엇인지부터 확인합니다.
세로선 뒤에는 무엇이 있는가
p(x∣y)에서 세로선 뒤의 y는 이미 알고 있는 것, 즉 고정된 조건입니다. 식 전체는 세로선 앞의 variable에 대한 distribution이고, 합이나 적분이 1이 되는 것도 앞의 variable에 대해서입니다. §5에서 x를 고정하고 y를 바꾼 합이 1.20이었던 것이 그 예입니다.
Joint는 conditional × marginal이다
p(x∣y)p(y)처럼 conditional과 그 조건 variable의 marginal이 곱해져 있으면 joint p(x,y)로 읽습니다. 반대로 joint가 보이면 어느 방향으로든 쪼갤 수 있습니다.
위 L4 적분 안의 곱은 겉보기에는 conditional × marginal 모양이지만, y1:t−1이 주어졌을 때의 joint p(xt,xt−1∣y1:t−1)로 읽으려면 L3의 Markov assumption에서 나오는 p(xt∣xt−1,y1:t−1)=p(xt∣xt−1)이 필요합니다. 조건이 붙은 product rule p(a,b∣c)=p(a∣b,c)p(b∣c)로 이 joint를 쪼개면 첫째 인자는 p(xt∣xt−1,y1:t−1)인데, 적분 안의 첫째 인자에는 조건 y1:t−1이 빠져 있기 때문입니다. 그 단계는 L4에서 한 줄씩 유도합니다.
이해 확인
1. 아래 joint PMF에서 p(X=1)을 구하시오. 또 0.3과 0.4를 곱하거나 평균내지 않고 더하는 이유를 설명하시오.
Y=0
Y=1
X=0
0.1
0.2
X=1
0.3
0.4
2. 같은 표에서 p(X=1∣Y=1)을 구하시오. 또 p(Y=1)로 나누는 이유와, 나누지 않으면 무엇이 깨지는지 설명하시오.
3.p(x)=∫p(x,z)dz에서 적분 안의 distribution이 갖는 variable은 무엇이고, dz가 없애는 것은 무엇인가? 결과가 p(x∣z)가 아니라 p(x)인 이유를 설명하시오.
4.[0,0.5] 위의 uniform density는 그 구간의 모든 점에서 값이 2이다. 확률은 1을 넘을 수 없는데도 이것이 모순이 아닌 이유와, P(X=0.25)=0인 이유를 설명하시오.
답
1.p(X=1)=0.3+0.4=0.7입니다. 사건 {X=1}은 {X=1,Y=0}과 {X=1,Y=1}로 나뉘고, Y는 한 번에 한 값만 가지므로 두 사건은 겹치지 않습니다. 겹치지 않는 사건의 확률은 더하는 것이 확률의 기본 성질이고, 이렇게 Y를 marginalize out합니다. 곱 0.3×0.4=0.12는 두 칸의 사건이 동시에 일어날 확률처럼 계산한 것인데, 두 사건은 겹치지 않으므로 동시에 일어날 수 없습니다. 평균을 내면 p(X=0)=0.15, p(X=1)=0.35가 되어 합이 0.5이므로 PMF의 정규화가 깨집니다. → §4
2.p(Y=1)=0.2+0.4=0.6이므로 p(X=1∣Y=1)=0.4/0.6≈0.667입니다. Y=1을 알았으므로 Y=1 열만 가능한 세계로 남습니다. 나누지 않으면 0.2+0.4=0.6=1이라 x에 대한 distribution이 되지 않습니다. 0.6으로 나누면 줄어든 세계 안에서 합이 1이 됩니다. → §5
3. 적분 안의 p(x,z)는 x와 z의 함수입니다. dz가 붙은 적분은 z의 모든 값을 모으므로 결과에는 z가 남지 않고, 그것이 x의 marginal p(x)입니다. p(x∣z)는 이와 다른 연산인 conditioning, 즉 z를 한 값으로 고정하고 p(z)로 나누는 연산에서 나옵니다. → §8, §9
4. Density 값은 확률이 아니라 단위 길이당 확률입니다. 확률은 넓이이고, 전체 넓이는 2×0.5=1이므로 모순이 없습니다. 한 점의 확률은 그 점을 포함하는 구간의 확률(넓이)보다 클 수 없고, 구간 폭을 0으로 줄이면 그 넓이가 0으로 가므로 P(X=0.25)=0입니다. 이유는 X가 density를 갖는다는 것입니다. → §7