L1과 L2에서는 random variable 두 개, X와 Y만 봤습니다. 로봇 위치 X 하나와 센서 값 Y 하나를 놓고 Bayes theorem으로 p(x∣y)를 계산했습니다.
실제 로봇은 움직입니다. 위치가 시간에 따라 바뀌므로 random variable 하나로는 부족하고, 시각마다 하나씩 필요합니다.
X0,X1,X2,…
Xt는 시각 t에서의 위치입니다. 센서도 시각마다 새 값을 줍니다.
Y1,Y2,Y3,…
Hidden state와 measurement
앞으로 random variable은 두 종류로 나뉩니다.
Hidden stateXt는 시각 t에서 우리가 알고 싶지만 직접 관측하지 못하는 양입니다. latent state라고도 합니다. 예를 들어 로봇의 위치와 velocity, 지면 상태, 추적하는 물체의 위치가 여기에 해당합니다.
MeasurementYt는 시각 t에 센서가 실제로 내놓는 값입니다. observation이라고도 합니다. camera image, lidar distance, IMU reading, encoder count, GPS fix가 예입니다.
Measurement는 state 자체가 아닙니다. 센서는 state에 noise가 섞인 값이나 state의 일부만을 보여 주므로, state는 measurement들로부터 추론해야 합니다. 이 추론을 확률 계산으로 하는 것이 이 시리즈의 Bayes filter입니다.
대문자 Xt는 random variable이고 소문자 xt는 그것이 취하는 값입니다(L1 §2). 논문에서는 이 구분을 느슨하게 쓰는 경우가 많습니다.
시간 index 규칙
이 시리즈는 다음 규칙을 씁니다.
State는 t=0부터 있습니다. x0에 대해서는 measurement가 없고, 초기 belief p(x0)만 있습니다.
Measurement는 t=1부터 들어옵니다. y1은 x1에 대한 첫 measurement입니다.
p(x0)를 어떻게 정하는지는 L2 §6에서 봤습니다. 이 강의는 t가 커질 때 p(xt∣y1,…,yt)를 계산하는 데 필요한 모델과 가정을 정리합니다.
2. 시퀀스 notation 읽기
Bayes filter 식에는 colon이 들어간 아래첨자가 계속 나옵니다.
x0:t=(x0,x1,…,xt),y1:t=(y1,y2,…,yt)
x0:t는 "x0부터 xt까지"라고 읽습니다. 예를 들어 y1:3=(y1,y2,y3)입니다. colon은 "처음부터 여기까지의 sequence 전체"를 뜻합니다. p(x0:t)는 이 sequence 전체의 joint distribution입니다.
t=1이면 y1:0은 빈 sequence입니다. 그래서 p(x1∣y1:0)은 조건이 없는 p(x1)과 같습니다. 이 규칙 덕분에 첫 step을 따로 적지 않아도 됩니다.
두 belief 읽기
이제 filter의 중심에 있는 두 식을 읽습니다.
p(xt∣y1:t−1)
이 식은 "y1부터 yt−1까지 주어졌을 때 xt의 distribution"이라고 읽습니다. 시각 t의 measurement yt는 아직 보지 않았습니다. 지금까지의 센서 정보로 현재 state를 예측한 belief이므로 predicted belief라고 부르고 belt(xt)로 씁니다.
p(xt∣y1:t)
이 식은 "y1부터 yt까지 주어졌을 때 xt의 distribution"입니다. 이번에는 yt까지 반영했습니다. 이것을 filtering belief라고 부르고 belt(xt)로 씁니다.
두 식의 차이는 bar 뒤에 yt가 있느냐 하나뿐이고, 그 차이를 메우는 계산이 Bayes theorem을 쓰는 update입니다. 그 update에서 belt가 prior 자리에, belt가 posterior 자리에 들어갑니다. 유도는 L4 §4에서 합니다.
읽기 연습
p(x4∣y1:3)을 읽어 봅니다.
Bar 앞의 x4는 distribution을 묻는 대상, 곧 시각 4의 state입니다.
Bar 뒤의 y1:3=(y1,y2,y3)은 이미 본 measurement입니다.
y4는 bar 뒤에 없으므로 아직 보지 않았습니다.
그래서 이 식은 시각 4의 predicted belief bel4(x4)입니다.
식
읽는 법
yt 반영
이름
p(xt∣y1:t−1)
yt−1까지 보고, yt를 보기 전의 xt
아니오
predicted belief belt
p(xt∣y1:t)
yt까지 본 뒤의 xt
예
filtering belief belt
p(x0:t∣y1:t)
yt까지 본 뒤의 state sequence 전체
예
path posterior (L7에서 사용)
3. Transition model과 measurement model
Hidden state model은 initial belief p(x0)와 함께 두 개의 conditional distribution으로 만들어집니다. 하나는 state가 시간에 따라 어떻게 변하는지를, 다른 하나는 state에서 measurement가 어떻게 나오는지를 말합니다.
Transition model
p(xt∣xt−1)
"이전 state가 xt−1일 때 현재 state xt의 distribution"이라고 읽습니다. 이것을 transition model이라고 합니다. dynamics model 또는 motion model이라고도 부릅니다. Bar 뒤의 xt−1은 정확히 안다고 놓은 값이고, 불확실한 것은 bar 앞의 xt뿐입니다.
Discrete: transition matrix
세 칸 {1,2,3} 위의 로봇이 보통 오른쪽으로 한 칸 가지만, 제자리에 머물거나 뒤로 밀리기도 한다고 합시다. 모든 경우를 matrix 하나로 적을 수 있습니다.
행은 이전 state, 열은 현재 state입니다. 첫 행은 "Xt−1=1이면 0.2의 확률로 1에 머물고 0.8의 확률로 2로 간다"는 뜻입니다. 오른쪽 끝인 3에서는 더 갈 곳이 없어서 0.8의 확률로 머뭅니다.
각 행의 합은 1이지만, 각 열의 합은 1일 필요가 없습니다. 행 i는 조건 Xt−1=i를 고정한 뒤 Xt에 대한 distribution이므로 합이 1입니다(L1 §5). 열 j는 서로 다른 조건에서 같은 칸 j로 갈 확률을 모은 것이라 distribution이 아닙니다. 이 matrix의 열 합은 0.3,1.2,1.5입니다.
이 강의에서는 매 step 같은 T를 쓴다고 둡니다. 모델에 따라 transition이 시각이나 제어 입력에 따라 달라질 수도 있습니다.
Continuous: noise가 들어간 운동 방정식
위치가 실수이고, 명령한 이동량 ut만큼 움직이되 noise가 섞인다고 합시다.
xt=xt−1+ut+ϵt,ϵt∼N(0,σ2)
여기서 ϵt는 Xt−1을 포함한 과거의 모든 variable과 independent라고 가정합니다. 그러면 Xt−1=xt−1로 고정했을 때 ϵt의 distribution은 그대로이고, Xt는 상수 xt−1+ut에 그 noise를 더한 값입니다. mean만 옮겨진 Gaussian이 됩니다.
N(xt;μ,σ2)는 "mean μ, variance σ2인 Gaussian density를 xt에서 계산한 값"이라고 읽습니다. 예를 들어 xt−1=3, ut=1, σ=0.2이면 xt는 4를 중심으로 퍼지고, [3.6,4.4] 안에 들어갈 확률은 약 0.954입니다.
ut는 filter가 계산하는 시점에 이미 값을 알고 있으므로 bar 뒤에 조건으로 둡니다. 엄밀하게는 p(xt∣xt−1,ut)로 써야 하지만, 이 시리즈에서는 보통 ut를 생략하고 p(xt∣xt−1)로 씁니다.
이렇게 생략하려면 ut가 y1:t−1과 u1:t−1이 주는 것 이상의 정보를 xt−1에 대해 담지 않아야 합니다. 기호로는 p(xt−1∣y1:t−1,u1:t)=p(xt−1∣y1:t−1,u1:t−1)입니다. ut를 미리 정해 두었거나 과거 measurement와 belief만으로 계산하면 이 조건이 성립합니다. 반대로 state에도 영향을 주는 hidden variable이 ut를 정하면 깨집니다.
Measurement model
p(yt∣xt)
"현재 state가 xt일 때 measurement yt의 distribution"이라고 읽습니다. 이것을 measurement model이라고 합니다. observation model 또는 sensor model이라고도 부릅니다.
Discrete: near/far 센서
벽까지의 거리를 "near"와 "far" 두 값으로만 알려 주는 센서를 생각합니다. 벽은 칸 1 쪽에 있습니다.
xt
P(Yt=near∣xt)
P(Yt=far∣xt)
행 합
1
0.9
0.1
1
2
0.5
0.5
1
3
0.1
0.9
1
센서가 완벽하지 않으므로 칸 1에서도 가끔 "far"가 나옵니다. 각 행은 xt를 고정한 뒤 Yt에 대한 distribution이므로 합이 1입니다.
측정값이 들어와 yt=near로 고정되면, near 열을 xt의 함수로 읽습니다. 이것이 likelihood이고, 합은 0.9+0.5+0.1=1.5로 1이 아닙니다(L2 §2). 같은 table을 행 방향으로 읽으면 measurement model이고, 관측된 값의 열 하나를 세로로 읽으면 likelihood입니다.
Continuous: 위치를 noise와 함께 재는 센서
yt=xt+νt,νt∼N(0,σy2)
νt가 xt와 independent이면 transition model과 같은 이유로 다음이 됩니다.
p(yt∣xt)=N(yt;xt,σy2)
σy=0.5이고 xt=5라고 합시다. yt=5.1에서 이 density의 값은 약 0.78이고, yt=20에서는 약 3×10−196입니다. 이 값들은 probability가 아니라 density 값입니다. 측정값이 20으로 들어오면 "xt=5"라는 가설의 likelihood는 이만큼 작아집니다.
두 모델은 누가 정하는가
transition model
measurement model
식
p(xt∣xt−1)
p(yt∣xt)
무엇에 대한 distribution인가
현재 state xt
현재 measurement yt
조건으로 고정한 것
이전 state xt−1 (와 알고 있는 ut)
현재 state xt
보통 어디서 오는가
운동 방정식과 process noise 모델
센서 방정식과 calibration으로 정한 noise 모델
두 모델 모두 엔지니어가 정하는 모델입니다. 실제 시스템과 어긋날 수 있고, 어긋나면 filter가 내는 belief도 틀어질 수 있습니다.
4. Conditional independence
§5의 두 가정은 모두 conditional independence로 적힙니다. 먼저 정의를 보고, 숫자 예로 확인합니다.
정의
C가 주어졌을 때 A와 B가 conditionally independent라는 것은, p(c)>0인 모든 c와 모든 a,b에 대해 다음이 성립한다는 뜻입니다.
p(a,b∣c)=p(a∣c)p(b∣c)
이것을 A⊥B∣C라고 쓰고, "C가 주어지면 A와 B는 independent하다"라고 읽습니다. 성립하지 않으면 A⊥B∣C로 씁니다. 조건이 없는 A⊥B는 보통의 independence입니다.
같은 조건을 다른 형태로 쓸 수도 있습니다. p(b,c)>0인 곳에서 다음과 같습니다.
p(a∣b,c)=p(a∣c)
두 형태가 같다는 것은 product rule을 c를 조건으로 둔 형태에서 바로 보입니다. 먼저 그 형태를 확인합니다.
p(a,b∣c)=p(c)p(a,b,c)=p(c)p(a∣b,c)p(b,c)=p(a∣b,c)p(b∣c)(definition of conditional)(product rule)(definition of conditional)
이 식에서 p(a∣b,c)를 p(a∣c)로 바꾸면 첫 번째 형태가 나옵니다. 반대로 첫 번째 형태가 성립하면 p(a∣c)p(b∣c)=p(a∣b,c)p(b∣c)이고, 양변을 p(b∣c)>0으로 나누면 두 번째 형태가 나옵니다.
두 번째 형태가 뜻을 더 잘 보여 줍니다. C를 이미 알고 있으면, B를 추가로 알아도 A에 대한 belief가 바뀌지 않습니다.
예: 비, 우산, 젖은 땅
R은 비가 오는지(1 또는 0), U는 우산 든 사람이 보이는지, W는 땅이 젖었는지입니다. 모델을 다음과 같이 정합니다.
P(R=1)=0.3
P(U=1∣R=1)=0.8, P(U=1∣R=0)=0.1
P(W=1∣R=1)=0.9, P(W=1∣R=0)=0.2
비가 오는지가 정해지면 우산과 땅은 서로 영향을 주지 않습니다. 곧 U⊥W∣R입니다.
R을 모르는 상태에서 먼저 P(W=1)과 P(U=1)을 law of total probability로 구합니다.
우산을 봤다는 사실이 땅이 젖었을 확률을 0.41에서 약 0.742로 올렸습니다. 따라서 U와 W는 independent가 아닙니다. 우산이 땅을 적시는 것이 아니라, 우산이 비에 대한 정보를 주고 비가 땅을 적시기 때문입니다.
비가 온다는 것을 알고 나면 달라집니다. conditional independence에 의해 P(W=1∣U=1,R=1)=P(W=1∣R=1)=0.9이고, 우산은 더 이상 정보를 주지 않습니다.
A⊥B∣C는 A⊥B를 뜻하지 않습니다. 이 예에서 U⊥W∣R이지만 U⊥W입니다. §6에서 filter의 state와 과거 measurement 사이에 같은 구조가 나옵니다.
반대 방향도 일반적으로 성립하지 않습니다. 동전 두 개를 independent하게 던진 결과를 A,B∈{0,1}로, C=A⊕B(XOR)로 두면 A⊥B입니다. 그런데 C가 주어지면 B가 A를 정확히 정하므로, 예를 들어 P(A=1∣C=0)=0.5이지만 P(A=1∣B=1,C=0)=1이고 A⊥B∣C입니다.
Conditional independence는 데이터에서 저절로 나오는 사실이 아니라, 모델을 만들 때 넣는 가정입니다. 이 예에서도 네 번째 줄에서 그렇게 정했습니다.
5. 두 가정과 joint의 분해
Bayes filter가 hidden state model에 두는 가정은 두 개이고, 둘 다 §4의 conditional independence입니다. 유도의 label에서는 가정 1을 Markov assumption, 가정 2를 measurement CI(conditional independence)로 줄여 쓰고, 뒤 강의의 유도도 같은 label을 씁니다.
가정 1: Markov assumption
p(xt∣x0:t−1,y1:t−1)=p(xt∣xt−1)
"과거 state 전체와 과거 measurement 전체가 주어졌을 때 xt의 distribution은, 바로 이전 state xt−1만 주어졌을 때의 distribution과 같다"고 읽습니다. §4의 기호로는 Xt⊥(X0:t−2,Y1:t−1)∣Xt−1입니다.
이전 state xt−1을 정확히 알면, 그보다 오래된 state와 지금까지의 measurement는 xt에 대해 추가 정보를 주지 않는다는 가정입니다. Probabilistic Robotics는 가정 1과 가정 2를 모두 하나의 complete state assumption에서 끌어내고, 그 가정을 Markov assumption이라고도 부릅니다. 이 시리즈는 유도의 label을 붙이기 위해 둘을 나눠, 가정 1만 Markov assumption이라고 부릅니다. Bayesian Filtering and Smoothing은 bar 뒤에 과거 measurement를 넣은 형태로 Markov property를 적습니다. Bar 뒤에 y1:t−1까지 들어간 이 형태가 L4의 prediction step 유도에 필요한 형태입니다.
묶음 전체에 대한 conditional independence는 그 일부에 대해서도 성립합니다. p(a,b1,b2∣c)=p(a∣c)p(b1,b2∣c)의 양변에서 b2를 marginalize하면 p(a,b1∣c)=p(a∣c)p(b1∣c)가 되기 때문입니다. 그래서 가정 1에서 p(xt∣xt−1,y1:t−1)=p(xt∣xt−1)도 성립합니다.
가정 2: measurement의 conditional independence
p(yt∣x0:t,y1:t−1)=p(yt∣xt)
"x0부터 xt까지의 모든 state와 과거 measurement가 주어졌을 때 yt의 distribution은, 현재 state xt만 주어졌을 때와 같다"고 읽습니다. 기호로는 Yt⊥(X0:t−1,Y1:t−1)∣Xt입니다.
현재 measurement는 현재 state가 주어지면 과거 state와 과거 measurement에 대해 conditionally independent합니다. 그냥 "independent"라고 하면 틀립니다. xt를 모르면 yt와 yt−1은 보통 dependent입니다. 두 measurement가 인접한 두 시각의 state에서 나왔고, 그 두 state가 transition model로 이어져 있기 때문입니다.
센서 noise가 서로 다른 시각끼리 independent하고 process noise와 x0과도 independent하면 이 가정이 성립합니다(조건 전체는 §7). 센서에 천천히 변하는 bias가 있으면 noise가 시간에 따라 correlated이므로 가정 2가 깨집니다. 이런 경우에는 bias를 state에 포함시켜 모델을 다시 잡습니다.
Markov는 state를 어떻게 잡느냐의 성질
Markov assumption은 "과거가 중요하지 않다"는 뜻이 아닙니다. 과거가 미래에 주는 영향이 전부 xt−1을 거쳐 전달되도록 state를 잡았다는 뜻입니다.
일정한 velocity로 움직이는 물체를 생각합니다. State를 위치 st 하나로 잡으면, st−1만으로는 물체가 어느 방향으로 얼마나 빨리 가는지 알 수 없습니다. st−2를 함께 알면 st−1−st−2로 velocity를 추정할 수 있으므로 st−2가 추가 정보를 줍니다. 위치만으로는 Markov가 아닙니다.
State를 xt=[st,s˙t]⊤로 잡고 두 성분에 들어가는 noise가 시각마다 independent하다면, 현재 위치와 velocity만으로 다음 state의 distribution이 정해집니다. 과거 위치들이 주던 정보는 s˙t에 들어 있습니다. 같은 물리 시스템이라도 state를 무엇으로 잡느냐에 따라 Markov assumption이 성립하기도 하고 깨지기도 합니다.
실제 로봇에서는 state가 결과에 영향을 주는 모든 것을 담는 경우가 드물어서, 두 가정은 보통 근사로만 성립합니다. 흔한 원인은 모델에 넣지 않은 환경의 dynamics, transition model과 measurement model 자체의 오차, belief를 grid나 particle로 근사할 때 생기는 오차, 그리고 여러 step의 control을 함께 정하는 hidden variable입니다. State를 늘리면 가정에 가까워지지만 계산량이 커지므로, 일부러 작은 state를 쓰기도 합니다. 모델에 넣지 않은 영향이 시각마다 independent한 noise에 가깝도록 state를 잡으면, filter는 이런 약한 위반에 크게 흔들리지 않는 경우가 많습니다.
RL에서도 같은 성질을 요구합니다. Markov Decision Process (MDP)의 state는 다음 state와 reward의 distribution이 현재 state와 action만으로 정해지도록 잡습니다. 차이는 MDP에서는 agent가 state를 직접 본다는 점이고, 이 시리즈에서는 state가 hidden이라 measurement로 추론해야 한다는 점입니다.
Joint distribution을 가정 하나씩 써서 분해하기
t=2까지의 모든 variable x0,x1,y1,x2,y2의 joint를 봅니다. 도구는 chain rule이고, chain rule은 product rule(L1 §6)을 반복한 것입니다. Variable이 세 개이면 다음과 같습니다.
이 전개는 variable의 순서를 어떻게 잡아도 등식으로 맞습니다. 순서를 시간 순서 x0,x1,y1,x2,y2로 잡으면 각 factor의 bar 뒤에 그보다 앞선 variable만 옵니다. 그래서 바꿔야 하는 factor마다 두 가정 중 하나가 정확히 들어맞습니다.
순서를 x0,x1,x2,y1,y2로 잡으면 p(y1∣x0,x1,x2)라는 factor가 생기는데, 미래 state x2가 bar 뒤에 있어서 두 가정 어느 쪽도 그대로 적용되지 않습니다. 이 모델에서 p(y1∣x0:2)=p(y1∣x1) 자체는 성립하지만, 그것은 위의 factorization을 얻은 뒤에 보일 수 있는 결과이지 가정에서 바로 나오지 않습니다.
일반 t
같은 일을 시각 t에서 한 번 합니다. p(x0:t,y1:t)에서 가장 늦은 yt와 xt를 차례로 떼어 냅니다.
두 가정 아래에서 모든 variable의 joint는 initial belief p(x0), transition model, measurement model 세 가지로 정해집니다. 그래서 hidden state model을 만든다는 것은 이 세 가지를 정하는 일입니다. 반대로 이 곱으로 joint를 정의하면 두 가정이 성립합니다.
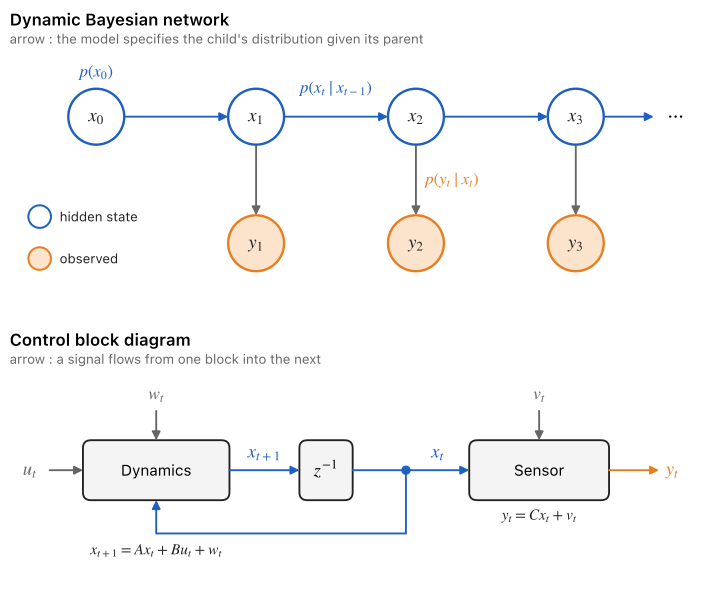
위: 이 hidden state model의 dynamic Bayesian network(DBN)로, 각 node에는 그 node로 화살표를 보내는 node를 조건으로 둔 factor가 하나씩 대응하고 색칠된 measurement node만 관측됩니다. 아래: 같은 모델의 control block diagram이며(z−1은 한 step delay), 두 그림의 화살표 뜻은 §7에서 비교합니다.
State만 쓴 Markov 형태로는 부족합니다
Markov assumption을 p(xt∣x0:t−1)=p(xt∣xt−1)로 적는 경우가 많습니다. 이것은 가정 1에서 y1:t−1을 marginalize해서 나오는 결과이고, 가정 1을 대신할 수는 없습니다.
반례를 봅니다. x0∼N(0,1), x1=x0+w1, y1=x1+v1, x2=y1, y2=x2+v2이고, noise w1,v1,v2는 N(0,1)이며 서로와 x0에 대해 independent라고 합시다. x2=x1+v1이므로 p(x2∣x0:1)=N(x2;x1,1)=p(x2∣x1)이고, state만 쓴 형태와 가정 2는 모두 성립합니다.
그런데 y1을 알면 x2=y1로 정확히 정해지므로 p(x2∣x1,y1)=p(x2∣x1)입니다. 가정 1이 깨졌고, 위의 factorization과 L4의 prediction step 유도도 성립하지 않습니다.
6. 과거 measurement는 왜 여전히 필요한가
가정 1을 보면 질문이 하나 생깁니다. 가정 1은 xt−1이 주어지면 y1:t−1이 xt에 추가 정보를 주지 않는다고 말합니다. 그런데 filter는 p(xt∣y1:t−1)을 계산하면서 과거 measurement를 씁니다. 그렇다면 xt는 과거 measurement에 대해서는 Markov가 아닌 것입니까?
두 식은 bar 뒤에 무엇이 있는지가 다릅니다. 가정 1의 p(xt∣xt−1,y1:t−1)에는 xt−1이 조건으로 들어 있고, filter가 계산하는 p(xt∣y1:t−1)에는 없습니다. 그리고 실제로 우리는 xt−1을 모릅니다.
숫자로 보기
이전 state가 A 또는 B이고, transition model이 다음과 같다고 합시다.
P(Xt=B∣Xt−1=A)=0.2,P(Xt=B∣Xt−1=B)=0.9
xt−1=B를 정확히 안다면, 과거 measurement가 무엇이었든 가정 1에 의해 답이 정해집니다.
P(Xt=B∣Xt−1=B,y1:t−1)=P(Xt=B∣Xt−1=B)=0.9
과거 measurement는 쓸 곳이 없습니다.
xt−1을 모른다면 과거 measurement로 만든 belief만 있습니다. P(Xt−1=A∣y1:t−1)=0.3, P(Xt−1=B∣y1:t−1)=0.7이라고 합시다. 이제는 두 가능성을 모두 따져야 합니다. 합의 a는 모르는 이전 state의 값이고, 이 합이 Xt−1을 없앱니다.
두 번째 줄의 product rule은 §4에서 확인한 형태에서 c 자리에 y1:t−1을 넣은 것입니다. 이 계산의 일반형이 L4의 prediction step입니다(L4 §2).
이제 과거 measurement 기록이 달랐다고 합시다. 다른 기록 y1:t−1′이 A 쪽을 가리켜서 belief가 P(Xt−1=A∣y1:t−1′)=0.9, P(Xt−1=B∣y1:t−1′)=0.1이 되었다면, 같은 계산으로 다음을 얻습니다.
P(Xt=B∣y1:t−1′)=0.2×0.9+0.9×0.1=0.27
Transition model은 그대로인데 과거 measurement만 달라져서 Xt=B일 확률이 0.69에서 0.27로 바뀌었습니다. 그러므로 Xt와 Y1:t−1은 independent가 아닙니다.
두 관계를 함께 적기
Xt⊥Y1:t−1∣Xt−1but in generalXt⊥Y1:t−1
§4의 비, 우산, 젖은 땅과 같은 구조입니다. 우산이 비를 거쳐서만 젖은 땅과 관련되었듯이, 과거 measurement는 이전 state에 대한 정보를 거쳐서만 xt와 관련됩니다. 가정 1은 xt−1을 조건으로 넣으면 과거 measurement가 xt에 추가 정보를 주지 않는다는 것입니다. xt−1을 모르면 과거 measurement는 xt−1에 대한 belief를 바꾸고, 위 계산처럼 그 belief가 transition model을 거쳐 xt의 distribution을 바꿉니다.
이 강의에서 가져갈 한 가지
과거 measurement가 필요한 이유는 dynamics에 memory가 있어서가 아니라 우리가 xt−1을 모르기 때문입니다. 위 계산이 보여 주듯이 p(xt∣y1:t−1)을 구하는 데 필요한 것은 y1:t−1 자체가 아니라 그것으로 만든 belief belt−1(xt−1)=p(xt−1∣y1:t−1)와 transition model입니다. 그래서 filter는 measurement 기록 대신 belief 하나를 들고 갑니다.
7. 제어의 state-space model과의 관계
Control 수업에서 쓴 discrete-time state-space model은 다음과 같습니다.
xt+1=Axt+But,yt=Cxt+Dut
Noise가 없으므로 xt와 ut가 정해지면 xt+1과 yt도 하나로 정해집니다. 현실의 불확실성을 넣으면 보통 다음처럼 씁니다. 여기서는 D=0으로 둡니다.
xt+1=Axt+But+wt,yt=Cxt+vt
wt는 process noise, vt는 measurement noise입니다.
방정식이 두 모델을 정한다
wt의 density를 pw, vt의 density를 pv라고 합시다. xt와 ut를 고정하면 xt+1은 상수 Axt+But에 wt를 더한 값이므로, 아래 조건이 성립할 때 다음과 같습니다.
예를 들어 wt∼N(0,Q)이면 p(xt+1∣xt,ut)=N(xt+1;Axt+But,Q)입니다. State equation과 wt의 distribution이 transition model을, output equation과 vt의 distribution이 measurement model을 정합니다. xt+1=f(xt,ut)+wt처럼 nonlinear이어도 같은 방식으로 p(xt+1∣xt,ut)=pw(xt+1−f(xt,ut))가 됩니다.
이 절은 control 관례대로 xt→xt+1로 적었고, filter 식의 p(xt∣xt−1)은 index를 하나 당긴 같은 모델입니다. 시각 t−1에서 t로 가는 입력을 ut로 부르는 책(Probabilistic Robotics)도 있고 ut−1로 부르는 책도 있습니다.
Noise에 대한 조건
방정식의 모양만으로는 §5의 두 가정이 보장되지 않습니다. Noise가 다음 조건을 만족하면 두 가정이 성립합니다.
wt는 서로 다른 시각끼리 independent합니다. vt도 마찬가지입니다.
w와 v는 서로 independent합니다.
둘 다 초기 state x0과 independent합니다.
정확히는 x0,w0,w1,…,v1,v2,… 전체가 mutually independent라고 둡니다. 두 개씩 짝지어 independent인 것만으로는 일반적으로 부족합니다. 또 output equation에 Dut 항이 있으면 measurement model은 p(yt∣xt,ut)로 써야 합니다.
조건이 깨지면 가정이 어떻게 깨지는지 두 경우를 봅니다.
wt가 시간에 따라 correlated일 때.xt와 xt−1을 함께 알면 wt−1=xt−Axt−1−But−1이 정해지고, 이것이 wt에 대한 정보, 곧 xt+1에 대한 정보가 됩니다. 일반적으로는 xt 혼자서 wt−1이 정해지지 않으므로(예: scalar에서 A=0) xt−1이 추가 정보를 주고, 가정 1이 깨집니다. 반대로 scalar에서 A=0이고 wt=ρwt−1+et(et는 시각마다 independent)이면 xt=But−1+wt−1만으로 wt−1이 정해지므로 가정 1이 성립합니다. 가정 1이 깨지는 경우에는 §5의 velocity 예처럼 noise의 dynamics를 state에 포함시켜 state를 다시 잡으면 Markov 모델로 되돌릴 수 있습니다.
vt와 wt가 correlated일 때.yt가 wt에 대한 정보를 주고, wt는 xt+1을 움직입니다. 그러면 p(xt+1∣xt,yt)=p(xt+1∣xt)가 되어 가정 1이 깨집니다.
이 조건들에 더해 모델이 linear이고 wt, vt, x0이 모두 Gaussian이면 Bayes filter가 closed form으로 계산됩니다. 그것이 Kalman filter이고, 이 시리즈에서는 다루지 않습니다.
DBN의 화살표a→b는 모델에 b의 conditional distribution이 a를 조건으로 들어 있다는 뜻입니다. 화살표가 없는 것도 정보입니다. 예를 들어 y1에서 x2로 가는 화살표가 없다는 것이 가정 1의 일부를 나타냅니다.
Block diagram의 화살표는 signal이 한 block에서 다음 block으로 흐른다는 뜻입니다. Block은 입력 signal을 출력 signal로 바꾸는 연산이고, z−1 block은 signal을 한 step 늦춥니다.
Block diagram은 signal이 어떻게 계산되는지를 그리고, DBN은 어떤 variable의 distribution이 어떤 variable을 조건으로 정해지는지를 그립니다. 그래서 block diagram에서는 noise wt,vt가 입력 signal로 들어오고, DBN에서는 noise가 따로 node로 그려지지 않고 p(xt∣xt−1)과 p(yt∣xt) 안에 들어 있습니다. 알고 있는 입력 ut는 DBN에 화살표를 하나 더 그려 나타낼 수 있습니다. 이 절의 control index로는 ut에서 xt+1로, §3의 filter index로는 ut에서 xt로 가는 화살표입니다.
control state-space model
hidden state model
state xt
hidden state xt
state equation
transition model p(xt+1∣xt,ut)
output equation
measurement model p(yt∣xt)
initial condition x0
initial belief p(x0)
output yt
measurement yt (관측되는 것은 이것뿐)
화살표 = signal flow
화살표 = conditional dependence
Control에서 state는 "현재 state와 이후 입력을 알면 이후 출력이 정해지는 양"이었습니다. 확률 모델에서 state는 "현재 state를 알면 과거가 이후의 distribution에 추가 정보를 주지 않는 양"입니다. 같은 시스템에 state를 고르는 방법이 하나로 정해지지 않는다는 점은 State-Space Realizations & Canonical Forms에서 본 것과 같습니다.
8. Prediction, filtering, smoothing
세 용어는 어느 시각의 state를 어느 시각까지의 measurement로 추정하는지로 구분합니다. 대상 state를 xt, 조건으로 쓰는 measurement를 y1:s라고 하면 p(xt∣y1:s)에서 s와 t의 크기 관계가 이름을 정합니다.
이름
식
조건
뜻
prediction
p(xt∣y1:s)
s<t
마지막 measurement보다 뒤의 state를 추정
filtering
p(xt∣y1:t)
s=t
시각 t까지(포함)의 measurement로 시각 t의 state를 추정
smoothing
p(xt∣y1:s)
s>t
xt보다 뒤의 measurement까지 써서 시각 t의 state를 추정
Filtering은 시각 t의 state를 시각 t까지의 measurement로 추정하는 것입니다. 미래 measurement를 쓰지 않으므로 causal하고, 원칙적으로 매 시각 그 시각까지의 데이터로 계산할 수 있습니다(정확한 계산이 어려운 이유는 L4 §7). Control loop 안에서 지연 없이 매 시각 쓸 수 있는 것은 filtering과 prediction입니다.
§2의 predicted belief p(xt∣y1:t−1)은 s=t−1인 prediction, 곧 한 step 앞의 prediction입니다. Bayes filter는 매 step 이 prediction을 거쳐 filtering belief로 갑니다.
belt−1(xt−1)⟶belt(xt)⟶belt(xt)
Smoothing의 예는 y1:10까지 모두 받은 뒤 x5를 다시 추정하는 p(x5∣y1:10)입니다. Smoothing에는 xt보다 뒤의 measurement가 필요하므로, 그 measurement가 들어올 때까지 기다리거나 기록이 끝난 뒤에만 계산할 수 있습니다. 이 시리즈는 smoothing을 다루지 않습니다(허브).
L4는 위 화살표 두 개, 곧 prediction step과 update step을 이 강의의 두 가정만으로 유도합니다.
이해 확인
1.p(x4∣y1:3)과 p(x4∣y1:4) 중 y4에 대한 Bayes update에서 prior 자리에 들어가는 것은 어느 쪽인지 고르고, 그 이유를 설명하시오.
2. Joint p(x0,x1,y1,x2,y2)를 chain rule로 전개할 때 x0,x1,y1,x2,y2 순서를 쓰는 이유를 설명하시오. 또 x0,x1,x2,y1,y2 순서로 쓰면 무엇이 곤란한지 설명하시오.
3. 가정 1에 따르면 Xt⊥Y1:t−1∣Xt−1이다. 그런데도 filter가 p(xt∣y1:t−1)을 계산하면서 과거 measurement를 쓰는 이유를 설명하시오.
4.xt+1=Axt+But+wt에서 wt가 시간에 따라 correlated이면 깨지는 가정은 무엇인가? 그 가정이 깨지는 이유와 되돌리는 방법을 설명하시오.
답
1.p(x4∣y1:3)입니다. Bar 뒤에 y4가 없으므로 y4를 보기 직전의 belief이고, y4를 반영하는 update의 prior 자리에 들어갑니다. 그 update의 결과가 p(x4∣y1:4)입니다. → §2
2. 시간 순서로 전개하면 각 factor의 bar 뒤에 그 variable보다 앞선 variable만 와서 p(yk∣x0:k,y1:k−1)과 p(xk∣x0:k−1,y1:k−1) 꼴이 되고, 가정 2와 가정 1이 각각 한 factor에 그대로 들어맞습니다. x0,x1,x2,y1,y2 순서에서는 p(y1∣x0,x1,x2)처럼 미래 state를 조건으로 가진 factor가 생기는데, 두 가정은 이 형태를 직접 말하지 않습니다. → §5
3. 가정 1은 xt−1을 정확히 알 때의 이야기입니다. 실제로는 xt−1을 모르고, 과거 measurement는 xt−1에 대한 정보를 줍니다. 그래서 조건 없이는 일반적으로(transition이 xt−1에 따라 달라지는 한) Xt⊥Y1:t−1이고, 과거 measurement로 만든 belief를 transition model로 밀어야 합니다. 예에서 belief가 [0.3,0.7]에서 [0.9,0.1]로 바뀌자 0.69가 0.27로 바뀌었습니다. → §6
4. 보통 가정 1(Markov assumption)이 깨집니다. xt와 xt−1을 함께 알면 wt−1이 정해지고, correlated noise에서는 이것이 wt, 따라서 xt+1에 대한 정보가 됩니다. xt 혼자서 wt−1을 정하지 못하는 경우(예: scalar에서 A=0)에는 xt−1이 추가 정보를 주므로 가정 1이 깨집니다. Noise의 dynamics를 state에 포함시켜 state를 다시 잡으면 Markov 모델로 되돌릴 수 있습니다. → §7